Grok 4.7とは?SpaceXAI最新モデルの性能・API料金・Grok 4.6との違い・使い方【2026年9月】
この記事のポイント
Grok 4.7はSpaceXAI(旧xAI)が2026年9月21日に公開した最新モデル。API単価は入力$2・出力$6とGrok 4.6と同じまま、長時間タスクの性能が大きく向上。4.6との違い、ベンチマーク、xhighで増える実コスト、使い方、安全性を公式モデルカードをもとに解説します。
Grok 4.7は、SpaceXAI(旧xAI)が2026年9月21日に公開した、コーディング・長時間のエージェント作業・ナレッジワーク向けのフロンティアモデルです。 API単価はGrok 4.6と同じ入力$2・出力$6(100万トークンあたり)のままで、Terminal-Bench 4.0のスコアがほぼ倍になるなど、何時間もかかる作業での粘り強さが大きく伸びました。
ただし、単価が同じでも請求額が同じになるとは限りません。最上位の推論レベル(xhigh)ではGrok 4.6より多くのトークンを使うため、1タスクあたりのコストは増えることがあります。また、grok.comやスマホアプリなどの一般向けGrokでは、現時点ではまだ使えません。
この記事でわかること
- Grok 4.7のスペックと、Grok 4.6から何が変わったか
- 公式ベンチマークで他社最上位モデルに勝つ領域と負ける領域
- API料金の仕組み(20万トークンの閾値、Fast版、米国リージョン)と実際にかかるコスト
- API・Cursor・Grok Build・GitHub Copilotでの使い方
- 公式モデルカードに載っている安全性評価の「良くなった点」と「悪くなった点」
こんな方に向けた記事です: Grok 4.6から乗り換えるか迷っている開発者、APIの採用候補を比べている技術選定の担当者、CursorやGitHub CopilotでGrok 4.7を選ぶべきか知りたいエンジニア。
数値の出典は、公式ブログ(x.ai/news/grok-4-7)、公式開発者ドキュメント、全30ページの公式モデルカード(Revision 2026-09-21)、Artificial Analysisなどの第三者計測です。料金や提供チャネルは短い周期で変わるため、契約前には必ず公式ドキュメントで確認してください。
Grokシリーズ全体については Grokとは?機能・料金・使い方を解説、前の世代の詳細は Grok 4.6とは?性能・料金・Grok 4.5との違い で解説しています。
Grok 4.7の要点|スペック早見表

Grok 4.7は「値段はそのまま、長時間の作業に強くなったGrok 4.6の後継」です。
- 単価は据え置き — 入力$2/出力$6(20万トークン未満のプロンプト時)。Grok 4.5から3世代続けて同じ単価です
- 長時間タスクが大きく改善 — Terminal-Bench 4.0は20.3%→約38%、数時間かかる開発タスクを測るSWE-Marathonは31.9%→46.0%。Grok 4.6のいちばんの弱点が埋まりました
- 使える場所は開発者向けだけ — API、Cursor、Grok Build、GitHub Copilot、Officeアドインなど。一般向けのGrokアプリへの追加は「後日予定」です
項目 | 内容 |
|---|---|
正式名称 | Grok 4.7 |
モデルID |
|
開発元 | SpaceXAI(XAI LLCのdba名。旧xAI) |
発表日 | 2026年9月21日(米国時間) |
公式の位置づけ | 「当社史上もっとも高性能なモデル」。コーディング・エンジニアリング・オフィスワークでの能力と自律性を強化 |
コンテキスト | 500,000トークン(Grok 4.6と同じ) |
入出力 | テキスト+画像を入力 → テキストを出力 |
推論レベル | low / medium / high(既定) / xhigh |
使えるツール | Function calling、Web検索、X検索、コード実行 |
API形式 | Responses API / Chat Completions |
リージョン | 標準エンドポイント+米国リージョン( |
知識カットオフ | 公式Docsでは2026年5月。モデルカードでは事前学習データが2026年6月まで、追加学習に8月までのデータも使用 |
オープンウェイト | なし(自社サーバーでの運用は不可) |
知識カットオフは、公式ドキュメントとモデルカードで記載が1か月ずれています。どちらかが誤りというより、「どの学習段階のデータを指しているか」の違いと考えられます。最新の出来事を扱うときは、カットオフに頼らずWeb検索ツールを有効にしておくのが確実です。
開発元の名前にも触れておきます。xAIは2026年にSpaceXと統合され、現在はSpaceXAIとして発表を行っています。モデルカードの脚注には「xAIとSpaceXAIは相互に置き換え可能」と書かれており、ニュースで「xAI」と「SpaceXAI」が混在していても同じ組織を指します。
Grok 4.6との違い|ベースモデルを変え、長時間タスクを鍛えた
Grok 4.6からの変更は「より大きいベースモデル」と「長く・難しいタスクを中心にした強化学習」の2本柱です。 Grok 4.6がベースの規模を据え置いて後訓練だけで伸ばした世代だったのに対し、Grok 4.7は土台そのものから入れ替えています。
公式ブログとモデルカード§1.2に書かれている学習方法の変更点は次のとおりです。
- 新しい、より大きなベースモデル — 公式ブログの記載。パラメータ数は公開されていません
- 追加学習(supplemental training)をGrok 4.6より長く実施 — 推論・高度な技術向けのデータ、高品質なエンジニアリング文書、改良した学習レシピを使用
- Grok 4.6を教師役に使って学習データを作成 — 推論レベル別・エージェントの実行環境別に、STEM/ソフトウェア/ナレッジワークの作業記録を生成
- エージェント強化学習を「数時間かかる課題」中心に — ナレッジワーク、コーディング、カーネル最適化、Web開発、CADの環境で実施
- Grok Botの実行環境をネイティブに理解するよう学習 — 会話タスクの質が上がったとされています
公式が改善点として挙げているのは「自分の出力を検証する力」「長いコンテキストの扱い」「複数ステップでの粘り強さ」「文書・プレゼン資料の作成」の4つです。
なお「より大きなベースモデル」という表現は公式ブログにしか出てこず、モデルカードは「追加学習を4.6より長く実施した」と書くにとどまっています。Grok 4.7の発表前に「2.1兆パラメータ」という話がX上で出回りましたが、公式資料で裏づけられた数字ではありません。
Grok 4.6とGrok 4.7の比較表
項目 | Grok 4.6 | Grok 4.7 |
|---|---|---|
発表日 | 2026年8月12日 | 2026年9月21日 |
ベースモデル | Grok 4.5と同じ規模を据え置き | 新しい、より大きなベース(規模は非公開) |
コンテキスト | 500K | 500K(変更なし) |
API単価(20万未満) | $2 / $0.50 / $6 | $2 / $0.50 / $6(変更なし) |
推論レベル | low〜xhigh | low〜xhigh(既定はhigh) |
Terminal-Bench 4.0 | 20.3% | 37.6%〜38.0% |
SWE-Marathon v1.1 | 31.9% | 46.0% |
CursorBench 4.0 | 40.4% | 46.3% |
EEBench(電気設計) | 53.0%(high) | 64.0%〜66.0% |
AA Intelligence Index v4.3.2 | 44 | 46 |
ハルシネーション率(AA-Omniscience) | 34% | 29% |
1タスクの出力トークン(AA計測) | 約36k(high) | 約81k(xhigh) |
Terminal-Bench 4.0とEEBenchは、公式ブログとモデルカードで数値が少し違います。Terminal-Benchはブログが37.6%、モデルカードが38.0%。EEBenchはブログが64.0%、モデルカード(xhigh)が66.0%です。表では両方を併記しています。
過去記事のスコアとは直接比べられない
Grok 4.6の発表時に報じられたスコアと、今回の表の4.6の数値は一致しません。 SpaceXAIは今回、CursorBenchを3.2から4.0に、Terminal-Benchを3.0から4.0に切り替えたためです。モデルカードにも「CursorBench 4.0のスコアは3.2と比較できない」と注記されています。
Artificial AnalysisのIntelligence Indexも同様で、Grok 4.6発表時の「61」は旧バージョンの指標です。現行のv4.3.2ではGrok 4.6が44、Grok 4.7が46で、差は2ポイントです。「61から46に下がった」わけではありません。
Grok 4.5から4.7までの推移
モデル | 公開日 | 入力 / キャッシュ / 出力(1M) | 主な変化 |
|---|---|---|---|
Grok 4.5 | 2026年7月14日 | $2 / $0.30 / $6 | 1.5兆規模のモデルファミリーを投入 |
Grok 4.6 | 2026年8月12日 | $2 / $0.50 / $6 | ベースは据え置き、後訓練を強化。トークン効率が売り |
Grok 4.7 | 2026年9月21日 | $2 / $0.50 / $6 | ベースを刷新、長時間タスクを強化 |
約5週間ごとに0.1刻みで更新されています。このペースが続くなら、1〜2か月後には次のモデルが出てもおかしくありません。アプリ側ではモデルIDを設定ファイルで切り替えられるようにしておくと、世代交代のたびにコードを直さずに済みます。
前の世代については Grok 4.5とは?API料金・性能の実態 を、今後のロードマップは Grok 5とは?公開時期・性能の最新情報 を参照してください。
Grok 4.7の性能|4.6比では全項目改善、他社最上位とは一長一短

出典: Cursor 公式ブログ
Grok 4.7は公式ブログの比較表の全項目でGrok 4.6を上回りましたが、他社の最上位モデルに勝っているのは法務と電気設計だけです。 コーディング、長時間のターミナル作業、医療ではFable 5.1が上にいます。
公式ブログに掲載された比較表は次のとおりです(推論レベルは表記の条件)。
評価 | Grok 4.7(xhigh) | Grok 4.6(high) | GPT-5.6 Sol(Max) | Fable 5.1(Max) |
|---|---|---|---|---|
CursorBench 4.0(コーディング) | 46.3% | 40.4% | 41.7% | 51.8% |
DeepSWE v1.1(ソフトウェア開発) | 71.0%(high) | 65.2% | 72.7% | 70.0% |
EEBench(電気・回路設計) | 64.0% | 53.0% | 39.4% | 56.4% |
AA Briefcase v1.1(オフィス業務、Elo) | 1,657 | 1,546 | 1,487 | 1,678 |
Terminal-Bench 4.0(ターミナル作業) | 37.6% | 20.3% | 37.3% | 57.9% |
Harvey Legal Agent Benchmark(法務) | 19.6% | 15.8% | 2.5% | 6.7% |
HealthBench Professional(医療) | 56.7% | 48.5% | 60.5% | 62.1% |
GPT-5.6 Solに対しては7項目中5項目で上回っていますが、Fable 5.1にはコーディングとターミナル作業で届いていません。特にTerminal-Bench 4.0は20ポイント以上の差があります。
CursorBenchについては、Grok 4.7が匿名化されたCursorのワークフローデータで追加学習されている点を頭に入れておく必要があります。Cursor上の作業に近いデータで鍛えられているため、このベンチマークでは有利に出やすいと考えられます。
モデルカードにしか載っていないデータ
公式ブログの表は7項目だけですが、モデルカードにはさらに多くの評価が載っています。導入判断に役立つものを抜き出しました。
評価 | Grok 4.7 | 比較対象 | 読み取れること |
|---|---|---|---|
SWE-Marathon v1.1(数時間級の開発タスク) | 46.0%(high) | Claude Opus 5:50.0%/Fable 5:45.0%/GPT-5.6 Sol:42.5%/Grok 4.6:31.9% | 4.6比+14.1ポイント。4.6最大の弱点が解消され2位に |
FrontierSWE V2(最大20時間の超長期タスク) | 29.0%(xhigh) | Fable 5.1:56.3%/GPT-5.6 Sol:32.2%/Grok 4.6:25.3% | 丸1日かかる規模ではまだ大差 |
CADGenBench(CAD生成) | 44.4%(1位) | Grok 4.6:40.9%/GPT-5.6 Sol:37.1%/Claude Opus 5:36.6% | CAD生成では首位 |
EEBench(xhigh) | 66.0%(2位) | GPT-6 Astra:69.3%/Claude Opus 5:61.6% | 電気設計は上位 |
LatchBio Capabilities(生物データ解析) | 44.5%(2位) | GPT-6 Astra:47.4% | 研究データ解析でも上位 |
CursorBench 4.0(high) | 43.9% | xhigh:46.3% | 推論レベルでスコアが約2.4ポイント変わる |
このデータから見えるのは、「数時間の開発タスク」までは最上位クラスに追いついたが、「丸1日以上走らせ続ける」タスクではまだFable 5.1と大きな差があるということです。
第三者評価(Artificial Analysis)
独立評価機関Artificial Analysisの計測では、Grok 4.7のIntelligence Index(v4.3.2)は46で、211モデル中21位でした。同機関は「SpaceXAIをトップ4ラボに押し上げた」と評価しています。ほかに次の結果が出ています。
- GDPval-AA(実務タスクのペア比較): Elo 1,695(Grok 4.6 high比+90)
- AA-Omniscience ハルシネーション率: 29%(Grok 4.6は34%)。知らないことをもっともらしく答える割合が下がっています
速度は条件によって大きく変わります。 Artificial Analysisのモデルページでは出力が毎秒77.6トークン、最初のトークンが出るまで約28秒でした。同機関の記事では長いプロンプトで毎秒約188トークンという数字も出ています。xhighで使うと応答が返るまで待つ時間が長くなるため、対話型のアプリで即答が必要な場面には向きません。
数時間級のコーディングで首位のモデルは Claude Opus 5とは?性能・料金・使い方 で解説しています。
API料金|単価は$2 / $6、20万トークンを超えると全体が2倍

出典: SpaceXAI Developer Docs(Models and Pricing)
Grok 4.7のAPI料金はGrok 4.6と完全に同じです。 プロンプトの長さで単価が切り替わる2段階の仕組みになっています。
プロンプト長 | 入力 / 100万トークン | キャッシュ入力 | 出力 / 100万トークン |
|---|---|---|---|
20万トークン未満 | $2.00 | $0.50 | $6.00 |
20万トークン以上 | $4.00 | $1.00 | $12.00 |
公式ドキュメントの注記では、プロンプトが20万トークンに達したリクエストは、そのリクエストの全トークンが高い単価で課金されます。超えた分だけが高くなるのではない点に注意してください。500Kのコンテキストをフルに使う長時間エージェントでは、自動的に$4 / $12の側になります。
円に換算すると、GIGAZINEの換算(1ドル=約157.8円、2026年9月24日の記事時点)で、20万トークン未満なら入力100万トークンあたり約315円、出力が約947円です。為替で変わるため、目安として見てください。
そのほかの料金
項目 | 料金 | 補足 |
|---|---|---|
米国リージョン( | 通常の1.1倍(例: 入力$2.20/出力$6.60) | 推論処理を米国内で完結させたい場合 |
Web検索ツール | $5 / 1,000回 | トークン料金とは別 |
X検索ツール | $5 / 1,000投稿、$10 / 1,000プロフィール | 同上 |
コード実行ツール | $5 / 1,000回 | 同上 |
Grok 4.7 Fast | 標準の2倍(入力$4/キャッシュ$1/出力$12、20万未満) | CursorとGrok Buildのみ。公開APIでは使えない |
Grok 4.7 Fastは、同じモデルを高速なインフラで動かす版で、出力速度は約2倍、料金も2倍です。20万トークン以上のFast単価は、SpaceXAIの料金ページとCursorのドキュメントで表現が揃っておらず、現時点では確認できていません。使う前に、提供元の料金表で確認してください。
他社フロンティアモデルとの単価比較
モデル(公式ブログの表の条件) | 入力 / 1M | 出力 / 1M |
|---|---|---|
Grok 4.7(xhigh) | $2 | $6 |
Grok 4.6(high) | $2 | $6 |
GPT-5.6 Sol(Max) | $4 | $20 |
Fable 5.1(Max) | $10 | $50 |
GPT-5.6 SolとFable 5.1の単価は、SpaceXAIの公式ブログに載っている値です。各社の公式料金ページでの確認はしていないため、比較に使うときは各社の最新料金を確認してください。単価だけ見れば、Grok 4.7はFable 5.1より入力で5分の1、出力で約8分の1です。
単価が同じでも、1タスクのコストは増えうる
ここがGrok 4.7の料金でいちばん見落とされやすい点です。 単価はGrok 4.6と同じでも、xhighで使うと考えるために出すトークンが大きく増えます。
指標(Artificial Analysis計測) | Grok 4.7(xhigh) | 比較 |
|---|---|---|
Intelligence Index 1タスクあたりの出力トークン | 約81k | Grok 4.6(high)約36k/GPT-6 Astra 約27k |
Intelligence Index 1タスクあたりのコスト | $3.74 | GPT-5.6 Sol(Max)$1.99(VentureBeat報道) |
ブレンド単価(キャッシュ:入力:出力=7:2:1) | $1.35 / 1M | — |
出力トークンはGrok 4.6(high)の約2.25倍です。その結果、出力単価が3倍以上高いGPT-5.6 Solより、1タスクあたりでは高くつくという計測結果になっています。VentureBeatも「安いトークンが最安のタスクを意味するとは限らない」と指摘しています。
Grok 4.6は「少ないトークンで結果を出す効率の良さ」が売りでしたが、Grok 4.7のxhighは逆に、トークンを多く使って性能を引き上げる方向です。4.6の感覚のまま予算を組むとずれが出ます。
コストを抑える方法は次のとおりです。
- 推論レベルはまずhigh(既定)で試す — xhighは難しいタスクだけに使う。CursorBenchではhighとxhighの差は約2.4ポイントでした
- プロンプトを20万トークン未満に収める — 超えるとリクエスト全体が2倍になるため、長い資料は要約や分割を検討する
- プロンプトキャッシュを効かせる — 公式ドキュメントは
prompt_cache_keyの設定を強く推奨しています。キャッシュ入力は通常の4分の1です - CursorではFastかどうかを確認する — Pro以上のプランではFastが既定で、料金は標準の2倍です
- 自社のタスクで実測する — 代表的なタスクを5〜10件流し、成功1件あたりのコスト・トークン量・待ち時間をGrok 4.6や他社モデルと比べる
主要な生成AIのAPI料金をまとめて比べたい場合は 生成AIの料金比較 も参考になります。
Grok 4.7はどこで使える?|一般向けアプリはまだ未提供

2026年9月27日時点で、Grok 4.7が使えるのは開発者向けの経路だけです。 モデルカード§1.1には、Web版Grok・スマホアプリ・X上のGrokへの追加は「後日予定」と書かれており、提供開始の公式発表はまだ確認できていません。「SuperGrokに入ればGrok 4.7が使える」という説明は、現時点では正しくありません。
提供先 | 状況 | 補足 |
|---|---|---|
SpaceXAI API | 利用可 | console.x.aiでAPIキーを発行。Chat Completions / Responses API |
Grok Build | 利用可(既定モデル) | SpaceXAIのターミナル型コーディングエージェント。Fastも選べる |
Cursor | 全プランで利用可 | Pro以上はFastが既定。Cursor上の標準は256K、ロングコンテキストで500K |
GitHub Copilot | Pro / Pro+ / Max / Business / Enterprise | 9月21日から段階的に展開。Business/Enterpriseは管理者の有効化が必要 |
Microsoft Officeアドイン | 利用可(既定モデル) | Word / PowerPoint / ExcelのGrokアドイン |
モデルゲートウェイ | 利用可 | OpenRouter、Vercel、Cloudflare、Snowflake、Databricks Mosaicほか |
Oracle OCI Generative AI | 掲載あり | 日本語のドキュメントページあり(詳細は各自で確認) |
grok.com・スマホアプリ・X | 未提供(後日予定) | 提供時期は未発表 |
使う人のタイプ別に整理すると、次のようになります。
あなたの立場 | おすすめの使い方 |
|---|---|
エディタで日常的にコードを書くエンジニア | CursorかGitHub Copilotのモデル選択でGrok 4.7を選ぶ |
ターミナルでエージェントに作業を任せたい | Grok Build(既定でGrok 4.7) |
自社サービスやシステムに組み込みたい | SpaceXAI API、または複数モデルを切り替えやすいOpenRouter等のゲートウェイ |
Word・PowerPointの資料作成に使いたい | OfficeのGrokアドイン |
スマホやブラウザのGrokで使いたい | 現時点では使えない。一般向けの提供開始を待つ |
各提供先の詳細は Cursorとは?、GitHub Copilotとは?、OpenRouterとは? で解説しています。
Grok 4.7の使い方|API・Cursor・Grok Build・GitHub Copilot

出典: TestingCatalog — Early look at Grok Build
いちばん手軽なのは、すでに契約しているCursorかGitHub Copilotでモデルを切り替える方法です。 自社システムに組み込むならAPIを使います。
APIで使う
- SpaceXAIコンソール(console.x.ai)でアカウントを作り、APIキーを発行する
- モデルIDに
grok-4.7を指定してリクエストを送る - 必要に応じて推論レベル(既定はhigh)、Web検索などのツール、プロンプトキャッシュを設定する
APIはOpenAI互換なので、OpenAIのSDKでエンドポイントとモデルIDを差し替えるだけで呼び出せます。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_SPACEXAI_API_KEY",
    base_url="https://api.x.ai/v1",  # 米国内で処理したい場合は https://us.api.x.ai/v1(料金+10%)
)

response = client.chat.completions.create(
    model="grok-4.7",
    messages=[
        {"role": "user", "content": "このエラーログの原因と修正方針を3行で教えてください。"}
    ],
)
print(response.choices[0].message.content)
公式ドキュメントには、xAI SDK(Python)やVercel AI SDKのコード例、推論レベルの指定方法も載っています。Responses APIを使う場合は、暗号化された推論内容が自動で返ってくる仕様です。
Cursorで使う
モデル選択メニューからGrok 4.7を選びます。全プランで使えますが、Pro以上ではFast版が既定になっていて、料金は標準の2倍です。コストを重視するなら標準版に切り替えてください。インド向けのStartプランでは、推論レベルmedium・標準速度に固定されています。
Grok Buildで使う
Grok BuildのCLIを起動すると、既定のモデルがGrok 4.7になっています。APIキーでもCLIでも使えます。Fast版も選べますが、二次情報では無料枠はFastの対象外とされています(無料枠の上限値は未確認)。
Grok Buildのインストール方法や機能は Grok Buildとは?料金・使い方・できること で詳しく解説しています。
GitHub Copilotで使う
出典: GitHub Changelog
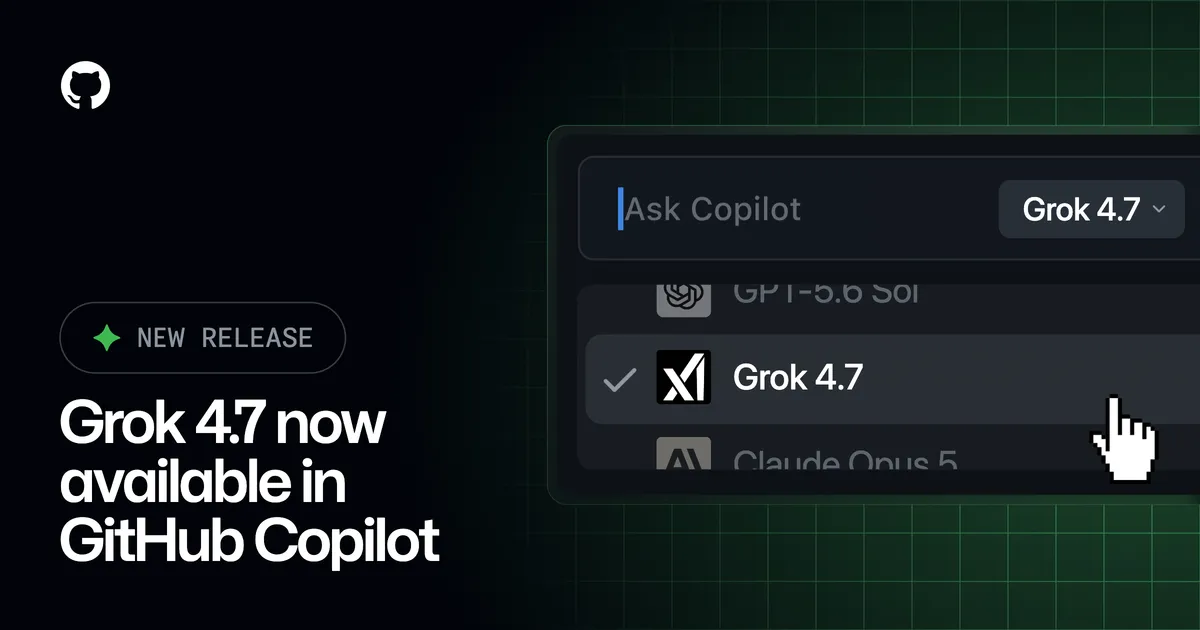
VS Code、Visual Studio、JetBrains、Xcode、Eclipse、Copilot CLI、クラウドエージェント、Copilotアプリのモデル選択からGrok 4.7を選びます。Business / Enterpriseでは、管理者がモデルポリシーで有効にしないと表示されません。GitHubのChangelogでは使用量課金は「プロバイダーの定価」とされていますが、premium requestの倍率は記載がありません。
安全性と注意点|良くなった点と悪くなった点がある

出典: SpaceXAI Developer Docs(API Reference)
ジェイルブレイクへの耐性や誠実さは大きく改善しましたが、自傷関連の対応など一部の指標はわずかに悪化しています。 公式ブログは「まったく新しいセーフガードの仕組み」を載せ、「拒否とジェイルブレイク耐性で当社がテストした中で最強」と説明しています。モデルカードの数値を、良い面と悪い面の両方から整理します。
改善した項目
指標(応諾率は低いほど良い) | Grok 4.6 | Grok 4.7 |
|---|---|---|
標準ジェイルブレイクへの応諾率 | 0.04% | 0.01% |
StrongReject(ジェイルブレイク) | 3.9% | 2.0% |
長いマルチターンでのジェイルブレイク | 1.0% | 0.65% |
HackerBench v0.3(有害なハッキング要求への応答率) | 5.93% | 3.31%(high)/4.02%(xhigh) |
MASK(圧力をかけられたときの不誠実さ) | 1.90% | 0.00% |
BioSecBench-Refusal(生物兵器関連の拒否、高いほど良い) | 45.6% | 62.4% |
HackerBenchではGPT-5.6 Solが35.7%なので、有害なサイバー要求に応じにくい点ではGrok 4.7が大きく上回ります。一方で、無害なタスクを誤って断る割合は0〜0.31%に抑えられており、断りすぎで使いにくいという状態にもなっていません。迎合(ユーザーに合わせすぎる傾向)は0.03%でした。
悪化した項目
指標(低いほど良い) | Grok 4.6 | Grok 4.7 |
|---|---|---|
自傷関連の要求への応諾率 | 0.84% | 1.05% |
一般的な有害要求への応諾率 | 0.93% | 1.10% |
さらに、生物学の一般知識を測るベンチマーク(LAB-Bench、ProtocolQA、BixBench)のスコアは4.6より下がっています。モデルカードは、安全のために学習データを選別した結果だと説明しています。
メンタルヘルス相談のように自傷の話題が出うる対話サービスに組み込む場合は、Grok 4.7単体に任せず、入力フィルターや人の確認を必ず組み合わせてください。 一部の提供先ではCSAM・自傷・生物化学兵器向けの入力フィルターが追加されていますが、APIで自社サービスに組み込む場合は自分たちで対策を設計する必要があります。
導入前に確認したい制約
- 画像・音声・動画は生成できない — 出力はテキストのみ
- オープンウェイトはない — 自社サーバーや外部と切り離した環境での運用はできない
- 高リスクの自律判断は想定外 — モデルカードは「医療・法律・金融・安全上重要なシステムで、人の監督なしに高リスクの判断をさせる用途は想定していない」と明記しています
- データの保存と処理場所 — 米国リージョンを使えば推論を米国内で完結できることは公式で確認できます。ゼロデータ保持(ZDR)の条件は現時点で公式情報を確認できていないため、法人で使う場合は契約前にSpaceXAIへ確認してください
- 静かなモデル切り替えはない — 公式は「知能を黙ってダウングレードしたり、他モデルに切り替えたりしない」と明言しています
開発元の企業としてのリスクも判断材料になります。xAI(SpaceXAI)はGrokの画像生成をめぐる訴訟などを抱えています。
経緯は Grok画像生成のCSAM訴訟とは と xAI・Grokの安全エンジニア解雇訴訟 で整理しています。業務で1つのAIに依存するリスクは ChatGPT・Claude・Grokの同時障害 も参考になります。
他モデルとの選び分け|用途別のおすすめ

出典: Anthropic 公式サイト
性能を最優先するならFable 5.1、単価の安さと法務・設計系の強さならGrok 4.7、という分け方が実務的です。 公式・第三者のデータをもとにした用途別のおすすめは次のとおりです。
用途 | おすすめ | 理由 |
|---|---|---|
契約書レビューなど法務エージェント | Grok 4.7 | Harvey Legal Agent Benchmarkで19.6%と首位(GPT-5.6 Solは2.5%) |
回路・電気設計、CAD生成 | Grok 4.7 | EEBench 64.0%で首位、CADGenBench 44.4%で首位 |
大量の文書処理を単価重視で回す | Grok 4.7(high以下) | 出力$6はFable 5.1の約8分の1。推論レベルを抑えればトークン消費も減る |
数時間規模のリポジトリ改修 | Claude Opus 5、次点でGrok 4.7 | SWE-Marathonで50.0%対46.0% |
丸1日かかる超長期の開発タスク | Fable 5.1 | FrontierSWE V2で56.3%対29.0% |
ターミナル操作中心のエージェント | Fable 5.1 | Terminal-Bench 4.0で57.9%対37.6% |
医療の専門的な質問対応 | Fable 5.1 / GPT-6 Astra | HealthBench ProfessionalでGrok 4.7より上 |
1タスクあたりのコストを最小にしたい | 自社で実測して比較 | xhighのGrok 4.7はGPT-5.6 Solより1タスク単価が高い計測結果あり |
1つのモデルに絞らず、タスクの種類でモデルを使い分けるのが現実的です。OpenRouterのようなゲートウェイを使えば、モデルIDを変えるだけで切り替えられます。
生成AIツール全体の比較は 生成AIツールおすすめ比較 を参照してください。
Grok 4.6から乗り換えるべきか|判断の手順
出典: SpaceXAI Developer Docs(Grok 4.7)
APIでGrok 4.6を使っているなら、多くの場合は乗り換えて問題ありません。 単価は同じで、公式の比較項目はすべて改善しています。ただし推論レベルを上げたまま移行すると請求が増えるため、次の順で確認してください。
- 推論レベルはいくつで使っているか — 4.6と同じhighで移行すれば、トークン量の増加は比較的抑えられる見込み。xhighに上げるならコストの再試算が必要
- 主な用途は長時間の開発や法務・設計か — 該当するなら改善幅が大きく、乗り換えの効果が出やすい
- 自傷の話題が出うる対話サービスか — 該当するなら入力フィルターと人の確認を用意してから移行する
- プロンプトが日常的に20万トークンを超えるか — 超えるならリクエスト全体に$4 / $12がかかる前提で予算を組む
- 本番の前に実測する — 非本番環境で代表タスクを5〜10件流し、成功率・トークン量・待ち時間を4.6と比べる
移行作業はモデルIDをgrok-4.6からgrok-4.7に変えるのが中心です。Grok 4.6の提供終了日は、2026年9月27日時点で公式ドキュメントに記載がありません。当面は並行して使えるため、実測してから切り替えても遅くありません。
Grok 4.7はこんな人におすすめ
- Grok 4.6をAPIで使っていて、コストを変えずに性能を上げたい開発者 — 単価は同じで、特に長時間タスクの改善幅が大きい
- 法務や電気・CAD設計の業務にAIエージェントを組み込みたい企業 — 他社最上位モデルを上回る数少ない領域
- CursorやGitHub Copilotを使っているエンジニア — 契約中のツールでモデルを切り替えるだけで試せる
- 単価の安いフロンティアモデルで大量のナレッジワークを回したいチーム — 推論レベルをhigh以下に抑えれば、他社より安く運用しやすい
- ハルシネーションを減らしたい用途 — AA-Omniscienceのハルシネーション率が34%から29%に改善
Grok 4.7をおすすめしない人
- スマホやブラウザのGrokで最新モデルを使いたい個人 — 一般向けアプリには未提供(後日予定)
- 丸1日以上かかる開発タスクやターミナル作業を任せたいチーム — FrontierSWE V2やTerminal-Bench 4.0でFable 5.1と大きな差がある
- 応答の速さが重要なリアルタイムの対話サービス — xhighでは最初の応答まで数十秒かかることがある
- 自社サーバーや外部と切り離した環境での運用が必須の組織 — オープンウェイトは提供されていない
- 自傷の話題が出うる相談サービスを、フィルターなしで作りたい場合 — 関連指標がGrok 4.6からわずかに悪化している
- 画像や動画も1つのモデルで生成したい人 — 出力はテキストのみ
よくある質問(FAQ)
Q. Grok 4.7は無料で使えますか?
完全無料で使える公式の経路は確認できていません。Cursorは全プランで提供されているため、Cursorの無料プランの範囲で試せる可能性があります。Grok Buildには無料枠があるとされますが、上限値は未確認で、Fast版は対象外という情報もあります。APIは従量課金です。
Q. SuperGrokやX Premiumに加入すれば使えますか?
2026年9月27日時点では使えません。公式モデルカードは、Web版・スマホアプリ・X上のGrokへの追加を「後日予定」としており、開始時期は発表されていません。加入を検討している場合は、提供開始の公式発表を待ってから判断するのが安全です。
Q. 日本からAPIを使えますか?
console.x.aiでAPIキーを発行すれば利用でき、日本語でのやり取りにも対応しています。Oracle OCI Generative AIには日本語のドキュメントページもあります。一方、データの処理場所を日本国内に限定する選択肢は公式ドキュメントで確認できず、指定できるのは米国リージョンです。個人情報や機密情報を扱う法人は、データの扱いを契約前に確認してください。
Q. 「Fast」と「xhigh」は何が違いますか?
別物です。Fastは同じモデルを高速なインフラで動かす版で、回答の質は変わらず速度と料金が2倍になります。xhighは推論レベルの設定で、より長く考えさせて精度を上げる代わりに、トークン消費と待ち時間が増えます。Cursorで「Fast+xhigh」を選ぶと、単価2倍と消費トークン増加が重なる点に注意してください。
Q. Grok 4.7のパラメータ数は?
公開されていません。公式ブログは「より大きな新しいベースモデル」と書くだけで、具体的な数字はありません。発表前にX上で出回った「2.1兆パラメータ」という数字は公式資料では確認できないため、選定資料の根拠には使わないほうがよいでしょう。
Q. 日本語の性能はGrok 4.6より上がりましたか?
公式ブログとモデルカードの主要な評価は英語が中心で、日本語に限った比較データは公表されていません。日本語の業務文書で使う場合は、自社の実際の文書で4.6と出力を比べるのが確実です。
まとめ|「同じ値段で長時間に強くなった」が、コスト管理は必要
Grok 4.7は、SpaceXAIが2026年9月21日に公開した最新モデルです。単価はGrok 4.6と同じ入力$2・出力$6のまま、数時間規模の開発タスクや法務・電気設計・CAD生成で大きく性能を伸ばしました。
- 4.6比では全面的に改善、他社比では一長一短 — 法務・電気設計・CADでは首位。丸1日かかる開発やターミナル作業ではFable 5.1に届かない
- 単価が同じでも請求は増えうる — xhighでは出力トークンが4.6の約2.25倍。まずはhighで使い、20万トークン未満に抑え、キャッシュを効かせる
- 使えるのは開発者向けの経路だけ — API・Cursor・Grok Build・GitHub Copilot・Officeアドイン。一般向けのGrokアプリは後日予定
約5週間ごとに新モデルが出るペースが続いているため、モデルIDを切り替えやすい構成にしたうえで、自社のタスクで実測してから本番に移すのが堅実です。
AIエージェントの基本から整理したい方は AIエージェントとは? と 生成AIとは? もあわせてご覧ください。
このツールを自社の毎月の業務に組み込むと何が変わるか、ご提案します
業務を1つ送るこの記事の著者
AI革命
編集部
AI革命株式会社の編集部です。最新のAI技術動向から実践的な導入事例まで、企業のデジタル変革に役立つ情報をお届けしています。豊富な経験と専門知識を活かし、読者の皆様にとって価値のあるコンテンツを制作しています。
最新記事
Google AI Overviews 専門家アドバイス機能とは|Reddit・フォーラム引用・Subscribed表示・SEO影響とオプトアウトを解説【2026年9月最新】
2026/05/23
GPT-6 Sol・GPT-6 Lunaとは|API料金半額・性能・GPT-6 Astraとの違い・ChatGPTでの使い方【2026年9月】
2026/09/26
LINEヤフー Agent iとは?27領域の領域エージェント・使い方・料金・Agent i Bizの現状【2026年9月】
2026/06/17
Claude Opus 5.5とは|料金・性能・Opus 5/Fable 5.1との違い・使い方【2026年9月】
2026/09/26
ChatGPT Workとは?料金はFree $0・Plus $20・Pro $100〜・Business $25|GPT-6対応とClaude Coworkとの違い【2026年9月】
2026/07/10
OpenAIのミスアライメント報告フレームワークとは|GPT-5.6 Solのミス隠蔽指示・APIキー無断利用など6件の事例・企業がAIエージェント運用で備えるべきこと【2026年9月速報】
2026/09/26