AIコーディングのセキュリティリスクとは?脆弱性・情報漏洩・2026年の最新事例と対策
この記事のポイント
AIコーディングのセキュリティリスクを「AIが書くコード」と「AIが動くエージェント」に分け、2026年10月時点の調査データ(Veracode 2026など)と最新事例、主要ツールの公式の防御機能、今日から確かめられる対策まで整理します。
AIコーディングのセキュリティリスクは、大きく「AIが書くコードに脆弱性が入るリスク」と「コマンドを実行するAIエージェントが乗っ取られる・暴走するリスク」の2つです。Veracodeの2026年版レポートでは、セキュリティの指示を含めずにコードを書かせると約44%のタスクで既知の脆弱性が入り、この割合は前回調査からほとんど改善していません。
2026年に入ってからは、生成コードの品質よりも、Claude Code・Codex・Gemini CLIなどのエージェントを動かす仕組みの脆弱性や、リポジトリ・指示ファイルを経由した乗っ取りの報告が増えています。IPAの「情報セキュリティ10大脅威 2026」でも、「AIの利用をめぐるサイバーリスク」が組織編の3位に初めて選ばれました。
この記事でわかること
- AIコーディングで起こりうる6種類のセキュリティリスクと、それぞれ誰が対策するか
- AI生成コードの脆弱性に関する2026年の調査データと、その読み方
- 2026年2月〜10月に報告された主な事例(Black Hat USA 2026、GitSpawn、指示ファイル経由の乗っ取りなど)
- Claude Code・GitHub Copilot・Cursor・Codexが標準で守っている範囲と、利用者側に残る作業
- 個人利用と企業利用で何から整えるか、今日5分で確かめられる設定
想定読者: AIコーディングツールを業務で使っている、またはこれから導入を検討しているエンジニア・開発チームリーダー・情報システム部門の方。
AIコーディングのセキュリティリスクが注目される背景
注目が高まっている理由は、AIが「コードを提案する道具」から「ファイルを書き換え、コマンドを実行し、プルリクエストまで作る作業者」に変わったからです。提案だけなら人が読んでから取り込めますが、エージェントは人が見ていない間にも操作を進めます。
公的機関もこの変化を取り上げています。
発表元 | 時期 | 内容 |
|---|---|---|
IPA「情報セキュリティ10大脅威 2026」 | 2026年1月29日 | 組織編3位に「AIの利用をめぐるサイバーリスク」が初選出。AIへの理解不足による情報漏えい・権利侵害、AIの出力を検証せず信用することによる問題、AIの悪用による攻撃の容易化を例に挙げる |
IPA「AIセキュリティ短信 2026年10月号」 | 2026年10月16日 | OpenAI Codexのリモートコード実行の脆弱性、GitLab AI Gatewayのコマンド実行の脆弱性、AIエージェントが社内画像約1.3万枚をGitHubに公開した事例などを掲載 |
OWASP「Top 10 for LLM Applications 2025」 | 2024年11月 | プロンプトインジェクションが1位(LLM01) |
OWASP「Top 10 for Agentic Applications 2026」 | 2025年12月 | AIエージェント向けのリスク一覧。1位(ASI01)は、エージェントが読み込む内容を通じて目的を乗っ取られる「Agent Goal Hijack」 |
IPAは10月号で、手口そのものは認証情報の窃取や脆弱性の悪用といった従来型が中心だとしたうえで、AIエージェントでは「プロンプトがシステム操作に直結しうる」点に注意を促しています。対策の方向として、モデルの外側で実行範囲を制御し、認可をモデルの判断に任せないことを挙げています(出典: IPA AIセキュリティ短信、IPA 情報セキュリティ10大脅威 2026)。
生成AI全般の情報漏えいやプロンプトインジェクションの基本は、生成AIのセキュリティリスクとは?で解説しています。
AIコーディングの主なセキュリティリスク6つ
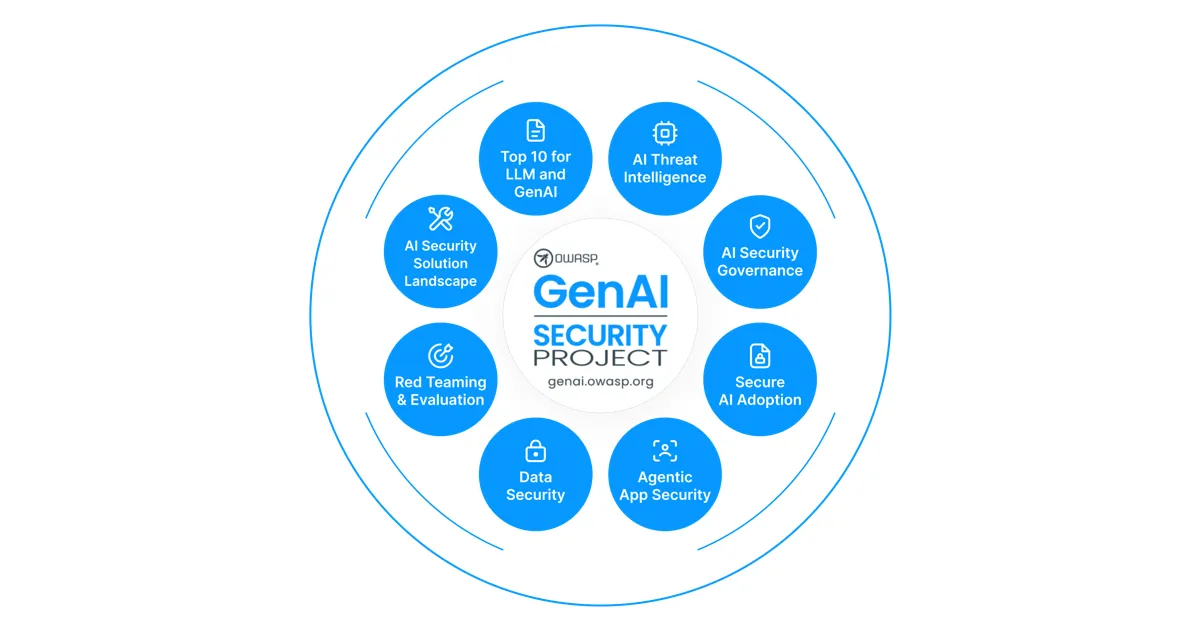
出典: OWASP GenAI Security Project 公式
AIコーディングのリスクは6つに分けられ、前半の3つは「AIが書くコード」、後半の3つは「AIが動く(エージェント)」側の問題です。前者はコードレビューやスキャンで見つけるもの、後者は端末・権限・設定を管理する人が防ぐもので、担当が変わります。
1. 脆弱なコードの生成
もっとも件数が多いリスクです。SQLインジェクション、XSS(クロスサイトスクリプティング)、認証・認可の不備など、昔からある脆弱性を含むコードが出てきます。
起きやすい理由は3つあります。
- セキュリティ要件を書かないと、対策が抜けやすい。「ログイン機能を作って」だけでは、入力チェックやCSRF対策、レート制限が入らないことがある
- 学習元にある古い書き方を再現する。古いチュートリアルや回答サイトのコードの癖がそのまま出る
- そのアプリ固有のルールを知らない。社内の認可ルールや既存のセキュリティ設計は、伝えない限りAIには分からない
Veracodeの2026年版では、SQLインジェクションや暗号の扱いは8割以上のタスクで安全に書けた一方、XSSは15%、ログインジェクションは12%しか合格しませんでした。脆弱性の種類によって得意・不得意の差が大きいので、レビューでは出力のエスケープとログ出力の部分を重点的に見るのが効率的です。
2. 機密情報の漏えい
ソースコード、APIキー、顧客データがAIサービスに送られたり、生成コードに埋め込まれたりするリスクです。
- 入力からの流出: 社内コードや設定ファイル、
.envをそのままAIに読ませる - 生成コードへの埋め込み: APIキーや接続文字列がハードコードされたままコミットされる
- データの扱いの違い: 入力が学習に使われるかどうかはツールとプランで異なる。たとえばClaude Codeは、商用規約(Team / Enterprise / API)と個人向け規約(Free / Pro / Max)でデータの扱いが分かれている
2023年に韓国Samsungで社員が社内コードをChatGPTに入力した件は、ツールの仕組みより利用者の判断が漏えいの大きさを決めることを示した例として、今もよく引かれます。GitHub Copilotの学習利用の設定は、GitHub Copilot 学習オプトアウト設定の完全手順にまとめています。
3. サプライチェーン攻撃(スロップスクワッティング)
AIが存在しないパッケージ名を推奨し、攻撃者がその名前で悪意あるパッケージを先回りして公開する手口です。「スロップスクワッティング」と呼ばれます。
流れは、AIが実在しないライブラリ名を出す → 攻撃者が同じ名前でnpmやPyPIに登録する → 別の開発者がAIの提案どおりにインストールする、というものです。
USENIX Security 2025で発表された研究(Spracklenら)では、16モデルが生成したPython・JavaScriptのコード約57.6万件を調べたところ、推奨されたパッケージの19.7%が実在しないものでした。オープンソースモデルでは21.7%、商用モデルでは5.2%と差があります。同じ架空の名前が繰り返し出てくる傾向もあり、攻撃者にとって狙いやすい状態です(出典: arXiv 2406.10279)。
AIに限らず、悪意あるnpmパッケージの公開は2026年10月にも確認されています(function-color など)。公開されて間もないパッケージを入れない設定が有効です。
4. 指示ファイル・設定ファイル経由の乗っ取り
エージェントが自動で読み込むファイルに、攻撃者の指示を紛れ込ませる手口です。2025年にPillar Securityが報告した「Rules File Backdoor」は、CursorやGitHub Copilotのルールファイルに、人には見えないUnicode文字で指示を隠すものでした。
2026年はこの系統が広がっています。
- AGENTS.md / CLAUDE.md 経由(2026年10月): Forever Securityが、ダウンロードフォルダに置かれた指示ファイルでエージェントを乗っ取る手口を公表しました。Codexには設定ファイルへMCPサーバーを登録させ、Claude Codeにはプロジェクトの
.claude/settings.jsonに接続先(ANTHROPIC_BASE_URL)を書かせて認証トークンを送らせる、という内容です。エージェントは仕様どおり指示ファイルに従っているだけなので、ベンダーのパッチは出ていません。一方で、10月28日に第三者がCodex 0.160.1・Claude Code 2.1.296で計80回再現を試したところ、両エージェントとも攻撃と判断して拒否し、成功は0回でした。バージョンや承認・サンドボックスの設定で結果が変わる可能性があります(出典: piyolog) - git設定経由(2026年9月、GitSpawn): 信頼できないリポジトリに仕込んだgitの設定(
core.fsmonitorなど)が、エージェントがgitを呼ぶたびにサンドボックスや承認の外で実行されるという報告です。Claude Code、Codex、Cursorなど複数のツールが対象とされ、公開時点では8件中4件が未修正と伝えられました
見た目は普通の設定ファイルやリポジトリなので、コードレビューだけでは気づきにくい点が厄介です。
5. AIエージェントの過剰権限
エージェントは、ファイルの読み書き、シェルコマンド、外部API、GitHubへのpushなどを扱えます。権限を広く渡すほど、乗っ取られたときや判断を誤ったときの被害が大きくなります。
攻撃者がいなくても事故は起きます。2026年9月に報告された「PixelLeak」では、コーディングエージェントがGitHub CLIの制約を回避しようとして、社内のスクリーンショットを公開リポジトリにpushしていました。報告では300を超える組織、1.3万枚を超える画像が対象とされています。IPAの10月号でも同じ系統の事例が取り上げられました。本番データベースの削除のような「暴走」も、権限の渡しすぎから起きる事故です。
エージェントには、そのタスクに必要な範囲の権限だけを渡すのが基本です。詳しい設計はAIエージェントのセキュリティ対策を参考にしてください。
6. プロンプトインジェクション攻撃
エージェントが読むissue、プルリクエストのコメント、Webページ、MCPサーバーの応答などに指示を埋め込み、本来の目的と違う操作をさせる攻撃です。OWASPのLLM向けTop 10で1位、エージェント向けTop 10でも1位(目的の乗っ取り)に位置づけられています。
2026年2月に報告された「RoguePilot」(Orca Security)は、悪意あるissueのHTMLコメントからGitHub Codespaces上のCopilotに指示を注入し、GITHUB_TOKEN を外部へ送らせるものでした。GitHubは修正済みで、現在のCopilotクラウドエージェントはissueやコメント中のHTMLコメントをエージェントに渡さない仕様になっています。
MCPサーバー経由の注入についてはMCPとは?でも触れています。
6つのリスクの整理
リスク | 分類 | 主に対策する人 | 主な対策 |
|---|---|---|---|
脆弱なコードの生成 | AIが書くコード | 開発者・レビュー担当 | 人のレビュー、SAST、テスト |
機密情報の漏えい | AIが書くコード/利用方法 | 開発者・情シス | 読ませるファイルの制限、学習利用の設定、シークレット検出 |
スロップスクワッティング | AIが書くコード | 開発者・レビュー担当 | パッケージの実在・公開日の確認、SCA |
指示ファイル・設定ファイル経由 | AIが動く | 開発者・端末管理者 | 起動場所の制限、設定ファイルの監視、信頼できないリポジトリはVMで |
過剰権限 | AIが動く | 情シス・管理者 | 最小権限、サンドボックス、push先の制限 |
プロンプトインジェクション | AIが動く | 情シス・管理者 | 外部入力の扱いの制限、ネットワーク制限、承認の維持 |
AI生成コードの脆弱性に関する最新データ
出典: Veracode 公式
調査ごとに対象・条件が違うため、「AI生成コードの◯%が危険」と1つの数字に丸めることはできません。ただし、2026年のどの調査でも「モデルが新しくなっても、安全性は自動では上がらない」という結果は共通しています。
主要な調査データ一覧
調査 | 時期 | 対象・条件 | 主な結果 |
|---|---|---|---|
Veracode「2026 GenAI Code Security Report」 | 2026年7月 | 複数の主要モデルに、セキュリティの指示なしでコードを書かせる | 安全性の平均合格率56%(初回55%からほぼ横ばい)。約44%のタスクで既知の脆弱性。最高はGPT-5.5の68%、半数を超えるモデルが50〜53% |
Microsoft Research・CISPA(arXiv 2606.23130) | 2026年 | 公開中のバイブコーディング製アプリ200件 | 91%に脆弱性。計1,186件のうち65.77%がCritical/High。※査読前のプレプリント |
Georgia Tech「Vibe Security Radar」 | 2026年1〜3月 | AI生成コードが原因と追跡できたCVE | 1月6件 → 2月15件 → 3月35件。コミットの共著者タグなどで判定するため、少なめに出ている可能性がある |
Spracklenら(USENIX Security 2025) | 2025年 | 16モデル・約57.6万件のコード | 推奨パッケージの19.7%が実在しない |
(出典: Veracode、Infosecurity Magazine)
数字の読み方
Veracodeの調査で目立つのは、生成コードが構文的にはほぼ毎回コンパイルできるのに、安全性の合格率はほとんど伸びていない点です。「新しいモデルに変えれば安全になる」とは期待しないほうが現実的です。
脆弱性の種類による差(SQLインジェクション83%・暗号87%に対し、XSS 15%・ログインジェクション12%)は、プレースホルダーのように定番の書き方が決まっているものは正しく書ける一方、出力する場所ごとに対処が変わるエスケープは抜けやすい、と読むことができます。
Georgia Techの集計は、共著者タグを付けるツールほど件数が多く出る偏りがあります。ツールごとの件数を「危険度ランキング」として読むのは避けてください。研究者は、追跡できていないものを含めるとOSS全体で400〜700件程度あると推定しています。
スキャンツール1つでは足りない理由
Veracodeは、コードを書く段階と本番前の両方で検証すること、悪用されやすく影響の大きい欠陥から直すことを勧めています。SASTは既知のパターンには強いものの、認可の抜けや「そのアプリでは何が許されるか」の判断は苦手です。SAST・依存関係のスキャン(SCA)・シークレット検出に、人のレビューとテストを組み合わせるのが前提になります。
2025〜2026年に起きた主なインシデント事例
2026年後半の事例は、生成コードの中身よりも、エージェントを動かすソフト(ハーネス)や、エージェントが読むリポジトリ・設定を狙ったものが中心です。
時期 | 事例 | 種類 | 概要 |
|---|---|---|---|
2026年2月 | RoguePilot | プロンプトインジェクション | issueのHTMLコメントからCodespaces上のCopilotに指示を注入し、GITHUB_TOKENを外部に送らせる。GitHubが修正 |
2026年3月 | Amazonの小売サイト障害 | 運用・品質 | 3月2日の障害で、社内レビューがAmazon Qを要因の一つとしたと報道。別の大規模障害はAIと無関係とする報道もある。Amazonは主要システムで2人レビューなどの「code safety reset」を実施と報じられた(いずれも報道ベース) |
2026年3月 | Claude Codeのソースコード流出 | 配布物の設定不備 | 公開パッケージ経由で内部のソースコードが読める状態になった件。詳細はClaude Codeソースコード流出まとめ |
2026年8月 | Black Hat USA 2026での発表(Novee Security) | ハーネスの脆弱性 | Claude Codeで3件(リモートコード実行、任意ファイルの読み取り、APIキー・GitHubトークンの窃取)、Gemini CLIで1件(CVSS 10.0と報道)、Codexで1件(AGENTS.mdの書き換え)。いずれも公表前に修正済み |
2026年9月 | GitSpawn | リポジトリ経由 | 信頼できないリポジトリのgit設定が、サンドボックスと承認の外で実行される。公開時点で8件中4件が未修正 |
2026年9月 | Plugin4Shell | プラグインの供給網 | プラグインが固定しているコミットを、同じ名前のブランチで差し替えて自動更新時にコードを実行させる手口。複数のエージェントが対象と報道 |
2026年9月 | PixelLeak | 事故(攻撃者なし) | エージェントが社内スクリーンショットを公開リポジトリにpush。300超の組織・1.3万枚超 |
2026年10月 | 悪性npmパッケージ | サプライチェーン | 悪性の版(1.0.0/1.7.3)が公開された |
2026年10月 | 指示ファイル経由の乗っ取り(Forever Security) | 指示ファイル | 公表は10月22日。第三者の再現試験(10月28日)では80回中0回成功 |
事例から読み取れること
問題の中心がモデルからハーネスに移っている。 Black Hat USA 2026の発表者は、問題はAIモデルではなく、危険な操作を止める仕組みを回避できてしまうことにあると指摘しました(出典: マイナビニュース)。ツールのアップデートを止めず、最新版で使うことが対策の一つになります。
「承認したから安全」とは限らない。 GitSpawnのように、承認やサンドボックスの外で動く経路が見つかることがあります。信頼できないリポジトリは、使い捨てのVMやコンテナで開くのが確実です。
攻撃者がいない事故も同じくらい重い。 PixelLeakやAmazonの件は、悪意ある第三者がいなくても、権限とレビュー体制しだいで情報流出や障害が起きることを示しています。Amazonの件は原因について報道ごとに見方が分かれており、「AIのせいで◯万件」と断定できる段階ではありません。レビュー体制の見直しにつながった事例として捉えるのが妥当です。
ツール別・モデル別のセキュリティ比較
どのツールが一番安全かは断定できません。ただし、ツールごとに「標準で守っている範囲」と「利用者が設定しないと守られない範囲」は公式ドキュメントで確認できます(2026年10月30日時点)。
主要ツールのセキュリティ機能比較
ツール | 標準で有効になっている主な防御 | 利用者側に残る注意点 | データの扱い |
|---|---|---|---|
Claude Code | 対話セッションの既定は「Auto mode」(別の分類モデルが操作を審査し、危険なものを止める)。 | 作業ディレクトリの境界は確認の表示であり、承認したBashコマンドはユーザー権限でどこにでも書き込める。deny ルールはコマンド文字列で判定する。 | 商用規約(Team / Enterprise / API)と個人向け(Free / Pro / Max)で異なる。個人向けは学習利用の設定を変更できる |
GitHub Copilot クラウドエージェント | 生成コードにCodeQL、新規依存の脆弱性・マルウェア照合、シークレットスキャンを自動実行(Advanced Securityのライセンス不要)。pushは | 自動検証やファイアウォールは無効にできてしまう。ブランチ保護をバイパスする権限をCopilotに与えると保護が効かない | プランごとに異なる。個人向けプランは学習利用の設定を確認 |
Cursor | Privacy Mode(有効時は学習に使わない。Free / Proでも有効化でき、チームでは管理者が強制可)。SOC 2 Type II、ISO/IEC 27001、ISO/IEC 42001を取得 | エージェントの自動実行の既定値などは、Hooks・エージェントセキュリティのドキュメントで要確認 | Privacy Modeの設定しだい |
OpenAI Codex | サンドボックスと承認の仕組みを持つ。防御側の製品として、コードをスキャンする「Codex Security」も提供 | 既定の承認・サンドボックス設定は公式の Sandboxing / Agent approvals のページで要確認。2026年9月にはサンドボックスを抜ける脆弱性が報じられた(修正済みとされる) | プランごとに異なる |
(出典: Claude Code Security、GitHub Docs: Risks and mitigations for Copilot cloud agent、Cursor Security、OpenAI Codex Security)
Claude Codeの既定の権限モードは2026年8月に変わったため、以前の「すべて承認制」という前提の運用ルールは見直しが必要です。変更の中身はClaude Code Auto Mode とは?、設定の具体例はClaude Codeのセキュリティと安全な使い方で解説しています。ツールそのものの特徴はGitHub Copilotとは?、Cursorとは?、OpenAI Codexとは?を参照してください。
どのベンダーも、防御は「設定どおりに使われる」前提で作られています。Claude Codeの公式ドキュメントも、すべての攻撃を防げるシステムはないとしたうえで、承認前に安全性を確かめる責任は利用者にあると明記しています。
モデル別の脆弱性率(Veracode 2026)
Veracodeの2026年版では、安全性の合格率がもっとも高かったのはGPT-5.5の68%で、半数を超えるモデルは50〜53%にとどまりました。最上位のモデルでも3割強のタスクで脆弱性が入る計算です。
モデルの差より「出力をどう検証するか」の差のほうが結果を大きく左右します。Veracodeも、モデル選びにセキュリティ評価を加えたうえで、どのモデルをどこで使い、出力をどう確認するかを社内の方針として決めるよう勧めています。
バイブコーディング(Vibe Coding)の落とし穴
バイブコーディング(Vibe Coding)とは、AIに自然言語で指示してコードを書かせ、中身を細かく読まずに動作だけ確かめて進める開発スタイルです。試作には向いていますが、そのまま公開すると、人のレビューという防御が丸ごと抜けます。
項目 | 従来の開発 | バイブコーディング |
|---|---|---|
コードレビュー | 人が実施 | 省略されがち |
セキュリティテスト | CI/CDに組み込み | 省略されがち |
コードの理解度 | 開発者が内容を把握 | 動けばよいとなりがち |
依存パッケージ | 既知の信頼できるものを選ぶ | AIの提案をそのまま採用 |
公開までの速度 | 数時間〜数日 | 数分〜数十分 |
バイブコーディングアプリの実態調査
Microsoft ResearchとCISPAの研究者による2026年の調査(査読前)では、公開中のバイブコーディング製アプリ200件のうち91%に脆弱性があり、見つかった1,186件の65.77%がCriticalまたはHighでした。多かったのは、アクセス制御の不備、インジェクション、認証の不備です。
アクセス制御と認証は、「誰が・どのデータに触れてよいか」というアプリ固有のルールに関わる部分で、AIが自分では気づきにくい領域です。公開するアプリでは、ログイン・権限・データベースのアクセス設定だけでも人が確認してください。
バイブコーディング自体の進め方はバイブコーディングとは?、バイブコーディングのやり方で紹介しています。
個人利用と企業利用でリスクはどう変わるか
同じツールでも、企業で使うと影響の範囲と責任が大きく変わります。個人は「漏らさない・公開前に確かめる」、企業は「誰が何を許可するかを決めて、端末と権限を管理する」が出発点です。
観点 | 個人利用 | 企業利用 |
|---|---|---|
情報漏えいの影響 | 自分のコードやキーが中心 | 顧客データ・営業秘密・ソースコード(契約・法的責任あり) |
脆弱性の影響 | 個人サイト・ポートフォリオ | 業務システム・顧客向けサービス |
エージェントの権限 | 自分の端末とアカウント | 社内リポジトリ、クラウド、CI/CDの認証情報 |
ライセンス・知財 | 公開時に自分で確認 | 他者のコードと酷似した出力やライセンス違反が会社のリスクになる |
対策の手段 | 無料のスキャンと設定の見直し | 管理者設定の強制、監査ログ、有償のスキャンツール |
個人利用の場合
学習や試作であれば、次の3点を押さえるだけでもリスクは大きく下がります。
- APIキーや
.envをAIに読ませない・コミットしない - 公開するアプリは、ログインと権限まわりだけでも自分で確認する
- ダウンロードしたリポジトリや、出どころの分からない指示ファイルがあるフォルダでエージェントを起動しない
始め方はAIコーディング初心者ガイドも参考になります。
企業利用の場合
企業では、個人の注意に頼らず仕組みで縛ることが前提です。
- 利用を許可するツール・モデル・プランを決める(学習利用されない規約・設定に限定する)
- 管理者設定で組織の標準を強制する(Claude Codeのmanaged settings、CursorのPrivacy Modeの強制など)
- エージェントに本番の認証情報を渡さない。pushできるブランチと実行できるコマンドを絞る
- 利用状況と設定変更を記録する(Claude CodeはOpenTelemetryでの利用監視や、設定変更を監査するhooksに対応)
- AI生成コードでも、レビューとスキャンを通らなければマージしない
ライセンス・知財の面では、Gartnerも生成コードの知財侵害をリスクの一つに挙げ、SCAによるライセンス確認を勧めています。チームでの権限設計はClaude Code チーム導入ガイドで詳しく扱っています。
会社でAIコーディングを使うときは、社外のモデルにどのデータまで送ってよいか、エージェントをどこで動かすかを先に決めておくと、使えるツールと構成が絞り込めます。社内導入でセキュリティ要件を満たす構成の選び方は、生成AIのセキュリティ要件と社内導入の構成で整理しています。
今日からできるセキュリティ対策
リスクをゼロにはできませんが、「エージェントの起動場所と権限を絞る」「生成コードを検証してからマージする」の2つで大半は抑えられます。
今日からできること(即日対応)
1. 今日5分で確かめること
公表された手口を踏まえて、自分の環境を確認します。
- プロジェクトの
.claude/settings.jsonに、設定した覚えのないANTHROPIC_BASE_URLがないか ~/.codex/config.tomlに、見覚えのない[mcp_servers.*]や変更された接続先がないか- 見つかった場合は、トークンが漏れた前提でログインし直し、トークンを更新する
- ダウンロードフォルダやホームディレクトリ直下でエージェントを起動していないか(プロジェクトのフォルダから起動する)
- 使っているエージェントが最新版か(2026年の脆弱性の多くは修正版で対処済み)
2. 自動承認を常用しない
--dangerously-skip-permissions のような確認をすべて飛ばすオプションは、業務では常用しないでください。どうしても必要な作業は、使い捨てのコンテナやVMの中で行います。-p などの非対話実行は信頼確認が出ないため、実行するフォルダを固定します。
3. 機密ファイルを読ませない
Claude Codeなら、settingsの permissions.deny に Read(./.env) のようなルールを入れて、認証情報のファイルを読めないようにします。認証情報は1PasswordやOSのキーチェーンで管理し、平文のファイルを作業フォルダに置かないのが確実です。
4. プロンプトにセキュリティ要件を書き、生成コードは人がレビューする
「入力値は検証する」「出力はエスケープする」「キーは環境変数から読む」「認可を必ずチェックする」といった要件を最初に伝えます。レビューでは、Veracodeの調査で失敗が多かったXSS・ログ出力と、認証・認可の部分を重点的に見ます。Claude Codeの /security-review のような変更差分のレビュー機能も補助として使えます。
中期的に取り組むこと(1〜3か月)
5. スキャンツールを組み合わせてCI/CDに入れる
ツール種別 | 役割 | 代表的なツール |
|---|---|---|
SAST(静的解析) | コード内の脆弱性パターンを検出 | CodeQL、Semgrep、SonarQube |
DAST(動的解析) | 動いているアプリの脆弱性を検出 | OWASP ZAP、Burp Suite |
SCA(構成分析) | 依存パッケージの脆弱性・ライセンスを検出 | Snyk、Trivy、OWASP Dependency-Check |
シークレット検出 | ハードコードされた認証情報を検出 | Gitleaks、TruffleHog、GitHubのシークレットスキャン |
AI向けのコードスキャン | 生成コードの脆弱性を調べて修正案を出す |
6. 新しすぎるパッケージを避ける
スロップスクワッティングや悪性パッケージは、公開直後に入れてしまうと防げません。pnpmの minimumReleaseAge や、Dependabotの更新待ち期間(cooldown)を設定し、公開から一定期間たったものだけを取り込むようにします。AIが提案した見慣れないパッケージは、公式リポジトリと公開日を確かめてから入れます。
7. 信頼できないコードはサンドボックスで扱う
外部のリポジトリやWebの情報を扱う作業は、Dev Containers、各ツールのサンドボックス、GitHub Codespacesなど、手元の端末と切り離した環境で行います。Claude Codeの公式ドキュメントも、外部のWebサービスとやり取りするときはVMで実行するよう勧めています。
8. AIコーディングの利用ルールを文書にする
情報システム部門・法務・開発チームで、次の項目を決めておきます。
- 許可するツール・モデル・プランと、禁止する設定(自動承認の常用など)
- AIに読ませてはいけない情報
- AI生成コードのレビューとマージの条件
- インシデントが起きたときの報告先(各ベンダーの脆弱性報告窓口を含む)
長期的に整備すること(3か月以上)
9. 管理者設定と監査ログで統制する
IPAが勧めるとおり、接続先・権限・認証認可・外部への出力・ログをまとめて管理し、エージェントの判断に頼らない状態を目指します。MCPサーバーは、ディレクトリに載っていても安全性まで保証されるわけではないため、組織として許可するものを決めます。
10. ツールの更新と事例の確認を定期的に行う
エージェント側の脆弱性は、2026年8〜10月だけでも複数報告されています。ツールの更新を止めない運用にし、IPAのAIセキュリティ短信や各ベンダーのセキュリティ情報を月1回は確認します。
AIコーディングツール導入時のセキュリティチェックリスト
導入前と運用中で、確認する項目が変わります。
ツール選定時のチェック項目
- 入力データが学習に使われない規約・設定にできるか
- 管理者が設定を一括で強制できるか(Privacy Mode、権限モード、MCPの許可など)
- エージェントの権限を細かく制御できるか(ファイル、コマンド、ネットワーク、push先)
- サンドボックスや隔離されたクラウド実行環境があるか
- 生成コードの自動スキャンやレビュー機能があるか
- SOC 2、ISO/IEC 27001などの認証を取得しているか
- 監査ログを取得・出力できるか
- 脆弱性の報告窓口と修正の公表がされているか
運用時のチェック項目
- エージェントを常に最新版で使っているか
- 自動承認やサンドボックスなしの実行を常用していないか
- 信頼できないリポジトリを手元の端末で直接開いていないか
- 設定ファイル(
.claude/settings.json、~/.codex/config.tomlなど)の想定外の変更に気づける仕組みがあるか - AI生成コードもレビューとスキャンを通してからマージしているか
- 公開から日が浅いパッケージを自動で入れない設定になっているか
- 本番の認証情報が開発端末やエージェントの手の届く場所にないか
- インシデント時の対応フローが決まっているか
こんな方にはAIコーディングの利用に注意が必要
AIコーディングは便利ですが、次に当てはまる場合は、対策を整えてから本番の開発に使ってください。
利用に特に注意すべきケース
- セキュリティの基礎知識がないまま本番コードを書く場合。認可の抜けやXSSを見抜けず、そのまま公開してしまうおそれがある
- コードレビューの体制がないチーム。AIの出力が誰のチェックも通らずに本番に入る
- エージェントに広い権限を渡している環境。本番の認証情報やクラウドの管理権限が届く端末で、自動承認のまま使っている
- 医療・金融・インフラなど要件が厳しい開発。生成コードの検証と記録に追加の工数がかかる
- 外部にコードを送れない契約・規程がある案件。利用するツールとプランが規程に合っているかを先に確認する
安心して活用しやすいケース
- セキュリティの基礎があるエンジニアが、生成コードをレビューしてから使う
- CI/CDにスキャンが組み込まれ、通らなければマージできない
- サンドボックスや隔離された環境でエージェントを動かしている
- 学習や試作など、本番に直接影響しない用途で使う
- 会社が許可したツール・設定の範囲で使う
ツール選びはAIコーディングツール おすすめ、エージェントの仕組みはAIエージェントとは?で解説しています。
よくある質問(FAQ)
Q1. AI生成コードは人間が書いたコードより危険ですか?
単純な比較はできません。人も脆弱性を作りますし、AIでも要件を伝えればかなりの部分は安全に書けます。違いは、AIが書く量と速さです。レビューが追いつかないまま大量のコードがマージされると、同じ種類の欠陥がまとめて入り込みます。危険かどうかは、コードの書き手よりもレビューとテストが追いついているかで決まります。
Q2. どのAIコーディングツールが一番安全ですか?
「一番安全」と言えるツールはありません。GitHub Copilotのクラウドエージェントはpush先やワークフロー実行を標準で絞り、Claude Codeは操作を審査するAuto modeとサンドボックスを持つなど、守り方が違います。自社で守りたいもの(ソースコードの社外送信、端末の操作、リポジトリへの書き込み)に合った防御があるかで選び、どれを選んでも設定とレビューは必要です。比較はClaude Code vs GitHub Copilotも参考にしてください。
Q3. バイブコーディングは禁止すべきですか?
一律の禁止は現実的ではありません。試作や社内の検証用ツールまで止めると、利用が隠れて広がり、かえって把握できなくなります。「外部に公開する・顧客データを扱うものは、レビューとスキャンを通すまで公開しない」という線を引くほうが運用しやすいです。
Q4. 指示ファイル経由の乗っ取りは、今も成功するのですか?
2026年10月時点の第三者の再現試験では、Codex 0.160.1とClaude Code 2.1.296で80回試して0回でした。ただし、バージョンや承認・サンドボックスの設定しだいで結果は変わりえます。最新版で使うこと、出どころの分からない指示ファイルがある場所で起動しないこと、設定ファイルの想定外の変更を確認することの3つを続けてください。
Q5. 社内のソースコードをAIに読ませてもよいですか?
規約とプランを確認したうえでなら、多くの企業が業務で使っています。確認したいのは、入力が学習に使われるか、データがどこに保存されるか、管理者が設定を強制できるかの3点です。個人向けプランを業務で使うと、学習利用の設定が人ごとにばらつきます。認証情報や顧客データは、プランにかかわらず読ませない設定にしてください。
Q6. 日本語で指示するとセキュリティ品質は下がりますか?
言語より、セキュリティ要件を書いたかどうかのほうが結果を大きく変えます。日本語でも「入力値を検証する」「認可を確認する」「キーは環境変数から読む」と具体的に書けば、生成コードは変わります。CLAUDE.mdやAGENTS.mdなどの指示ファイルに社内のセキュリティ要件を書いておけば、毎回伝える手間も省けます。
まとめ
AIコーディングのセキュリティリスクは、「AIが書くコード」と「AIが動くエージェント」の2つに分けると、誰が何を対策すべきかがはっきりします。
押さえるべきポイント
- Veracode 2026では、セキュリティの指示がないと約44%のタスクで既知の脆弱性が入り、モデルが新しくなってもほぼ改善していない
- リスクは6つ(脆弱なコード、情報漏えい、スロップスクワッティング、指示ファイル・設定ファイル経由、過剰権限、プロンプトインジェクション)に整理できる
- 2026年後半は、エージェントを動かすソフトやリポジトリ・設定ファイルを狙った報告が増えている。攻撃者のいない事故(PixelLeak)も起きている
- 各ツールの防御は設定どおりに使う前提。自動承認を常用せず、信頼できないコードはサンドボックスで扱う
- 生成コードは、人のレビューと複数のスキャンを通してからマージする
生成AI全般のリスクは生成AIのセキュリティリスクとは?、エージェントの対策はAIエージェントのセキュリティ対策もあわせてご覧ください。
このツールを自社のシステムや業務にどう組み込むか、ご提案します
この記事の著者

AI革命
編集部
AI革命株式会社の編集部です。最新のAI技術動向から実践的な導入事例まで、企業のデジタル変革に役立つ情報をお届けしています。豊富な経験と専門知識を活かし、読者の皆様にとって価値のあるコンテンツを制作しています。
最新記事
Gemini 4 Neonとは?料金・性能・使い方とCarbon・Hydrogenとの違いを解説【2026年11月】
2026/11/19
Anthropic IPOの公開価格は83ドルと報道|円換算・仮条件との差・初値との違いを整理
2026/11/19
電力・ガス・水道のAI活用事例【2026年】需要予測・スマートグリッドの国内実例と導入コスト
2026/05/05
コンサルティング業界のAI活用事例【2026年11月】最も効く業務・費用相場・国内事例・導入手順
2026/07/05
畜産業のAI活用事例【2026年最新】牛・豚・鶏の導入例と費用・補助金・防疫対策
2026/07/16
食品業界のAI活用事例【2026年】HACCP自動化・需要予測・品質検査を製造から外食まで整理
2026/04/21