
Qwen 3.5-Omniとは?機能・料金・3バリアントの違い・後継3.8-Omni-FlashやGPT・Geminiとの比較を解説
この記事のポイント
Qwen 3.5-Omniは、Alibabaが2026年3月に発表した、テキスト・画像・音声・動画をまとめて理解し、テキストと音声で答えるAIモデルです。公式の料金表(Plus・Flash・Realtime)、Lightの提供状況、後継のQwen3.8-Omni-Flashとの選び分け、日本から使うときのリージョンとデータの注意点をまとめました。
Qwen 3.5-Omni(Qwen3.5-Omni)は、Alibaba CloudのQwenチームが2026年3月30日に発表した、テキスト・画像・音声・動画を1つのモデルで理解し、テキストと音声で応答する「オムニモーダル」AIモデルです。 APIで使えるのはPlusとFlashの2つで、テキスト入力の公式料金は100万トークンあたりPlusが$1.4、Flashが$0.4です(シンガポールリージョン、2026年10月時点)。
2026年9月には後継のQwen3.8-Omni-Flashが公開され、料金・コンテキスト長・リージョンの面では後継のほうが有利になりました。新しく使い始めるなら、まず後継と比べてから決めるのが現実的です。
音声エージェントや動画解析にマルチモーダルAIを使いたい開発者、Qwenの導入や乗り換えを検討している企業の担当者に向けた記事です。
Qwen 3.5-Omniとは?テキスト・画像・音声・動画を一括処理するマルチモーダルAI
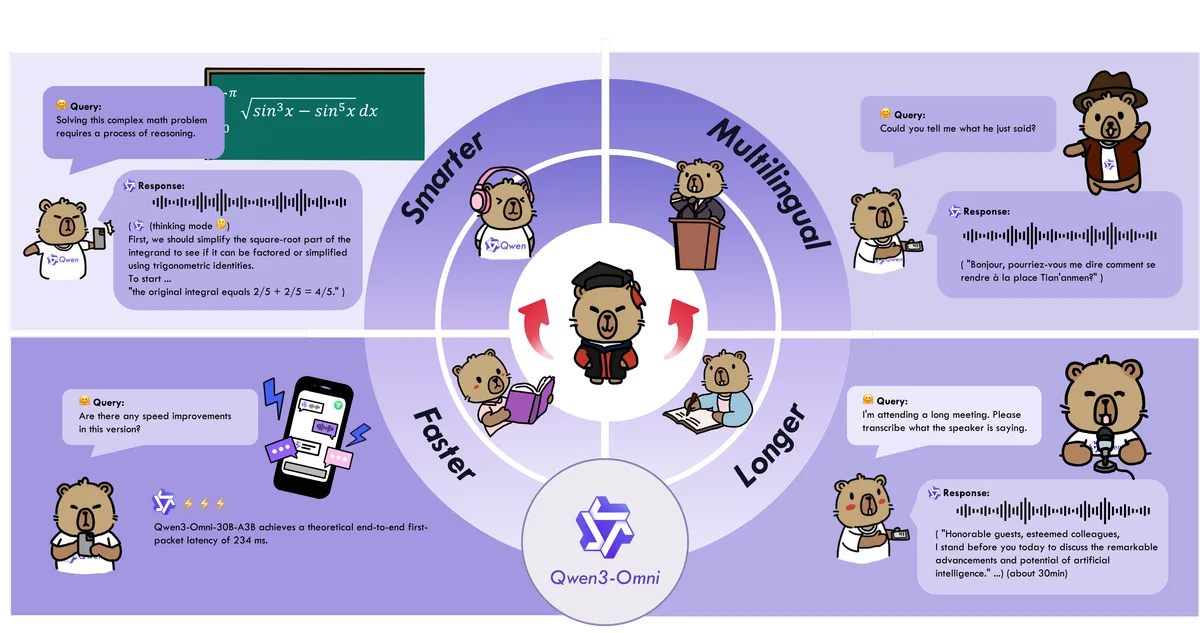
Qwen 3.5-Omniは、音声や動画をテキストに変換してから読むのではなく、最初から4種類のデータをまとめて学習したモデルです。会議の録音、画面録画、写真付きの質問などを1回のリクエストで渡し、答えを文字でも声でも返せます。
項目 | 内容 |
|---|---|
正式名称 | Qwen3.5-Omni |
開発元 | Alibaba Cloud Qwenチーム(通義千問) |
発表日 | 2026年3月30日(APIのスナップショット名は |
技術レポート | arXiv 2604.15804(2026年4月17日公開) |
サイズ | Plus / Flash / Light の3つを発表(APIで使えるのはPlusとFlash) |
対応入力 | テキスト・画像・音声・動画(混在も可) |
対応出力 | テキスト、音声(ストリーミング) |
コンテキスト | 256K(API表記:最大入力196,608トークン/最大出力65,536トークン) |
提供形態 | API(Alibaba Cloud Model Studio/DashScope)、Qwen Chat、Hugging Face・ModelScopeのデモ |
オープンウェイト | なし(2026年10月時点で重みは公開されていない) |
パラメータ数 | 非公開(技術レポートでは「数千億規模」とだけ記載) |
前世代Qwen3-Omniからの主な進化
いちばん大きな変化は、音声の対応言語が大幅に増えたことと、会話を自然に進めるための機能が加わったことです。一方で、前世代はApache 2.0で重みが公開されていましたが、3.5-Omniは重みが公開されていません。
項目 | Qwen3-Omni(前世代) | Qwen3.5-Omni |
|---|---|---|
音声認識の言語 | 19言語 | 113言語・方言(74言語+中国語方言39) |
音声生成の言語 | 10言語 | 36言語・方言(29言語+中国語方言7)※APIの説明では「30言語以上」 |
入力の組み合わせ(API・Flash同士で比較) | テキスト+他の1種類 | テキスト・画像・音声・動画を同時に入力可 |
声のカスタマイズ | なし | 声のサンプルからカスタム音声を作れる(API) |
割り込みの判定 | なし | 相づちと本当の割り込みを区別 |
読み上げの安定化(ARIA) | なし | 数字や珍しい単語の読み上げを安定させる |
重みの公開 | あり(Apache 2.0) | なし(APIとQwen Chatのみ) |
Thinker-Talkerアーキテクチャ
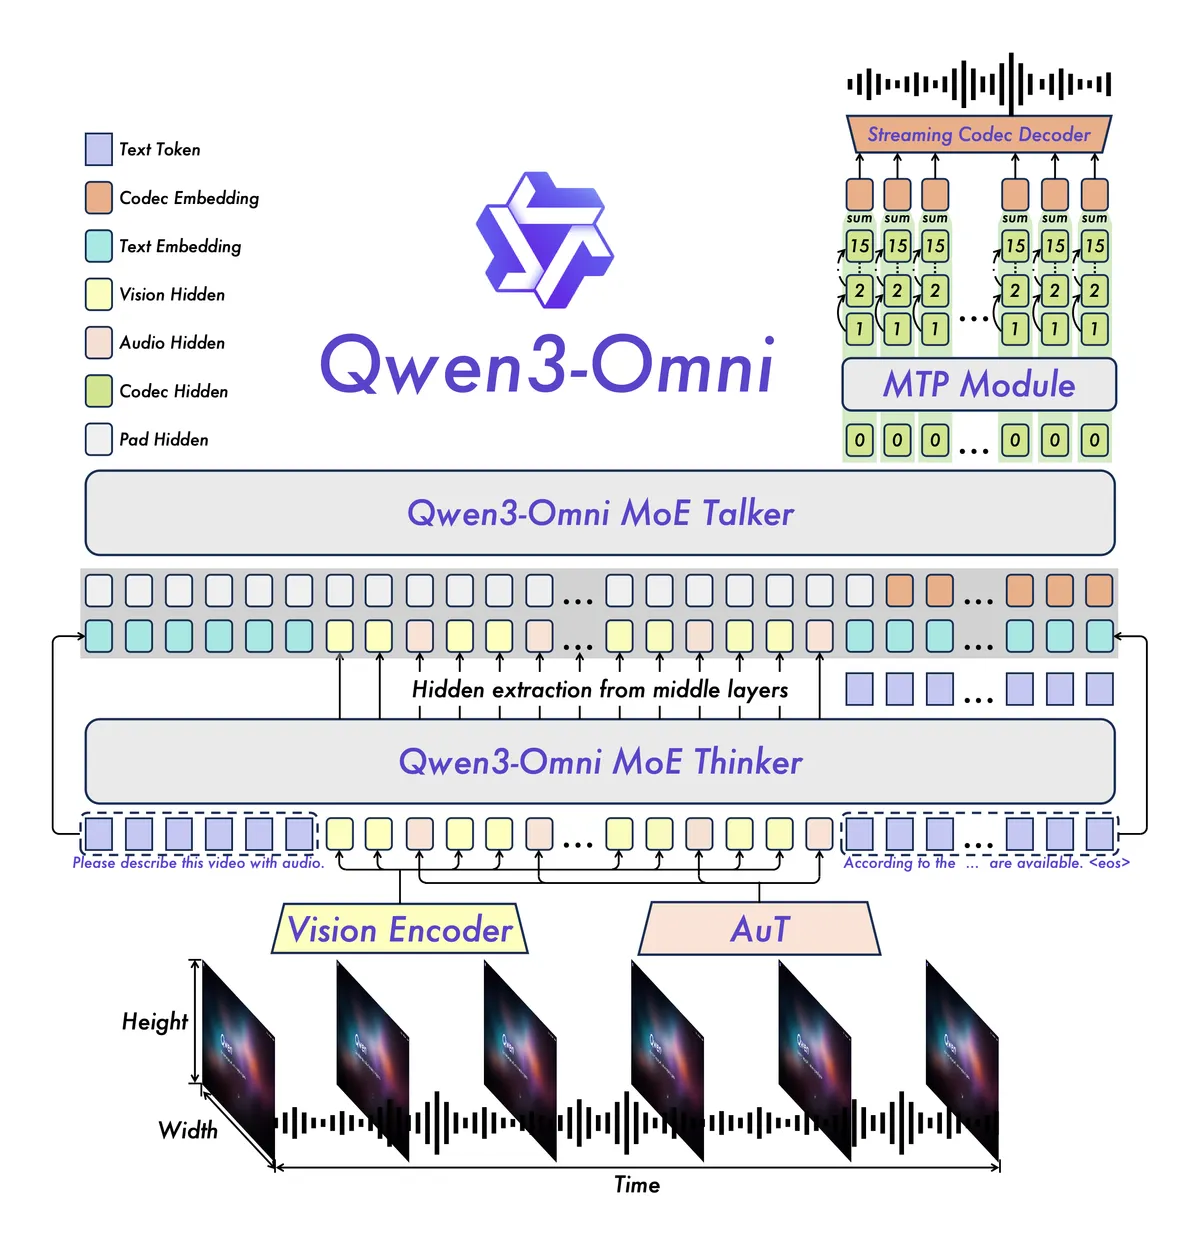
Qwen 3.5-Omniは、役割の違う2つの部分でできています。
- Thinker: テキスト・画像・音声・動画を受け取り、理解・推論してテキストを作る
- Talker: Thinkerの出力をもとに、音声をストリーミングで生成する
技術レポートによると、どちらもHybrid Attention MoE(入力ごとにパラメータの一部だけを動かす構造)を使っています。学習には、テキストと画像の組データに加えて、1億時間を超える音声・映像データが使われました。
応答の速さも公表されており、音声入力から最初の音声が返るまでの時間はFlashが235ミリ秒、Plusが435ミリ秒です。
Qwen 3.5-Omniでできることと機能一覧
出典: Qwen3.5 Omni Online Demo(Hugging Face)
できるのは「4種類のデータを理解すること」と「テキストか音声で返すこと」です。画像や動画を作ることはできません。
対応する入出力
データ | 入力 | 出力 |
|---|---|---|
テキスト | ○ | ○ |
画像 | ○(写真・図表・スクリーンショット・手書きなど) | ×(画像生成は不可) |
音声 | ○(113言語・方言) | ○(36言語・方言、56種類の声) |
動画 | ○(音声付き動画もまとめて理解) | ×(動画生成は不可) |
画像を作りたい場合は、同じQwenシリーズの画像生成モデルを組み合わせます。詳しくはQwen-Image-3.0とはを参照してください。
主要機能の詳細
長い音声・動画の理解
モデルの能力としては、10時間を超える音声や、720P・1秒1コマで400秒を超える音声付き動画を理解できるとされています。ただし、APIで1回に渡せる量には別の上限があります。
入力 | APIの上限(URL指定時) |
|---|---|
音声 | 1ファイル最大3時間・2GB |
動画 | 最大512ファイル・2GB・1時間 |
画像 | 最大2,048枚・1枚20MB |
Base64で直接渡す場合 | 10MB未満 |
10時間の会議録音を1回のリクエストで渡す使い方はAPIではできず、3時間以内に分ける必要があります。
声の種類とカスタム音声
標準の声は56種類(既定は「Tina」)で、多くの声が中国語に加えて英語・日本語・韓国語など28の外国語を話せます。日本語専用の声は用意されていません。
声のサンプルからカスタム音声を作る機能は、PlusとFlashで使えます。Decryptの試用記事によると、この機能はAPI専用で、Qwen Chatの画面からは使えません。
割り込みの判定
相手が「うん」「なるほど」と相づちを打っただけなのか、本当に話をさえぎって質問したいのかを、音の大きさではなく意味で判断します。音声エージェントが相づちのたびに話を止めてしまう問題を減らすための機能です。
音声・映像を見ながらのコーディング
画面録画や動画を見せながら口頭で指示すると、それに沿ったコードを書きます。公式は「Audio-Visual Vibe Coding」と呼んでいます。
字幕・場面分割
動画に対して、時間をそろえた字幕や台本のような説明文を作ったり、場面ごとに区切ったりできます。
Web検索・関数呼び出し
Web検索は北京・シンガポールの両方で使えます。外部のシステムを呼び出す関数呼び出し(Function Calling)は、通常版では北京リージョンのみの対応で、シンガポールの通常版では使えません。Realtime版はどちらのリージョンでも使えます。
多言語の切り替え
Decryptの試用では、会話の途中でスペイン語・ポルトガル語・英語を切り替えても文脈を保ったと報告されています。
3つのバリアント(Plus / Flash / Light)の違いと選び方
公式ブログではPlus・Flash・Lightの3サイズが発表されましたが、2026年10月時点でAPIから使えるのはPlusとFlashだけです。Model Studioの料金表とモデル一覧に qwen3.5-omni-light はなく、技術レポートにもLightの記述はありません。
また、Lightを含めて重みは公開されていません。Hugging FaceのQwen公式組織にあるOmniモデルは前世代のQwen3-Omni-30B-A3BとQwen2.5-Omniだけです(2026年10月21日確認)。一部の海外サイトにある「Qwen3.5-Omni-7B」「Apache 2.0でセルフホスト可能」といった情報は、前世代の情報と混同されたものとみられます。
項目 | Plus | Flash | Light |
|---|---|---|---|
位置づけ | 最上位。精度重視 | 速さと料金のバランス型 | 軽量版として発表 |
APIでの提供 | ○(通常版・Realtime版) | ○(通常版・Realtime版) | ×(2026年10月時点で確認できず) |
重みの公開 | なし | なし | なし |
テキスト入力料金(シンガポール) | $1.4/100万トークン | $0.4/100万トークン | 未公表 |
最初の音声が返るまで | 435ミリ秒 | 235ミリ秒 | 未公表 |
主な用途 | 精度が必要な音声・動画の理解 | 本番運用の標準、試作 | — |
どのバリアントを選ぶべきか
Plusが合うケース
- 長い会議録音や動画の内容理解など、精度を最優先したい
- 音声・音楽・方言の聞き取りなど、Plusのベンチマークが強い分野を使う
- 料金がFlashの約3.5倍(テキスト入力)でも許容できる
Flashが合うケース(多くの場合はこちらから試す)
- 応答の速さを重視する音声エージェント
- 料金を抑えて試作したい(無料枠あり)
Lightを待つべきか
APIでも重みでも提供されていないため、現時点では選択肢になりません。手元のサーバーで動かしたい場合は、重みが公開されている別のモデルを選びます。Apache 2.0で公開されているモデルの例はQwen3.8-27Bとはにまとめています。
Qwen 3.5-Omniの強み
出典: Qwen3.5-Omni Technical Report(Hugging Face Papers)
強みは、音声の聞き取りと音声対話の性能、そして動画を前処理なしで読み込める速さです。一方で、料金の安さは2026年10月時点では強みとは言いにくくなっています。
1. 音声の聞き取り・音声対話の性能が高い
技術レポートでは、PlusがGemini 3.1 Proを音声理解・音声対話の多くの項目で上回っています。特に中国語の方言(KeSpeech)や音楽の理解では差が大きく出ています。
ベンチマーク | 内容 | Qwen3.5-Omni-Plus | Gemini 3.1 Pro |
|---|---|---|---|
MMAU | 音声理解 | 82.2 | 81.1 |
MMSU | 音声理解 | 82.8 | 81.3 |
RUL-MuchoMusic | 音楽理解 | 72.4 | 59.6 |
VoiceBench | 音声対話 | 93.1 | 88.9 |
Fleurs(上位60言語のWER・低いほど良い) | 多言語の音声認識 | 6.55 | 7.32 |
KeSpeech(WER・低いほど良い) | 中国語方言の認識 | 3.46 | 23.67 |
DailyOmni | 音声付き動画の理解 | 84.6 | 82.7 |
MMAR | 音声の推論 | 80.0 | 83.7 |
WorldSense | 音声付き動画の理解 | 62.8 | 65.5 |
AVUT | 音声付き動画の理解 | 85.0 | 85.6 |
OmniGAIA | ツールを使う課題 | 57.2(Flashは33.9) | 68.9 |
出典: Qwen3.5-Omni Technical Report(arXiv 2604.15804)。数値はすべてAlibabaの自己申告で、第三者による検証はまだありません。公式は「215のサブタスクで最高水準」としていますが、表のようにGemini 3.1 Proに負けている項目もあります。
2. 動画を前処理なしで読み込める
従来は、動画からコマを切り出し、音声を文字起こしし、画面の文字を読み取ってから結果をまとめる段取りが必要でした。Qwen 3.5-Omniは音声付き動画をそのまま読み込みます。
Decryptの試用では、同じYouTubeショート動画の分析に、ChatGPT 5.4(思考モード)がコマ抽出・文字起こし・文字読み取りを経て約9分かかったのに対し、Qwen 3.5-Omniは約1分で終えたと報告されています。
3. 113言語の音声認識と56種類の声
音声認識は113言語・方言、音声生成は36言語・方言に対応しています。日本語は音声認識・音声生成の両方の対象に含まれます。中国語の方言を含む多言語の窓口対応や、多国籍の会議録音の処理では選択肢になります。
Qwen 3.5-Omniの弱み・注意すべき制約
導入前に確認しておきたいのは、出力の種類、重みが公開されていないこと、リージョンごとの機能の差、APIの上限、コンテキストの長さです。
1. 画像・動画の生成はできない
出力はテキストと音声だけです。画像や動画を作る用途には使えません。
2. 重みが公開されていない
前世代のQwen3-OmniはApache 2.0で重みが公開されていましたが、3.5-OmniはPlus・Flash・Lightのどれも公開されていません。自社サーバーでの運用やファインチューニングはできず、Model Studio上でもファインチューニングには対応していません。
3. 日本・米国・EUのリージョンがない
Qwen 3.5-Omniが使えるのは中国(北京)とシンガポールの2つだけです。東京・米国・ドイツのリージョンでは提供されていません。米国バージニアやドイツのリージョンで使えると紹介している記事もありますが、Model Studioのドキュメントで3.5-Omniの提供先として載っているのは北京とシンガポールだけです。
4. シンガポールの通常版は機能が少ない
日本の企業が選びやすいシンガポールの通常版では、関数呼び出し・構造化出力・バッチ推論・コンテキストキャッシュが使えません。外部システムと連携するエージェントを作るなら、Realtime版を使うか、別のモデルを検討します。
5. 出力はストリーミングのみ・レート制限あり
APIの出力はストリーミングのみで、音声で返すには stream=True が必須です。レート制限はPlus・Flashとも毎分60リクエスト/毎分10万トークンなので、大量の一括処理には制限の緩和を相談する必要があります。
6. コンテキストは256Kで、後継や競合より短い
256Kは十分な長さですが、後継のQwen3.8-Omni-Flash(100万トークン)と比べると短くなります。ツールを使う課題(OmniGAIA)のスコアもGemini 3.1 Proより低く、複雑なエージェント処理は得意分野とは言えません。
料金・プラン(DashScope APIの料金表)
出典: Alibaba Cloud Model Studio
Qwen 3.5-OmniはAlibaba Cloud Model Studio(DashScope)の従量課金で、Qwen Chatで試すだけなら無料です。以下はModel Studioの公式料金ページで2026年10月21日に確認した通常料金です(期間限定の割引は含みません)。
International(シンガポールリージョン)の料金
単位はすべてUSD/100万トークンです。
項目 | qwen3.5-omni-plus | qwen3.5-omni-flash |
|---|---|---|
入力:テキスト・画像・動画 | $1.4 | $0.4 |
入力:音声 | $11 | $3 |
出力:テキストのみ | $8.3 | $2.2 |
出力:テキスト+音声 | $44 | $11.9 |
無料枠 | 100万トークン | 100万トークン |
「テキスト+音声」で出力したときは、テキスト分は別に課金されません。1秒未満の音声入力は1秒として数えます。Web検索を使うと、検索ツールの料金がモデル料金とは別にかかります。
Realtime版の料金(シンガポール)
音声で会話するリアルタイム用途には、別料金のRealtime版があります。通常版より約1.4〜1.5倍高く設定されています。
項目 | qwen3.5-omni-plus-realtime | qwen3.5-omni-flash-realtime |
|---|---|---|
入力:テキスト・画像・動画 | $2.1 | $0.55 |
入力:音声 | $16.5 | $4.5 |
出力:テキストのみ | $12.4 | $3.3 |
出力:テキスト+音声 | $62 | $17.7 |
無料枠 | 100万トークン | 100万トークン |
中国(北京)リージョンの料金
北京リージョンは、シンガポールより3〜4割ほど安く設定されています(公式ページのUSD換算表記)。
項目 | Plus | Flash |
|---|---|---|
入力:テキスト・画像・動画 | $0.96 | $0.3 |
入力:音声 | $7.29 | $2.48 |
出力:テキストのみ | $5.5 | $1.83 |
出力:テキスト+音声 | $29.29 | $9.9 |
北京ではバッチ推論(ファイルでまとめて処理)が入力・出力とも半額になります。ただし北京リージョンには無料枠の記載がなく、データは中国国内で処理されます。
料金に関する補足
- 無料枠: シンガポールリージョンで各モデル100万トークン。モデルの料金ページには有効期間の記載がないため、新規ユーザー向け無料枠のページで確認してください
- バッチ割引: 北京のみ。シンガポールはバッチ推論・コンテキストキャッシュに対応していません
- 料金の目安: テキストで100万トークン読み込み、20万トークン出力した場合、Plusは約$3.06($1.4+$1.66)、Flashは約$0.84($0.4+$0.44)です。音声1秒あたりのトークン数は公式の換算値を確認できなかったため、音声処理の費用は無料枠で実際に試して見積もるのが確実です
なお、ネット上の記事で見かける「テキスト入力$0.43」「音声入力$3.81」といった単価は前世代qwen3-omni-flashの料金で、3.5-Omniの料金ではありません。この単価をもとにした「GPT-4oの数分の1」という比較も成り立たないので注意してください。
使い方・始め方
出典: Alibaba Cloud Tongyi Qianwen (Qwen)
試すだけならQwen Chat、システムに組み込むならModel StudioのAPIを使います。
1. Qwen Chat(最も手軽)
Qwen ChatのWeb画面から、登録だけで音声・画像・動画を使ったやり取りを試せます。カスタム音声の作成はAPI専用で、Qwen Chatでは使えません。なお、後継の3.8系が出たあとにQwen Chatで3.5-Omniを選べるかどうかは、画面のモデル一覧で確認してください。
2. DashScope API(本番環境向け)
Alibaba Cloud Model StudioでAPIキーを発行し、OpenAI互換のエンドポイントから呼び出します。既存のOpenAI SDKのコードを流用でき、SDKはPython 1.52.0以上、Node.js 4.68.0以上が必要です。
使えるモデルIDは次の4つです(それぞれ -2026-03-15 付きの固定版もあります)。
qwen3.5-omni-plusqwen3.5-omni-flashqwen3.5-omni-plus-realtimeqwen3.5-omni-flash-realtime
リージョンは次の2つから選びます。
- シンガポール(International): 無料枠あり。日本から使う場合の第一候補
- 中国(北京): 料金が安く、関数呼び出しやバッチが使える。データは中国国内で処理される
Responses APIを使う場合、既定で会話内容が保存される設定(store=True)になっており、応答IDは7日で失効します。保存させたくない場合は、明示的に store=False を指定します。
3. Hugging Face・ModelScopeのデモ
技術レポートでは、Hugging FaceとModelScopeでオンラインデモが公開されていると案内されています。環境構築なしで性能を確かめたいときに使えます。
4. セルフホスティングはできない
Qwen 3.5-Omniの重みは公開されていないため、自社のGPUサーバーで動かすことはできません。ネット上にあるvLLMやtransformersで動かす手順は、前世代Qwen3-Omniのものです。
他のAIモデルとの比較
2026年10月時点で比べるべき相手は、後継のQwen3.8-Omni-Flashと、音声で会話できるGemini 3.8 Live・GPT-Live-1です。料金・コンテキスト・リージョンでは後継のQwen3.8-Omni-Flashがはっきり有利です。
総合比較表
料金の単位はUSD/100万トークンで、Qwenはシンガポールリージョンの値です。
比較項目 | Qwen3.5-Omni-Plus | Qwen3.5-Omni-Flash | Qwen3.8-Omni-Flash | Gemini 3.8 Live | GPT-Live-1 |
|---|---|---|---|---|---|
開発元 | Alibaba | Alibaba | Alibaba | OpenAI | |
公開時期 | 2026年3月 | 2026年3月 | 2026年9月 | — | — |
テキスト入力 | $1.4 | $0.4 | $0.15 | $0.75 | 音声セッション$0.05/分(別途モデル料金) |
音声入力 | $11 | $3 | $0.93(Realtime版) | $3.00 | 同上 |
音声出力 | $44 | $11.9 | $1.87(Realtime版) | $12.00 | 同上 |
コンテキスト | 256K | 256K | 100万 | — | — |
音声で返す | ○ | ○ | Realtime版のみ(通常版はテキスト出力) | ○ | ○ |
関数呼び出し | 北京の通常版とRealtime版 | 北京の通常版とRealtime版 | ○ | — | — |
東京リージョン | × | × | ○ | — | — |
重みの公開 | なし | なし | なし | なし | なし |
Gemini 3.8 LiveはGoogle公式の料金ページ、GPT-Live-1はOpenAIのモデルページの表記です。GPT-Live-1はAPIの一般提供状況について情報が食い違っているため、使う前に公式で確認してください。「—」は今回の確認範囲で比較できる公式の数字がない項目です。
後継Qwen3.8-Omni-Flashとの比較
2026年9月18日に公開されたQwen3.8-Omni-Flashは、Alibabaの発表では29の評価でQwen3.5-Omni-Plusを平均25%以上上回っています(自己申告)。テキスト入力は$0.15と、3.5-Omni-Flashの半額以下です。
比較項目 | Qwen3.5-Omni(Plus/Flash) | Qwen3.8-Omni-Flash |
|---|---|---|
コンテキスト | 256K | 100万 |
テキスト入力(シンガポール) | $1.4/$0.4 | $0.15 |
通常版の出力 | テキスト・音声 | テキストのみ(音声はRealtime版) |
リージョン | 北京・シンガポール | 北京・シンガポール・香港・東京・フランクフルト・バージニア |
関数呼び出し | シンガポールの通常版は不可 | 対応(JSONモード・Web検索も対応) |
新しく作るシステムなら、Qwen3.8-Omni-Flashを第一候補にして問題ありません。3.5-Omniを選ぶ理由が残るのは、次のような場合です。
- すでに3.5-Omniで組んだシステムがあり、移行の検証が済んでいない
- リアルタイムではない処理で、通常版のAPIから音声で返したい
- Plusのベンチマークで強い分野(音楽・中国語方言など)の精度を、後継と並べて比べたい
なお、Model Studio上でQwen3.5-Omniの提供終了は告知されていません(2026年10月21日時点)。
GPT-Live-1との比較
GPT-Live-1は、OpenAIのリアルタイム音声会話向けのモデルです。料金の数え方が「1分あたり」で、トークン単価のQwenとは単純に比べられません。
Qwen 3.5-Omniが優れている点
- 音声付きの動画をそのまま読み込んで理解できる
- 113言語・方言の音声認識、特に中国語方言に強い
- 長い音声(API上限で1ファイル3時間)をまとめて渡せる
GPT-Live-1が優れている点
- ChatGPTやOpenAIの他のAPIと組み合わせやすい
- 米国企業のサービスで、社内のセキュリティ審査を通しやすい場合がある
詳しくはGPT-Liveとはを参照してください。
Gemini 3.8 Live / Gemini 3.1 Proとの比較
Gemini 3.8 Liveのテキスト入力は$0.75で、Qwen3.5-Omni-Plus($1.4)より安くなります。音声入力$3.00・音声出力$12.00は、Qwen3.5-Omni-Flash($3・$11.9)とほぼ同じです。
Qwen 3.5-Omniが優れている点
- 技術レポート上、音声理解・音声対話・中国語方言でGemini 3.1 Proを上回る項目が多い
- 声のサンプルからカスタム音声を作れる
Geminiが優れている点
- ツールを使う課題(OmniGAIA)や一部の動画理解でGemini 3.1 Proが上回る
- Googleのサービスや検索との連携
- リージョンや企業向けの管理機能の選択肢が多い
Gemini 3.8 Liveの詳細はGemini 3.8 Liveとは、Geminiシリーズ全体はGeminiとは、同時通訳の用途ならGemini 3.5 Live Translateとはが参考になります。
Claudeとの違い
Claudeは、テキストと画像の理解やコーディングを得意とするAnthropicのモデルで、音声で返すモデルではありません。用途が違うため、文章作成やコードの比較はClaudeとはを参照してください。
セキュリティとデータ主権に関する注意点
出典: Alibaba Cloud Global Locations
日本の企業が使う場合、データはシンガポールか中国(北京)で処理されるため、社内の規程と個人情報の越境移転のルールを先に確認する必要があります。
データ処理リージョンの選択肢
リージョン | データの処理場所 | 無料枠 | 関数呼び出し(通常版) | バッチ |
|---|---|---|---|---|
シンガポール(International) | シンガポール | あり(100万トークン) | × | × |
中国(北京) | 中国国内 | 記載なし | ○ | ○(半額) |
東京・米国・EUのリージョンはありません。データを日本国内に置く必要がある業務では、3.5-Omniは使えません。東京リージョンが必要なら、後継のQwen3.8-Omni-Flashが候補になります。
公式のセキュリティ対応
Model Studioの公式ドキュメントで、Qwen 3.5-Omniについて確認できたのは次の点です。
- Responses APIは既定で会話内容を保存する(
store=True)。応答IDは7日で失効する - 処理されるリージョンは、北京かシンガポールのどちらか選んだほう
「入力データを学習に使わない」「VPC・PrivateLink対応」といった点は、Qwen 3.5-Omni固有の公式記述としては確認できませんでした。社内審査に使う場合は、Alibaba Cloudの利用規約とデータの取り扱いページを直接確認してください。
導入時に検討すべきこと
- 社内のセキュリティポリシー: 中国企業のクラウドサービスの利用が認められているか。中国発AIの全般的な注意点はDeepSeekとはでも整理しています
- 個人情報の越境移転: 顧客の通話録音などを海外リージョンに送る場合、個人情報保護法上の手続きが必要か
- 声のなりすまし対策: カスタム音声は詐欺やなりすましに悪用される危険がある。本人の同意を取った声だけを使うなどの運用ルールを決める
- ベンチマークの扱い: 性能の数字はAlibabaの自己申告。自社のデータで試してから判断する
- 生成AI全般のリスク: 情報漏えいやプロンプトインジェクションへの対策は生成AIのセキュリティリスクと対策にまとめています
コールセンターの通話分析や動画マニュアルの検索のように、Qwen 3.5-Omniを自社の業務システムに組み込む場合は、API料金だけでなく、録音データの受け渡しや既存システムとの連携の開発費もかかります。組み込みの進め方と費用の目安はAI開発の費用相場【2026年10月】AI受託開発の改修・PoC・本開発の価格と見積の内訳で確認できます。
こんな方におすすめ / おすすめしない方
Qwen 3.5-Omniは、中国語を含む多言語の音声や、音声付き動画をまとめて理解させたい人に合います。日本国内にデータを置きたい人、自社サーバーで動かしたい人には合いません。
Qwen 3.5-Omniがおすすめな方
- 中国語や方言を含む多言語の音声を扱う: 113言語・方言の認識に対応し、中国語方言のスコアが特に高い
- 長い音声や音声付き動画をまとめて理解させたい: 文字起こしやコマ抽出の手間を省ける
- すでに3.5-Omniでシステムを組んでいる: 提供終了の告知はなく、当面はそのまま使える
- 音声で返すAPIを、リアルタイムではない処理で使いたい: 通常版でテキスト+音声を出力できる
おすすめしない方
- データを日本国内に置く必要がある: 東京リージョンがない。後継のQwen3.8-Omni-Flashを検討する
- 自社サーバーで動かしたい・追加学習したい: 重みが公開されていない
- 画像や動画を作りたい: 出力はテキストと音声だけ
- 外部システムと連携するエージェントを、シンガポールの通常版で作りたい: 関数呼び出しが使えない
- とにかく安く音声AIを使いたい: 料金はQwen3.8-Omni-FlashのRealtime版のほうが大幅に安い
目的別の選び分け
やりたいこと | おすすめ |
|---|---|
新しく音声エージェントを作る | Qwen3.8-Omni-Flash(Realtime版)、またはGemini 3.8 Live |
中国語方言を含む音声を高精度で聞き取る | Qwen3.5-Omni-Plus |
長い音声付き動画の内容を理解させる | Qwen3.5-Omni-Plus/Flash、または100万トークン対応のQwen3.8-Omni-Flash |
データを東京リージョンに置く | Qwen3.8-Omni-Flash |
自社サーバーで動かす | 重みが公開されているモデル(Qwen3.8-27Bなど) |
画像を作る | Qwen-Image-3.0などの画像生成モデル |
ほかの生成AIツールと広く比べたい場合は、生成AIツールおすすめ比較が参考になります。
よくある質問(FAQ)
Q1. Qwen 3.5-Omniは日本語に対応していますか?
対応しています。音声認識・音声生成ともに日本語が対象言語に含まれ、56種類の標準の声の多くが日本語を話せます。ただし、日本語専用に作られた声はなく、日本語の認識精度についての公式の個別データもありません。敬語や固有名詞の読み上げが業務に耐えるかは、無料枠で実際の音声を使って確かめるのが確実です。
Q2. 無料で使えますか?
Qwen Chatでの試用は無料です。APIはシンガポールリージョンで各モデル100万トークンの無料枠があり、使い切ったあとは従量課金になります。重みが公開されていないため、自分のPCやサーバーで無料で動かす方法はありません。
Q3. Qwen 3.5-Omni Lightはどこで使えますか?
2026年10月時点では使えません。公式ブログで3つのサイズの1つとして発表されましたが、Model StudioのAPIにもHugging Faceにも公開されていません。今後の提供予定も公表されていません。
Q4. 前世代のQwen3-Omniとの主な違いは?
音声認識の言語が19から113に、音声生成の言語が10から36に増え、カスタム音声や割り込み判定などの機能が加わりました。大きく変わったのは公開の方針で、前世代は重みがApache 2.0で公開されていましたが、3.5-OmniはAPIとQwen Chatだけで提供されています。自社サーバーで動かしたいなら、今も前世代のQwen3-Omni-30B-A3Bが候補になります。
Q5. Qwen3.6-PlusやQwen3.8-Maxとの違いは?
「Omni」は音声・動画の入出力を中心にしたモデルの系列で、PlusやMaxはテキストやコード、エージェント用途を中心にした汎用モデルの系列です。文章作成やコーディングが主な用途なら、Qwen3.6-PlusとはやQwen3.8-Max-Previewとはを参照してください。
Q6. データは中国に送信されますか?
シンガポールリージョンを選べば、データはシンガポールで処理されます。北京リージョンを選ぶと中国国内で処理されます。Qwen 3.5-Omniには日本・米国・EUのリージョンがないため、データを国内に置く必要があるなら、東京リージョンに対応したQwen3.8-Omni-Flashなど別のモデルを検討してください。
まとめ
Qwen 3.5-Omniは、テキスト・画像・音声・動画をまとめて理解し、テキストと音声で答えるAlibabaのモデルです。113言語・方言の音声認識、音声付き動画の一括理解、音声対話のベンチマークの高さが強みです。
一方で、2026年10月時点の注意点は次のとおりです。
- APIで使えるのはPlus(テキスト入力$1.4)とFlash($0.4)で、Lightは提供されていない
- 重みは公開されておらず、セルフホストはできない
- リージョンは北京とシンガポールのみで、シンガポールの通常版では関数呼び出しが使えない
- 後継のQwen3.8-Omni-Flashのほうが安く、コンテキストが長く、東京リージョンもある
すでに3.5-Omniを使っている、または中国語方言や音声付き動画の理解で精度を比べたい場合には今も有力な選択肢です。 新しく導入するなら、まずQwen3.8-Omni-Flashと並べて試すのがおすすめです。
関連記事
依頼範囲と費用の目安を30分で整理します
この記事の著者

AI革命
編集部
AI革命株式会社の編集部です。最新のAI技術動向から実践的な導入事例まで、企業のデジタル変革に役立つ情報をお届けしています。豊富な経験と専門知識を活かし、読者の皆様にとって価値のあるコンテンツを制作しています。
最新記事
Gemini 4 Neonとは?料金・性能・使い方とCarbon・Hydrogenとの違いを解説【2026年11月】
2026/11/19
Anthropic IPOの公開価格は83ドルと報道|円換算・仮条件との差・初値との違いを整理
2026/11/19
電力・ガス・水道のAI活用事例【2026年】需要予測・スマートグリッドの国内実例と導入コスト
2026/05/05
コンサルティング業界のAI活用事例【2026年11月】最も効く業務・費用相場・国内事例・導入手順
2026/07/05
畜産業のAI活用事例【2026年最新】牛・豚・鶏の導入例と費用・補助金・防疫対策
2026/07/16
食品業界のAI活用事例【2026年】HACCP自動化・需要予測・品質検査を製造から外食まで整理
2026/04/21

