GitHub Project HydraFusionとは?複数モデル自動オーケストレーションの実力・料金・Copilot CLIでの使い方【2026年10月最新】
この記事のポイント
GitHub Project HydraFusionは、タスクごとに複数のAIモデルを自動で組み合わせるGitHub Copilotの研究プレビュー機能です。「Opus 5比でコスト67%減」の読み方、AI Creditsでの課金、Copilot CLI・VS Code・Copilotアプリでの使い方と、企業で使う前に確認したい制約をまとめました。
Project HydraFusion(ハイドラフュージョン)は、GitHubが2026年9月4日に発表したGitHub Copilotの研究プレビュー機能です。リクエストごとに「どのモデルをどう組み合わせて解かせるか」をGitHub側が自動で決めます。ユーザーはモデル一覧から「HydraFusion」を1つ選ぶだけで、裏では複数ベンダーのモデルが下書き・品質判定・レビュー・修正を分担します。最初はCopilot CLIだけでしたが、2026年9月30日からVS CodeとGitHub Copilotアプリでも使えます。
GitHubの公表値では、TerminalBench 2.1でClaude Opus 5単体に比べて推定コスト67%減、品質+4.9ポイントでした。ただ、これは3つのベンチマークのうち最も良かった1つの結果です。残りの2つでは「コストは大きく下がり、品質はわずかに下」でした。比較したのはOpus 5.5が出る前のOpus 5なので、「どんな場面でもOpus 5を超える」とまでは言えません。
この記事でわかること
- HydraFusionと従来のモデル選択・Auto(自動モデル選択)の違い
- 3つの実行パターン(Single / Cascade / Critique)の動き方
- ベンチマーク3種の数値と、「67%減」をどう読めばよいか
- GitHub AI Creditsでの課金のされ方と、
/usageを使ったコストの測り方 - Copilot CLI・VS Code・Copilotアプリでの有効化手順と、選択肢に出てこないときの確認ポイント
- 組織のモデルポリシーやデータの扱いなど、企業で使う前に確認したいこと
想定読者: GitHub Copilotを業務で使っているエンジニア、AIコーディングのコストを見直したいテックリード、社内でCopilotの利用範囲を決める情報システム・セキュリティ担当者。
※HydraFusionは研究プレビューです。GitHubは「結果・モデル・ワークフロー・提供範囲・名称・挙動は変わることがある」と明記しており、SLA(稼働保証)もありません。
Project HydraFusionとは?基本情報
HydraFusionは、GitHub Copilotに加わった実行時のマルチモデル・オーケストレーションの仕組みです。公式ブログは「runtime orchestration(実行時オーケストレーション)でフロンティア級の品質を出す」と説明し、GitHubにとっての「最初の賭け(our first bet)」と位置づけています。
項目 | 内容 |
|---|---|
正式名称 | Project HydraFusion(モデル一覧では「HydraFusion (Research Preview)」) |
開発元 | GitHub(Microsoft傘下) |
発表日 | 2026年9月4日 |
提供形態 | GitHub Copilotの「モデル選択肢の1つ」(研究プレビュー。SLAなし) |
使える場所 | Copilot CLI(2026年9月4日〜)、VS Code 1.140以降またはInsiders・GitHub Copilotアプリ(2026年9月30日〜) |
対象プラン | Pro・Pro+・Business・Enterpriseは明記あり。Free・Student・Maxは資料によって記載が違い、確定していない |
追加料金 | なし(内部で使った各モデルの標準レートでAI Creditsを消費) |
組織での管理 | 管理者のプレビュー機能の許可と、モデルポリシーの設定が反映される |
GitHub Copilot全体については「GitHub Copilotとは」で整理しています。HydraFusionはCopilotに代わる新製品ではありません。いつものCopilotで選べるモデルの選択肢が1つ増えた、と考えるとわかりやすいでしょう。
CLI限定ではなくなり、3つの環境で選べる
発表直後はCopilot CLI専用でしたが、2026年9月30日のGitHub ChangelogでVS Code(1.140以降またはInsiders)とGitHub Copilotアプリへの展開が告知されました。10月1日公開のVS Code 9月リリースのまとめにも、Agentsウィンドウの機能として載っています。デスクトップアプリ自体については「GitHub Copilot Appとは」を参照してください。
なお、GitHubにはこれと関係のない同名リポジトリ(自動運転のセンサーフュージョン研究「AICPS/hydrafusion」)もあります。検索するときは「GitHub Copilot HydraFusion」と打つと混同しにくくなります。
モデルを「選ぶ」から「組み立てる」へ変わった
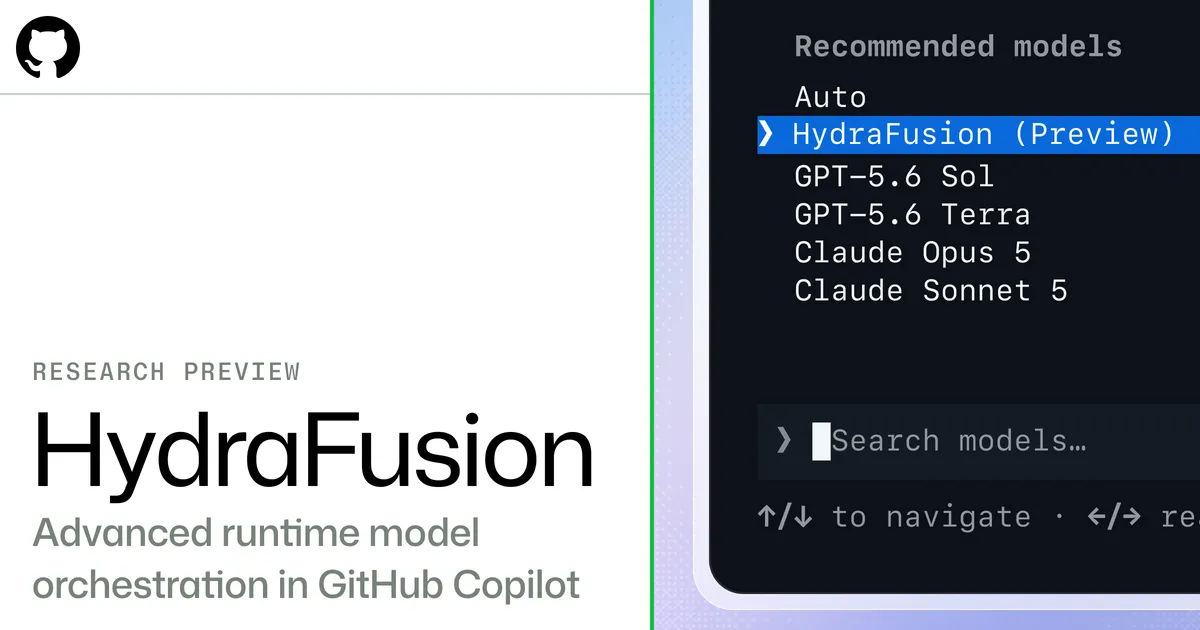
出典: The GitHub Blog「Project HydraFusion」
HydraFusionで変わるのは、モデルを1つ選ぶ方式から、タスクごとに解き方を組み立てる方式になる点です。これまでのCopilotでは、ユーザーがGPT系・Claude系・Gemini系などから1つを選び、そのモデルが最初から最後までタスクを担当していました。
HydraFusionでは、GitHub側がプロンプトを解析し、そのタスク用の実行計画をその場で組み立てます。計画には「どのモデルに下書きさせるか」「品質をどう判定するか」「足りなければどのモデルに引き継ぐか」が入ります。公式ブログはこれを「最良のモデルを選ぶことから、タスクごとに最良の解き方を動的に組み立てることへ」と表現しています。
比較項目 | 従来のモデル選択(手動) | Auto(自動モデル選択) | HydraFusion |
|---|---|---|---|
決めるのは誰か | ユーザー | GitHub(自動) | GitHub(自動) |
何を選ぶか | モデル1つ | リクエストごとにモデル1つ | リクエストごとにワークフロー |
1ターンで動くモデル数 | 1つ | 1つ | 1〜複数(タスク次第) |
使うモデルの指定 | できる | できない | できない(組織のモデルポリシーで範囲は絞れる) |
有料プランの割引 | なし | モデルコストが10%引き | 対象外 |
途中経過の見え方 | 通常どおり | 通常どおり | ステップと進捗は表示される。下書きの本文は表示されない |
Autoとの違いは、2026年9月30日のChangelogで公式に説明されています。Autoはリクエストごとにモデルを1つ選び、HydraFusionはワークフローを選んで1ターンの中で複数のモデルを使えます。公式ブログによれば、HydraFusionはAutoの上に作られています。TechTargetは、推論・コード生成・デバッグ・ツール利用の観点でプロンプトを採点する既存のルーティング基盤「HyDRA」がベースだと報じています。
ルーティングの方針は「品質の目標を満たせそうなワークフローのうち、最も単純なものを選ぶ」です。モデルを追加で呼び出すのは、タスクがそれを必要とするときだけです。毎回いちばん強いモデルを使うのではなく、必要なときだけ強いモデルに回す作りで、GitHubが示すコスト削減はこの設計から来ています。
3つの実行パターン(Single / Cascade / Critique)
出典: The GitHub Blog
現時点で公開されている実行パターンは3つです。プロンプトごとに自動で選ばれ、同じセッションの中でもプロンプトによってパターンが変わることがあります。ユーザーが手動でパターンを指定することはできず、切り替えの基準も公開されていません。
パターン | 動き方 | 向いているタスク | 職場にたとえると |
|---|---|---|---|
Single(単一) | 選ばれた1つのモデルがそのまま解く | 単純でリスクの低い作業。速さと効率を優先 | 担当者が1人で片づける |
Cascade(カスケード) | 効率のよいモデルが下書き → 品質ゲートが合否を判定 → 足りなければ強いモデルに引き継ぐ | コストを抑えたい中程度のタスク | まず若手が書き、通らなければ上の人に回す |
Critique(批評) | 1つのモデルが下書き → 別のモデルファミリーの読み取り専用レビュアーが指摘 → 下書きモデルが1回だけ修正 | 見落としが響く難しいタスク | 別チームのレビューを1回挟んで直す |
Cascadeで大事なのは「品質ゲート」
Cascadeでは、下書きが合格基準を満たせばそこで終わります。狙いは、すべてのリクエストを最上位モデルに流すのをやめることです。単純な作業にOpus級のモデルを使うと割高になります。安いモデルで済む作業を安いモデルで終わらせる分が、コスト削減の大部分を占めます。
Critiqueでは「別のモデルファミリー」がレビューする
Critiqueでは、下書きを書いたモデルとは別系統のモデルがレビューします。同じファミリーのモデルは同じところを見落としやすいため、学習の背景が違うモデルに見せて、見落としを拾いやすくするという考え方です。
レビュアーはツールを持たない読み取り専用の環境で動き、リポジトリには手を出せません。修正するのは下書きを書いたモデルで、回数も1回だけです。やり取りが延々と続いて時間とクレジットがかさむことはありません。
ベンチマークで見る実力(「Opus 5超え」はどこまで本当か)
品質でClaude Opus 5を上回ったのは、公開された3つのベンチマークのうち1つだけです。コストは3つとも下がっていますが、下がり幅は36〜67%と開きがあります。
ベンチマーク | 推定コスト(Opus 5比) | 品質(Opus 5比) |
|---|---|---|
TerminalBench 2.1 | 67%減 | +4.9ポイント(上回る) |
DeepSWE | 36%減 | −1.5ポイント(わずかに下回る) |
CheckpointBench(GitHub社内。実際のCopilotセッションを公開リポジトリの固定コミットで再現) | 65%減 | −0.1ポイント(ほぼ同じ) |
品質は「正解と確認できたタスクの割合」です。コストは下書き・レビュー・修正・引き継ぎ・リトライ・フォールバックまで含めたワークフロー全体の推定値です。reasoningの設定はどのモデルもmediumにそろえています。公式ブログではGPT-5.6 Solも比較対象に挙がっていますが、ここではOpus 5との差に絞って紹介します。
見出しによく使われる「67%減・Opus 5超え」は、TerminalBench 2.1という1つのベンチマークの結果です。GitHub自身は「評価したOpus 5のベースラインと同等以上の品質を、推定コストを抑えて出した」とまとめています。
数字を読むときの5つの注意点
- 品質でOpus 5をはっきり上回ったのはTerminalBench 2.1だけ。残りの2つは「ほぼ同じ〜わずかに下」で、コストと品質のトレードオフが見える
- TerminalBench 2.1は比較的飽和しているとGitHub自身が書いており、そのためDeepSWEを加えた
- コストは推定値で、実際の請求額そのものではない
- GitHub自身によるオフライン評価である。結果はベンチマークの版・ワークフローの設定・使うモデルの組み合わせ・価格の前提で変わると、公式も注記している
- 比較したのはOpus 5。その後Copilotには上位のClaude Opus 5.5やGPT-6系が加わっており、現行の最上位モデルとの比較ではない
比較対象になったモデルは「Claude Opus 5とは」、その後継は「Claude Opus 5.5とは」で解説しています。当時の最上位クラスに「コスト3分の1前後で並び、一部では勝つ」と示した点は注目に値します。ただし「いつでもOpus 5より賢く、いつでも3分の1のコスト」と受け取るのは誤りです。自社のコードで同じ結果が出る保証もありません。
料金とGitHub AI Creditsの関係
出典: GitHub Copilot 料金プラン 公式ページ
HydraFusion自体に追加料金や専用プランはありません。 HydraFusionが内部で使った各モデルのトークン消費に、それぞれのモデルの標準レートを掛けた分だけ課金されます。
GitHub Copilotは2026年6月1日に、プレミアムリクエスト方式からGitHub AI Credits(1クレジット=$0.01)の使用量ベース課金に移りました。HydraFusionの消費もこのクレジット枠から引かれます。課金体系の詳細は「GitHub Copilot 使用量ベース課金とは|GitHub AI Creditsと料金変更ガイド」にまとめています。
公式ドキュメントでは、次の3点もはっきり書かれています。
- Autoの割引(有料プランでモデルコスト10%引き)は、HydraFusionには適用されない
- 複数のモデルを使うタスクは、1つのモデルで済むタスクよりAI Creditsを多く使うことがある
- CascadeとCritiqueは時間がかかり、クレジットも多めに使う。定型的な作業にはAutoを使うよう案内している
コミュニティのDiscussionでは、GitHubのスタッフが「HydraFusionは値引きしていない。成功する確率が上がるなら、あえて多めに使う設計だ」と答えています(2026年9月10日)。コストと品質のバランスを設定する機能や、モデル選択の制御は検討中とのことです。
現行プランと月間クレジット(公式ドキュメント・2026年10月時点)
プラン | 月額 | 月間AI Credits | 選べるモデル |
|---|---|---|---|
Copilot Free | 無料 | 枠あり(数値の記載なし) | Autoのみ |
Copilot Student | 無料(学生認証) | 枠あり(数値の記載なし) | Autoのみ |
Copilot Pro | $10 | 1,500(基本1,000+flex 500) | 一部のモデル |
Copilot Pro+ | $39 | 7,000(基本3,900+flex 3,100) | プレミアムモデル |
Copilot Max | $100 | 20,000(基本10,000+flex 10,000) | プレミアムモデル(優先アクセス) |
Copilot Business | $19/席 | 1,900/ユーザー | プレミアムモデル |
Copilot Enterprise | $39/席 | 3,900/ユーザー | プレミアムモデル(優先アクセス) |
※コード補完やNext Edit SuggestionsはAI Creditsを消費しません。チャット・エージェント・コードレビューなどが消費の対象です。
HydraFusionを使えるプランは資料によって記載が違う
対象プランの書き方は、公式の資料ごとに違います。現時点では断定せず、自分の環境で確かめるのが確実です。
資料 | 記載 |
|---|---|
GitHub Blog(2026年9月4日、CLI向け) | すべてのGitHub Copilotプラン |
GitHub Changelog(2026年9月30日、VS Code・アプリ向け) | Copilot Pro、Pro+、Business、Enterprise(Free・Student・Maxの記載なし) |
公式ドキュメント(early access) | HydraFusionが使うモデルのうち少なくとも1つがプランで使え、組織やEnterpriseのモデルポリシーでも許可されている場合に、モデル一覧に表示される |
FreeとStudentはAutoしか選べないため、HydraFusionを明示的に選べない可能性が高いものの、公式には確定していません。Maxは上位プランなので使える可能性が高いとはいえ、こちらも明記はありません。CLIなら/model、VS Codeやアプリならモデル一覧に「HydraFusion」が出るかどうかで判断してください。
「安くなる」を2つの層に分けて考える
HydraFusionのコストは、次の2つを分けて考えないと誤解しやすくなります。
層 | 何が起きるか | 方向 |
|---|---|---|
1リクエストあたりの消費 | Cascade・Critiqueが動くと、1回のリクエストで複数のモデルが動く。下書き・品質判定・レビュー・修正の分だけトークンが増える | 増えることがある |
タスクを終えるまでの総コスト | 単純なタスクは安いモデルで終わり、最上位モデルを呼ぶ回数が減る。やり直しも減る | 下がることがある |
GitHubが示す36〜67%の削減は後者、つまりタスクを終えるまでの総コストの話です。HydraFusionを選べば毎回のリクエストが安くなる、という意味ではありません。さらにAutoの10%割引も効かないため、定型作業ではAutoのほうが安く済む場面が多いと考えておくのが無難です。
コストを実際に測る方法
- CLIでは
/usageでモデルごとのクレジット消費を見られます(Copilot CLI 1.0.85、2026年9月16日の変更)。HydraFusionの中でどのモデルがどれだけ使ったかを確かめられるので、Autoや固定モデルで同じタスクを解いた場合と比べてみてください - チーム全員で一斉に切り替えず、まず数人で1〜2週間、消費の傾向を見るのが安全です。クレジット枠を使い切ると、追加課金か機能制限になります
- 公式ドキュメントは、メインの会話はなるべく1つのモデルに保ってキャッシュを効かせ、レビュアーなどの補助モデルには必要な文脈だけを渡す設計だと説明しています。長い会話を何度も切り替えると、この効果が薄れます
- ほかのAIコーディングツールと併用しているなら、「生成AI料金比較」で全体の費用感も確認しておくと判断しやすくなります
Copilot CLIでのHydraFusionの使い方
出典: github/copilot-cli 公式リポジトリ
Copilot CLIでは「CLIを入れる」「実験的機能をオンにしてHydraFusionを選ぶ」の2段階で使い始められます。前提として、有効なCopilotのサブスクリプションが必要です。組織やEnterpriseの管理者がCLIを無効にしている場合は使えません。
手順1: GitHub Copilot CLIをインストールする
環境に合わせて、どれか1つを実行します。
# npm(Node.js 22以降が必要)
npm install -g @github/copilot

# Homebrew(macOS / Linux)
brew install --cask copilot-cli

# WinGet(Windows。PowerShell v6以降が必要)
winget install GitHub.Copilot

# インストールスクリプト(macOS / Linux)
curl -fsSL https://gh.io/copilot-install | bashnpmの設定でignore-scripts=trueにしている場合は、npm_config_ignore_scripts=false npm install -g @github/copilotで入れます。
インストール後はターミナルでcopilotと打つと起動します。初回はセッション内で/loginを実行し、GitHubアカウントで認証します。CIなどでトークンを使うときは、個人アカウントのfine-grained PATに「Copilot Requests」権限を付け、COPILOT_GITHUB_TOKEN・GH_TOKEN・GITHUB_TOKENのどれかに設定します(読み込まれる優先順もこの順です)。
手順2: HydraFusionを有効にして選ぶ
copilot update            # CLIを最新版にする(セッション内なら /update)
copilot --experimental    # 実験的機能をオンにして起動
                          #(セッション内なら /experimental on → CLIを再起動)
/model                    # 一覧から「HydraFusion (Research Preview)」を選ぶ
/experimental onで切り替えた場合は、CLIを再起動してから反映されます。一覧に出てこないときは/update prereleaseでプレリリース版に更新してください(プレリリース版は安定性が下がることがあります)。
1回だけのプロンプトを投げる場合は、起動オプションでも指定できます。公式ドキュメントに手順として載っています。
copilot --experimental --model hydrafusion -p "このリポジトリの失敗しているテストを直して"発表直後に「--model hydrafusionが効かない」という報告がありましたが、これは--experimentalを付けずに指定したケースです。現在は--experimentalと組み合わせればスクリプトからも呼び出せます。
VS Code・GitHub Copilotアプリで使う場合
2026年9月30日から、CLI以外の2つの環境でも選べるようになりました。
環境 | 必要なもの | 有効にする方法 |
|---|---|---|
Copilot CLI | 最新版のCLI |
|
VS Code | VS Code 1.140以降、またはVS Code Insiders | Copilot Chatのモデル一覧で「HydraFusion」を選ぶ。出てこなければ設定 |
GitHub Copilotアプリ | 最新版のアプリ | Settings > ExperimentalでHydraFusionをオン(設定画面で「HydraFusion」と検索しても見つかる)→ モデル一覧で選ぶ |
9月30日のリリースでは、ワークフローの各ステップの表示、進捗の更新頻度、長いタスクの実行中の状態表示も改善されました。
選択肢に出てこないときの確認順
- バージョン: CLIは
copilot update、VS Codeは1.140以降か、アプリは最新版か - 実験的機能の設定: CLIの
--experimental(切り替えたあとに再起動したか)、VS Codeのchat.copilot.hydraFusion.enabled、アプリのSettings > Experimental - 管理者の許可: 組織・Enterpriseのアカウントでは、管理者がプレビュー機能を許可している必要がある
- モデルポリシー: HydraFusionが使うモデルが組織のポリシーで1つも許可されていないと、一覧に表示されない
- プラン: Free・Studentでは出てこない可能性がある
- CLIのプレリリース版: ここまで確認しても出なければ
/update prereleaseを試す
つまずきやすいポイント
- planモード: 2026年9月、「planモードでHydraFusionに切り替えると、直前のモデルに戻る」という報告があり、GitHubのスタッフが不具合として認めて調査中と回答しました。その後「plan→agentモードの切り替えで解消した」という利用者の報告もありますが、修正されたかどうかは公式には確認できていません
- コンテキストの上限: HydraFusionのコンテキストウィンドウは、使うモデルの中で最も小さい上限に合わせた控えめな値になります。長い会話の途中で切り替えるときは、先にcompact(会話の圧縮)をしておいてください
- サブエージェントは起動しない: HydraFusionはサブエージェントとは別に動き、自分からサブエージェントを起動することはありません。作業を複数のサブエージェントに分ける使い方には向きません
- 捨てられた下書きの編集は元に戻らない: 途中で採用されなかった下書きがファイルを書き換えていても、自動では戻りません。コミット前に必ず差分を確認してください
GitHubが勧める使い方
公式が想定しているのは「substantial, well-scoped first-turn coding tasks」、つまりある程度の規模があり、範囲がはっきりした、最初の1ターンで投げるタスクです。
- 「この仕様どおりにモジュールを1つ実装して」のように、要件が文章で完結する実装の依頼
- 失敗しているテストの原因を調べて直す作業
- 既存の関数のリファクタリングを1回で仕上げる依頼
何十ターンもやり取りしながら仕様を固める使い方は、まだ最適化の途中とされています。マルチターンへの対応は、次の重点としてロードマップに挙がっています。
実際に試すときの手順例
- 作業ツリーをクリーンにし、検証用のブランチを切る(基準のコミットを控えておく)
- 範囲のはっきりしたタスクを1つ選び、HydraFusionで1ターン目に投げる
git diffで変更をすべて確認し、テストをもう一度実行する/usageでモデルごとのクレジット消費を記録する- 同じタスクをAutoや固定モデルでも解かせ、品質とクレジットを比べる
現時点の制約とハマりどころ
研究プレビューなので、割り切って使うべき制約がいくつかあります。公式ドキュメントとブログに書かれている内容を、仕事への影響と合わせて並べました。
制約 | 内容 | 仕事への影響 |
|---|---|---|
研究プレビュー・SLAなし | 本番のワークロード向けではない。名称・挙動・提供範囲が変わることがある | 本番の自動化パイプラインに組み込むのはまだ早い |
モデルを個人で指定・除外できない | 固定のモデル一覧はなく、新モデルの追加や評価に応じて構成が変わる。範囲を絞れるのは組織のモデルポリシーだけ | 個人単位では「このモデルは避けたい」ができない |
下書きの本文は表示されない | ステップと進捗は見えるが、最終的な回答だけが表示される | どの案が捨てられたかを細かく追えない |
捨てられた下書きの編集が残る | 不採用になった下書きによるファイル編集は自動で戻らない | コミット前の差分確認が必須 |
コンテキストは最小のモデルに合わせる | 使うモデルの中で最も小さい上限に合わせた控えめな値 | 大きなリポジトリの長い会話では先にcompactが必要 |
サブエージェントを起動しない | HydraFusionはサブエージェントとは別に動き、自分からは起動しない | 作業をサブエージェントに分けて並列で進める使い方には向かない |
マルチターンは最適化の途中 | 公式の推奨は1ターン目の単発タスク | 長い対話では効果が読みにくい |
時間がかかることがある | Cascade・Critiqueは複数のモデルを順に動かす | 定型作業はAutoのほうが速くて安い |
セルフホストできない | GitHubが運用するマネージド機能としてのみ提供 | オンプレミス必須の環境では選べない |
モデルの入れ替わりが速い
使われるモデルの構成は公開されていませんが、Copilot自体のモデルは入れ替わりが速く、HydraFusionの中身もそれにつれて変わると考えられます。
- 2026年9月下旬〜10月上旬: Claude Opus 5.5、GPT-6 Sol / Luna、GPT-6.1 Sol、Claude Sonnet 5.5、Claude Haiku 5.5がCopilotに追加
- 2026年10月2日: Claude Opus 4.7、Gemini 3.5 Flash、Gemini 3.6 Flash、Kimi K2.7 Codeが廃止
- 2026年10月19日(予定): GPT-5.5、GPT-5.4、GPT-5.4 mini、GPT-5 mini、Gemini 3.7 Flash、Grok 4.5が廃止
10月上旬には利用者から「GPT-5.4が多く使われていた」という報告があり、Opus 5.5やGPT-6.1 Solを入れてほしいという要望も出ています。新しいモデルが入ったかどうかについて、GitHubからの回答はまだありません。GPT-5.4は10月19日に廃止される予定なので、近いうちに構成が変わる可能性が高いでしょう。ベンチマークの数値はこの入れ替わりより前の結果だという点も、頭に入れておいてください。
早期利用者から報告されている挙動
GitHubコミュニティのDiscussionには、次のような個人の報告が上がっています。すべての環境で起きるとは限りません。
- タスクが終わったあとも「Working」の表示が残ることがある
- キャンセルの反映が遅いことがある
- セッションによってはAI Creditsの消費が多い
invalid routing responseというエラーが出たことがある(2026年10月)
GitHubは9月30日のリリースで、ステップの表示と進捗の更新を改善しました。ただし下書きの本文は今も表示されないため、長いタスクでは「何をしているのか」までは見えにくいままです。
セキュリティと企業導入で確認すべきこと
企業で使うかどうかを決めるとき、いちばん大事なのは1つのタスクの内容が複数ベンダーのモデルに渡りうることと、それを組織のモデルポリシーでどこまで絞れるかの2点です。
組織のモデルポリシーで使うモデルを絞れる
公式ドキュメントによると、HydraFusionは組織・Enterpriseのポリシーで管理されるプレビュー機能で、管理者がオプトインする必要があります。さらにモデルポリシーで、HydraFusionが使うモデルを制限できます。許可されたモデルが1つもなければ、HydraFusion自体が一覧に表示されません。10月には「組織でモデルの利用を絞ったら、アプリからHydraFusionが消えた」という利用者の報告もあり、ポリシーが反映されていることがうかがえます。
個人が「このモデルを外して」と指定することはできませんが、組織としては許可したモデルの範囲で動かせると読めます。発表当初に言われた「特定のベンダーを避けたい組織は使えない」ほど厳しい状況ではありません。
一方で、次の点は公式に明文化されていません。
- 許可していないモデルには一切送られないことの保証: Discussionでは「Enterpriseのモデルポリシーとデータ処理契約(DPA)は全フェーズに適用されるのか」「有効にしたモデル一覧を必ず守るのか」という質問が出ていますが、スタッフの回答はまだありません
- HydraFusion固有のデータの扱い: 補助のモデルには必要な文脈だけを渡すと書かれていますが、保持期間や学習への利用など、HydraFusionだけの条件は記載がありません。Copilot全体の規約が適用されると考えるのが自然ですが、明記はされていません
公式が示す5つの安全策
GitHubは信頼性を保つための原則を5つ挙げています。
原則 | 内容 |
|---|---|
Complete accounting | リトライやフォールバックも含め、全ステップのコストと使用量を集計する |
Bounded execution | 各ステップにタイムアウトとキャンセルを設ける |
Isolated review | レビュアーはツールのない隔離された環境で動き、リポジトリを変更できない |
Fail-safe application | キャンセルされたときや検証に失敗したときは、パッチを適用しない |
Validated routing | 実行前に、ワークフローの定義・モデルの割り当て・フォールバック・可用性を確認する |
各ステップの役割・結果・コスト・所要時間はランタイム側で記録され、開発者には1つの回答と、権限を踏まえた1つの変更セットが返ります。中でも「Isolated review」は、レビュアーがレビュー対象を書き換えてしまう事態を構造的に防いでおり、マルチモデルの作りとしては堅実です。ただし採用されなかった下書きのファイル編集は残るため、安全策があっても差分の確認は省けません。
Copilot CLI全体の制約も確認する
- Copilot Business / Enterpriseのコンテンツ除外(content exclusion)は、まず先に設定しておきたい項目です。CLIでの扱いは公式ドキュメントで最新の記載を確認してください
- MCPサーバーの組織単位の制御や、信頼済みディレクトリの外での権限の扱いにも、CLI固有の注意点があります。導入前にCopilot CLIのドキュメントを読んでおくと安心です
- 学習データへの利用を制御したい場合は「GitHub Copilot 学習オプトアウト設定」、AIコーディング全般のリスクは「AIコーディングのセキュリティリスク」にまとめています
判断の目安
状況 | おすすめの使い方 |
|---|---|
個人のOSSプロジェクト・検証用のリポジトリ | 積極的に試してよい |
一般的な社内システムの開発(機密度は中程度) | 管理者がモデルポリシーを決めたうえで、一部のメンバーで試し、 |
顧客データや認証情報を含むコード | content exclusionとモデルポリシーを設定し、範囲を限って慎重に使う |
金融・医療などの規制業種、契約でモデルの提供元が決まっている場合 | DPAの適用範囲が明文化されるまで、研究プレビューの段階では使わないほうがよい |
Copilotのような既製ツールで使うのではなく、自社の業務システムに複数モデルの使い分けやAIによるコードレビューを組み込みたい場合は、連携のやり方と費用の見積もりから考えることになります。方法と費用の目安は「既存システムにAIを組み込む方法」で整理しています。
Rubber Duckからの系譜と、他のマルチモデル基盤との違い
出典: The GitHub Blog
HydraFusionは突然現れた仕組みではありません。Critiqueのもとをたどると、GitHubが2026年4月にCopilot CLIへ入れたRubber Duck(ラバーダック)に行き着きます。
Rubber Duckは、セッションで使っているモデルとは別のモデルファミリーにレビューさせる、Copilot CLIに組み込まれた機能です。レビュアーは読み取り専用で、ファイルの編集や環境を変えるコマンドは実行できません。バグ、ロジックの誤り、セキュリティの脆弱性、設計の欠陥、アンチパターン、性能のボトルネックを見て、スタイルや命名は対象外です。指摘は「blocking(直すべき)」「non-blocking」「提案」に分けて返されます。「Rubber duck your plan.」と頼むか、/rubber-duckで呼び出します。
2026年4月の発表時、GitHubは「Claude SonnetにRubber Duckを組み合わせると、SonnetとOpusの性能差の74.7%を埋めた」と報告しています。ただし当時の世代のモデルでの数字です。「別のモデルファミリー×読み取り専用×中身のある問題だけを見る」という設計が、HydraFusionのCritiqueにそのまま引き継がれています。
Auto・HydraFusion・固定モデル・Rubber Duckの使い分け
Copilotの中だけでも、モデルの使い方は4通りあります。業務でどう使い分けるかの目安をまとめました。
使い方 | 誰がモデルを決めるか | コストの特徴 | 向いている場面 |
|---|---|---|---|
Auto | GitHub(リクエストごとに1つ) | 有料プランは10%引き。最も読みやすい | 日常の定型作業、短い質問、小さな修正 |
HydraFusion | GitHub(タスクごとにワークフロー) | 割引なし。1回の消費は増えることがあるが、完了までの総額は下がることがある | 範囲のはっきりした、重めの単発タスク |
モデルを固定 | ユーザー | モデルの単価どおり。予測しやすい | 監査のために使うモデルを固定したい、特定のモデルの癖に合わせたい |
Rubber Duck | 主モデルはユーザー、レビュアーはCopilot | 主モデル+レビュー分 | 主モデルは自分で選び、計画や実装に別系統のチェックを足したい |
CLI 1.0.87(2026年9月21日)では、すべてのモデルファミリーと低コストのセッションモデルでRubber Duckが使えるようになりました。「主モデルは安めに固定して、Rubber Duckでレビューを足す」構成も現実的な選択肢です。
他のマルチモデル・オーケストレーションとの違い
複数のモデルを組み合わせる仕組みはほかにもあります。違いは誰がルーティングを決めるかと、どこで動くかです。
サービス | 誰がモデルを決めるか | 主な用途 | 提供形態 |
|---|---|---|---|
HydraFusion | GitHubが自動で決める(組織はモデルポリシーで範囲を絞れる) | Copilot CLI・VS Code・Copilotアプリでのコーディング | Copilotに組み込み・マネージド |
ユーザー・開発者が指定(自動ルーティングも選べる) | 多数のモデルを1つのAPIで使う | API | |
複数のLLMを自動で組み合わせる | 汎用の複数モデル協調 | 独立したサービス | |
単一モデルの固定(従来のCopilot) | ユーザーが手動で選ぶ | 汎用 | Copilotに組み込み |
HydraFusionの特徴は、ルーティングの設計をユーザーからGitHubへすっかり引き取ったことです。自分でルーターを組みたい人には物足りませんが、「速く安く、そこそこうまく解いてほしい」人には最も手間がかかりません。TechTargetの記事では、アナリストが「トークンのコストは開発者の大きな負担で、モデルルーターは大きな節約になりうる」と評価する一方、「LLMは結果の一貫性を制御しにくく、実際に運用するまで価値は測りにくい」という慎重な声も紹介されています。OpenRouterの周辺の動きは「StripeによるOpenRouter買収」でも取り上げています。
他のCLIコーディングエージェントとの関係
Copilot CLIのほかにも、Claude Code、Gemini CLI、xAI Grok Buildなどのターミナル型エージェントがあります。HydraFusionは「Copilotを使う場合の、新しいモデルの選択肢」で、エージェント自体を乗り換える話ではありません。ツール全体を比べている段階なら、「AIコーディングツールおすすめ比較」から読むと整理しやすいはずです。
こんな人におすすめ
HydraFusionは誰にでも合う機能ではありません。合う人と合わない人ははっきり分かれます。
おすすめできる人
- すでにGitHub Copilot(CLI・VS Code・アプリのどれか)を日常的に使っているエンジニア。追加の導入作業はほとんどなく、設定を1つオンにするだけで試せる
- AIコーディングのクレジット消費を減らしたいチーム。単純な作業にまで最上位モデルを使っている自覚があるなら、削れる余地は大きい
- 範囲のはっきりした単発タスクをよく投げる人。GitHubが勧める使い方と一致する
- モデル選びに時間をかけたくない人。どのモデルが速くて安いかを毎回考える手間が減る
- 新しい機能を早めに試して社内に共有する役割の人。
/usageでモデル別の消費を測り、Autoとの比較データを集めておく価値がある
おすすめしない人
- 契約や規制でモデルの提供元が決まっている組織。モデルポリシーで範囲は絞れるものの、DPAが全ステップに適用されるかは明文化されていない
- 定型作業がほとんどの人。Autoの10%割引が効かず、時間もかかりやすいので、Autoのほうが合う
- どのモデルが何を書いたかを細かく監査する必要があるチーム。モデル別の消費は見えても、下書きの中身は見えない
- 長い対話を重ねて仕様を詰める使い方が中心の人。マルチターンはまだ最適化の途中
- サブエージェントやplanモードを軸にワークフローを組んでいる人。HydraFusionはサブエージェントを起動せず、planモードでは不具合の報告がある
- 本番の自動化パイプラインに組み込みたい人。SLAがなく、仕様が変わる可能性も明示されている
HydraFusionで試作したツールを、社内の実データや既存システムにつないで業務で使う段階では、権限・ログ・テストの設計が別に必要になります。この段階を外部に頼む場合の範囲と進め方は、AI受託開発・AIシステム開発のページで紹介しています。
よくある質問
Q. HydraFusionを使うと追加料金はかかりますか?
A. HydraFusion専用の料金や追加料金はありません。内部で使った各モデルのトークン消費に、それぞれの標準レートを掛けた分がAI Creditsから引かれます。ただし有料プランのAutoに付く10%割引はHydraFusionでは効きません。複数のモデルが動く分、1回あたりの消費はAutoや単一モデルより多くなることがあります。
Q. 無料プラン(Copilot Free)でも使えますか?
A. 公式の資料で書き方が違うため、断定はできません。9月4日のブログは「すべてのプラン」、9月30日のChangelogは「Pro・Pro+・Business・Enterprise」と書いています。FreeはAutoしか選べないので、HydraFusionを選べない可能性が高いと考えられます。CLIの/modelやVS Codeのモデル一覧に表示されるかで確かめてください。
Q. どのモデルが使われたか確認できますか?
A. Copilot CLIでは/usageで、モデルごとのAI Credits消費を確認できます(CLI 1.0.85以降)。ただし使うモデルを個人で指定・除外することはできず、使われうるモデルの一覧も公開されていません。範囲を絞りたい場合は、組織の管理者がモデルポリシーで設定します。
Q. VS Codeでは使えますか?
A. 使えます。2026年9月30日から、VS Code 1.140以降またはVS Code Insidersで、Copilot Chatのモデル一覧から選べます。一覧に出てこなければ、設定chat.copilot.hydraFusion.enabledをオンにしてください。組織のアカウントでは、管理者がプレビュー機能を許可している必要があります。
Q. 本当にClaude Opus 5より優秀なのですか?
A. 3つのベンチマークのうち、品質でOpus 5を上回ったのはTerminalBench 2.1(+4.9ポイント)だけです。DeepSWEは−1.5ポイント、CheckpointBenchは−0.1ポイントでした。コストは3つとも36〜67%下がっているので、「ほぼ同じ品質を大幅に安く出せる」という理解が実態に近いでしょう。これはGitHub自身のオフライン評価で、比較したのはOpus 5.5より前のOpus 5です。
Q. HydraFusionが途中で捨てた下書きの変更は、ファイルに残りますか?
A. 残ることがあります。公式ドキュメントには、採用されなかった下書きのファイル編集は自動で元に戻らないと書かれています。クリーンな作業ツリーや検証用のブランチで試し、コミット前にgit diffで変更をすべて確認してください。
Q. スクリプトやCIからHydraFusionを呼び出せますか?
A. Copilot CLIならcopilot --experimental --model hydrafusion -p "プロンプト"で、1回だけのプロンプトとして実行できます。トークンには「Copilot Requests」権限付きのfine-grained PATを使います。ただし研究プレビューでSLAがないため、止まると困る本番のパイプラインに組み込むのは避けたほうが無難です。
Q. 「HydraFusion」で検索すると、自動運転の研究が出てきます。同じものですか?
A. 別物です。GitHub上の「AICPS/hydrafusion」は、自動運転のセンサーフュージョンに関する研究リポジトリで、GitHub CopilotのHydraFusionとは関係ありません。
Q. すでにRubber Duckを使っています。HydraFusionに切り替えるべきですか?
A. 目的で選んでください。Rubber Duckは「主モデルは自分で選び、そこに別系統のレビューを足す」仕組みです。HydraFusionは「モデル選びもレビューするかどうかもGitHubに任せる」仕組みです。主モデルを自分で管理したいならRubber Duck、判断ごと任せて重めの単発タスクのコストを下げたいならHydraFusionが合います。
まとめ
Project HydraFusionは、GitHub Copilotのモデル選択を「ユーザーが1つ選ぶ」方式から「GitHubがタスクごとに解き方を組み立てる」方式に変える研究プレビュー機能です。現時点の要点は次のとおりです。
- 提供状況: 2026年9月4日にCopilot CLIで公開。9月30日からVS Code(1.140以降)とGitHub Copilotアプリでも使える。SLAはない
- 仕組み: Single・Cascade・Critiqueの3パターンから、品質の目標を満たす最も単純なワークフローを自動で選ぶ。Autoは「モデルを1つ選ぶ」、HydraFusionは「ワークフローを選ぶ」
- 性能: Claude Opus 5比でコストは36〜67%減。品質ではっきり上回ったのはTerminalBench 2.1だけで、ほかの2つはほぼ同じ〜わずかに下。GitHub自身の評価で、Opus 5.5やGPT-6系が出る前の比較
- 料金: 追加料金はなし。各モデルの標準レートでAI Creditsを消費し、Autoの10%割引は効かない。CLIでは
/usageでモデル別の消費を測れる - 制約: 個人ではモデルを指定できない、下書きの本文は見えない、捨てられた下書きの編集が残る、サブエージェントを起動しない、コンテキストは最小のモデルに合わせる、マルチターンは最適化の途中
- 企業での導入: 組織のモデルポリシーで使うモデルの範囲は絞れる。ただしDPAの適用範囲やデータの扱いは明文化されていない
今すぐ試す価値があるのは、Copilotを日常的に使っていて、範囲のはっきりした単発タスクをよく投げるエンジニアです。検証用のブランチで試し、/usageでAutoとの消費を比べれば、自分の仕事で得になるかを短期間で判断できます。
監査の要件や規制がある環境では、データの扱いが明文化されるまで待つほうが妥当です。研究プレビューなので、仕様やモデル構成が今後変わる前提で付き合う必要があります。
AIコーディング環境全体を選び直している場合は、「Claude Code vs GitHub Copilot 徹底比較」や「生成AIツールおすすめ比較」も参考にしてください。エージェント型AIの基本から押さえたい人は「AIエージェントとは」から読むとわかりやすいはずです。
参照した主な公式情報
- Project HydraFusion: Frontier quality via multi-model orchestration — The GitHub Blog(2026年9月4日)
- HydraFusion in VS Code and the GitHub Copilot app — GitHub Changelog(2026年9月30日)
- GitHub Docs: HydraFusion(early access)
- [Research Preview] HydraFusion — GitHub community Discussion
- GitHub Docs: Install Copilot CLI
- GitHub Copilot CLI changelog
- GitHub Docs: About the rubber duck agent
- GitHub Docs: Auto model selection
- GitHub Docs: Copilot plans
- Selected models in GitHub Copilot deprecated — GitHub Changelog(2026年10月2日)
依頼範囲と費用の目安を30分で整理します
この記事の著者

AI革命
編集部
AI革命株式会社の編集部です。最新のAI技術動向から実践的な導入事例まで、企業のデジタル変革に役立つ情報をお届けしています。豊富な経験と専門知識を活かし、読者の皆様にとって価値のあるコンテンツを制作しています。
最新記事
Claude Duet(デュエット)とは?機能・対象プラン・使い方・日本での提供状況と注意点【2026年10月】
2026/10/21
LiteLLM 1.107.0にマルウェア|感染の確認方法と対処手順・作り直す鍵・3月の事件との違い
2026/10/21
Perplexity Cometとは?機能・料金・使い方・他AIブラウザとの違いを徹底解説
2026/04/02
PHP2Shell脆弱性(CVE-2026-109618)とは?PHPのRCEの影響範囲・修正版・今すぐやる対策
2026/10/21
Claudeで攻撃対象領域を削減|OpenSSHの認証前コード約5分の1を削った手法とsshd運用者の対応【2026年10月】
2026/10/21
AIコーディング初心者の始め方【2026年10月】無料ツール・料金・注意点をレベル別に整理
2026/04/02