DeepSeek Super-agentとは?GitHubに常駐する自律型コーディングエージェントの仕組み・使い方・危険性・Claude Codeとの違い【2026年11月】
この記事のポイント
DeepSeek Super-agent(dsh-superagent)は、DeepSeek Harnessチームが2026年10月31日にMITライセンスで公開した研究用プロトタイプです。GitHubリポジトリに常駐して依頼をプルリクエストで返す仕組み、導入に必要なもの、API費用の目安、承認なしでコマンドを実行する危険性、Claude Code・GitHub Copilotとの違いを公式リポジトリをもとに整理しました。
DeepSeek Super-agent(リポジトリ名 dsh-superagent)は、DeepSeek Harnessチームが2026年10月31日にMITライセンスで公開した、GitHubリポジトリに常駐して依頼を受け、作業ごとに別のエージェントを立てて処理し、結果をプルリクエストで返すコーディングエージェントの研究用プロトタイプです。本体は無料ですが、READMEには「DeepSeekの公式製品ではない」「本番向けのソフトウェアではなく研究用のコードとして扱うこと」と書かれています。
Bloombergは「AnthropicのClaude Codeに対抗する強化版コーディングエージェント」と報じました。ただ、公開されたコードは設計文に書かれた構想の一部だけを実装したものです。報道の見出しと実際に動く範囲には差があります。
この記事でわかること
- DeepSeek Super-agentの正体と、DeepSeek Harnessとの関係
- Router(受付役)とWorker(作業役)に分かれた仕組み
- 設計文の構想のうち、公開コードで動くもの・まだ動かないもの
- 導入に必要なものと手順の要点、API費用の目安
- 承認なしでコマンドを実行するなど、使う前に知っておくべき危険性
- Claude Code・Claude Code Agent Teams・GitHub Copilotとの違い
AIエージェントの新しい設計を追っている開発者・テックリードや、「DeepSeekが出したClaude Code対抗」の中身を確かめたい技術選定の担当者に向けた記事です。情報は公式GitHubリポジトリ(README・SETUP.md・docs)、DeepSeek API の料金ページ、主要メディアの報道を2026年11月1日に確認したものです。
DeepSeek Super-agentとは何か
出典: GitHub - deepseek-ai/deepseek-harness
DeepSeek Super-agentは、人が1つずつ指示を出すたびに動くエージェントではなく、チームのGitHubリポジトリ(任意でFeishuのチャット)を見張り、許可された人からの依頼を拾って自分で作業を始めるエージェントです。依頼は「Ticket」という作業単位に変わり、Ticketごとに専用のセッションと作業ディレクトリが割り当てられます。
設計の考え方として、docsには "Take as little human attention as possible, and give as much value as possible."(人の注意をできるだけ使わず、できるだけ価値を返す)と書かれています。DeepSeekの設計文によると、1人が同時に追える会話は3〜5本程度で、AIがこなせる作業量が増えても人の注意がボトルネックになります。そこで会話の管理と文脈の同期はシステムが受け持ち、人は目標を決めて結果を確かめる役に回る、というのがSuper-agentの狙いです。
基本情報(2026年11月1日時点)
項目 | 内容 |
|---|---|
正式名称 | dsh-superagent(報道では「DeepSeek Super-agent」「Super-Agent」) |
開発元 | DeepSeek Harness Team(中国・DeepSeek) |
公開日 | 2026年10月31日(GitHubリポジトリの作成は 09:32 UTC) |
公式の位置づけ | 研究用プロトタイプ。「DeepSeekの公式製品ではない」とREADMEに明記 |
ライセンス | MIT |
提供形態 | セルフホストのみ。DeepSeek Harness(dsh)のプラグインとして動く。SaaS版・アプリ版はない |
バージョン | 0.1.0(npmには公開されていない。 |
対応する入力元 | GitHub(必須)、Feishu/Lark(任意) |
リポジトリ | |
反響 | スター約5,455・フォーク513(2026年11月1日に取得した値)。コミットはまだ1件 |
公開と同時に、DeepSeek Harnessチームは中国語の設計文「Exploring Super-agent Design: Towards a More Autonomous Agent System」を出しています。英語版は近日公開と報じられていますが、2026年11月1日時点で公式のURLは確認できていません。設計文の数値や構想は、新浪科技(智東西)やi-scoopの紹介で確認した内容です。
DeepSeek Harnessとの関係
Super-agentは単体のアプリではなく、DeepSeekのオープンソースのエージェント基盤「DeepSeek Harness(dsh)」の上で動くバンドルです。Harnessに superagent という専用プロファイルを作り、そこにプラグインとして追加して使います。
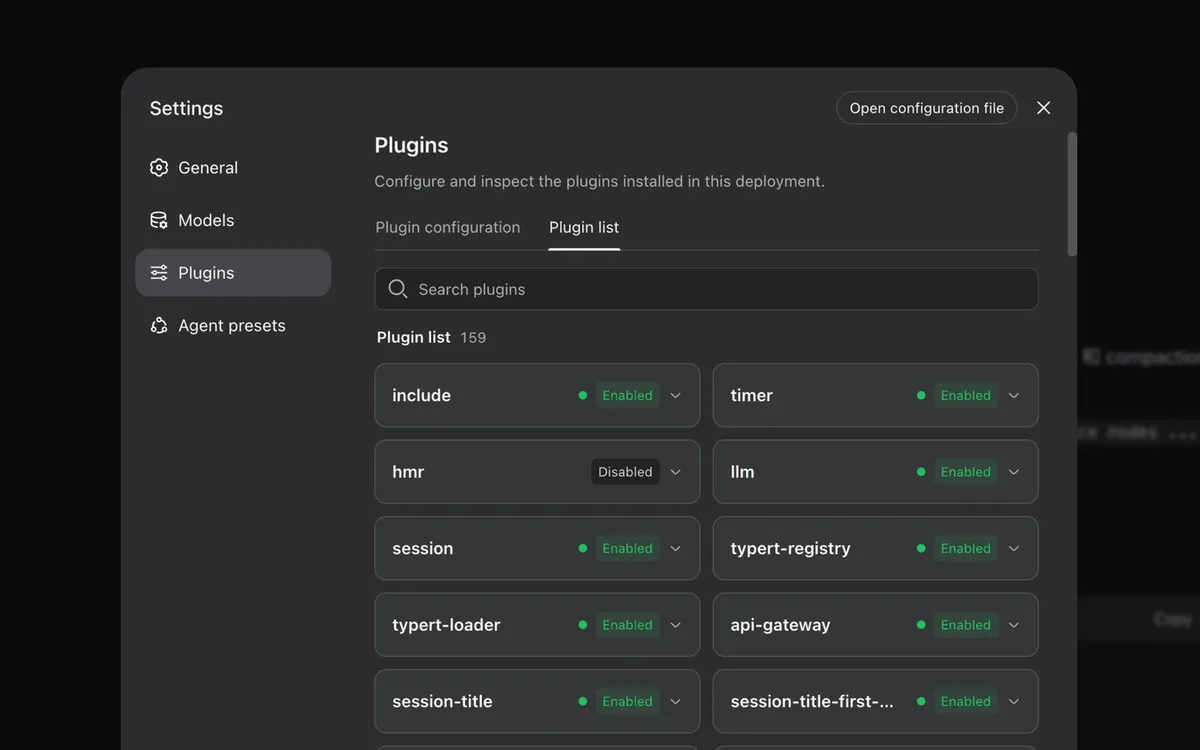
Harnessにも「Agent teams」という公式プラグインがありますが、役割は違います。Agent teamsは1つの作業を複数のエージェントで分ける仕組みで、Super-agentはチームから次々に届く依頼を作業単位で振り分ける仕組みです。Harness本体の機能・料金・4つの動作モードはDeepSeek Harnessとはで詳しく解説しています。
RouterとWorkerに分かれた仕組み
Super-agentの中心は、依頼を受け付けて振り分けるRouterと、実際に作業するWorkerの2層構造です。会社にたとえると、Routerは受付係、Workerは案件ごとの担当者にあたります。
構成要素 | 役割 | 公開コードでの実装 |
|---|---|---|
Router(受付役) | 届いたイベントを見て「受ける・既存のTicketに付ける・止める・無視する」を決める。自分ではコードを書かない | プリセット |
Worker(作業役) | Ticketごとに専用のセッションとディレクトリを持って作業し、元のスレッドにPRなどで返す | プリセット |
Sources(入力元) | 依頼やイベントを受け取る窓口 | GitHub(新しいIssue・PR・コメント・既定ブランチのCI)と Feishu |
Store(記録) | Ticketや判定の記録を保存する | SQLiteファイル1つ( |
Panel(管理画面) | 人の対応が必要なTicket(回答待ち・レビュー待ち・停止・失敗)を一覧で出す | 127.0.0.1 で動くWeb画面(例はポート3082) |
依頼から返答までの流れ
- 許可されたアカウントが、IssueやPRに
@エージェント名 依頼内容とコメントする(既定では約1分ごとに確認) - Routerが内容を見て、新しいTicketを作るか、進行中のTicketに追記として渡すかを決める
- Workerが
worker-<ticket id>という専用セッションで作業する。5秒を超えるシェルコマンドはバックグラウンドに回すので、作業中も追加の発言を受け取れる - 結果をプルリクエストやコメントで元のスレッドに返す
同時に動くWorkerの数は maxWorkers で上限を決めます。人からの発言を受けるための枠は別に1つ確保されます(設計文での既定はWorker 3枠+予備1)。モデルは「判定用」と「作業用」で分けて指定でき、設計文では「Routerは軽いモデルでよく、Workerには最も強いモデルを使う」という方針が示されています。
「自分から動く」作業は3つのモードで制御する
Super-agentが話題になったのは「頼まれる前に動く」点です。ただし公開コードでは、チームが書いた「ルール」に一致した発言だけを、依頼として推定して受けます。受け付け方は3つのモードから選びます。
モード | 動き |
|---|---|
| 推定の依頼は受けない。明示的なメンションだけに反応する |
| 「受けていたら」をログに残すだけで、実際には動かない |
| 判定が通った推定の依頼を実際に受けて作業する |
既定が observe なので、入れた直後から勝手にPRを作り始めるわけではありません。ルールには「マージ前にレビュー担当者の承認を必須にする」といった手順の条件も付けられます。
設計文の構想と、公開コードで動く範囲
出典: GitHub - deepseek-ai/dsh-superagent-prototype
設計文に書かれた5つの柱のうち、公開コードで確かめられるのは2層構造とイベント駆動の一部までです。 READMEも「社内版や設計文の実装とは同じではない」「設計文にある機能の一部は今後の方向性で、このプロトタイプには実装していない」と書いています。
設計文の柱 | 構想の中身 | 公開コード(2026年11月1日時点) |
|---|---|---|
Router と Worker の2層構造 | Routerは作業せず振り分けに徹する。作業単位で振り分ける | 実装済み |
イベント駆動 | チャット・メール・カレンダー・レビューコメント・CIを起点に、ルール判定とLLM判定の2段階で受け付ける | 一部。入力元はGitHubとFeishuだけで、Slack・メール・カレンダーは非対応 |
全二重のやりとり | 作業中でも非同期に開始・停止でき、チャットでは短く、PRでは詳しく返す | 作業中の追記は担当Workerに届く。全二重モードとしての扱いは未確認(設計文では既定オフ) |
計算・状態・実行環境の分離 | エージェントのループと状態はクラウド、コマンドは手元のマシンで実行。モデルは持ち込み(BYOM) | 未実装 |
外部Watchdog | 定期的にWorkerが本当に進んでいるかをモデルで確かめる | 未実装 |
報道で紹介された「グループチャットを読んで、頼まれる前に修正PRを作る」といった動きも設計文の構想です。公開コードで自分から作業を始めるのは、Feishuの許可された範囲で、ルールに一致し、なおかつ auto モードにしたときに限られます。
DeepSeekは「新しい理論ではなく、スケジューリング・キャッシュ・計算と記憶の分離・ウォッチドッグといった既存のコンピュータシステムの考え方をエージェントに当てはめた」と説明しています(Seoul Economic Daily)。エージェントの基本的な仕組みはAIエージェントとはで整理しています。
DeepSeekが公表したテスト結果
DeepSeekの自社テストでは、Super-agentは1つのセッションで処理するより速く、待ち時間のばらつきも小さい一方、トークンを2〜4倍使いました。 第三者による検証はまだなく、条件も実運用とは違うので、数値は参考程度に見てください。
テストの条件は、約300件のメッセージ(うち作業依頼は約20件)を流し、各構成を5回ずつ実行するものです。時間は4分の1に縮め、コーディング作業そのものは模擬で、測っているのは振り分けの効率であってコードの品質ではありません。
構成 | 1タスクの完了時間(中央値) | 95パーセンタイル |
|---|---|---|
Super-agent(Router/Worker) | 12.4分 | 15.7分 |
単一セッション(中立なプロンプト。委任は使われず) | 20.4分 | 29.5分 |
単一セッション(委任を促すプロンプト。5回中4回委任) | 13.8分 | 29.0分 |
単一セッションの2行の数値が「中央値・95パーセンタイル」の順であることは、i-scoopの読み取りによるもので、原文の表記は確認できていません。
ほかに示された結果は次のとおりです。
- トークン: キャッシュ読み込みが約2,323万トークン。委任ありの単一セッションの約2倍、委任なしの約4倍
- 追記を直接Workerに渡す仕組みの効果: これを外すと、完了時間は変わらずにRouterの判定が約30%増え、トークンは3,177万(約37%増)になった
- 負荷が増えたとき: 届く件数を毎分約1件から約40件に上げると、Routerは平均1.0件ずつだった判定を2.8件ずつまとめるようになり、判定1件あたりの時間は6.4秒から1.6秒に下がった
まとめると「速さと安定性をトークンで買う」設計です。i-scoopは、イベントの絞り込みがどれだけ誤るかが示されていないことと、Workerに権限はあっても予算や監督の仕組みがないことを未解決の論点として挙げています。
料金:本体は無料、かかるのはAPI代とマシン代
出典: DeepSeek API Docs - Models & Pricing
Super-agentはMITライセンスで、料金プランはありません。費用は、DeepSeek HarnessでつなぐモデルのAPI従量課金と、常駐させるマシンの費用です。常駐型なので、手元のPCを閉じると止まります。継続して動かすならサーバーかPCを付けっぱなしにする必要があります。
DeepSeek APIの料金(2026年11月1日時点)
公式の料金ページの値です(100万トークンあたり、米ドル。左がオフピーク、右がピーク)。
APIのモデル名 | 中身 | 入力(キャッシュヒット) | 入力(キャッシュミス) | 出力 |
|---|---|---|---|---|
deepseek-flash | DeepSeek-V4.1-Flash-1017 | $0.003 / $0.006 | $0.15 / $0.30 | $0.60 / $1.20 |
deepseek-v4-pro | DeepSeek-V4-Pro-0813 | $0.022 / $0.044 | $0.66 / $1.32 | $1.98 / $3.96 |
ピークは平日の01:00〜04:00と06:00〜10:00(UTC)で、日本時間では平日10時〜13時と15時〜19時です。オフピークはピークの半額で、中国の祝日は除外されます。日本の勤務時間中に動かすと、ほぼピーク料金になります。
また、Harness経由で使うDeepSeekのSearch/Fetch APIは、2026年11月1日(北京時間0時)から従量課金が始まりました(1,000回あたり0.75ドル)。モデルの詳細はDeepSeek V4.1 Flash 1017とDeepSeek V4 Proとは、料金改定の経緯はDeepSeek APIの料金改定にまとめています。
トークン量から見た費用の目安(この記事での試算)
DeepSeekのテストで使われたキャッシュ読み込み約2,323万トークン分だけを、deepseek-flashとdeepseek-v4-proのキャッシュヒット単価で計算すると次のようになります。
モデル | オフピーク | ピーク |
|---|---|---|
deepseek-flash | 約$0.07 | 約$0.14 |
deepseek-v4-pro | 約$0.51 | 約$1.02 |
これは合成テスト1回分のキャッシュ読み込みだけの試算です。キャッシュミスの入力と出力の分は含まれていないので、実際の請求はこれより多くなります。また、作業の量や中身で消費は大きく変わります。「Workerに最も強いモデルを使う」方針に沿ってv4-proを使うと、flashと比べて単価はキャッシュヒットの入力で約7倍、キャッシュミスの入力で約4.4倍、出力で約3.3倍になる点は覚えておくとよいでしょう。
なお、Harness本体はAnthropicやOpenAIなど他社のモデルもつなげる設計ですが、Super-agentを他社モデルで動かした確認は、2026年11月1日時点で見つかっていません。
使い方:導入に必要なものと手順の要点
導入は、Claude Codeなどのコーディングエージェントにリポジトリの SETUP.md を読ませ、対話しながら進める形が想定されています。手順書では、質問は1回に1つずつにし、秘密情報はチャットで聞かないよう決められています。
必要なもの
項目 | 要件 |
|---|---|
Node.js | 22.19以上、または24以上 |
ツール類 | pnpm、git 2.32以上、Python 3.8以上、tmux、GitHub CLI 2.48以上 |
DeepSeek Harness | 手順書は |
モデル | DSHに設定したモデルプロバイダ |
GitHub | エージェント専用のGitHubユーザーアカウント(対象リポジトリへの書き込み権限つき)。GitHub Appは使えない。github.com のみで、GitHub Enterprise Server は非対応 |
Feishuを使う場合 |
|
OS | 明記なし。tmux・sh・ |
エージェントの書き込みはすべて専用アカウントの名前で表示されます。運用者本人のアカウントを使わないよう、公式は明記しています。
手順の要点
npm install -g @deepseek-ai/dsh@0.2.1-rc.3
git clone https://github.com/deepseek-ai/dsh-superagent-prototype.git dsh-superagent
cd dsh-superagent
pnpm install && pnpm build
# 新規導入時のみ(既存の superagent プロファイルを上書きする)
dsh superagent --from-default-profile web --dump-config > /dev/null
dsh plugin --profile superagent add "link:$PWD"
scripts/dsh-superagent start
起動したら ~/.dsh/profiles/superagent/cordis.patch.yml で記録の保存先(stateDir、絶対パス)を決め、管理画面かManagement APIで、入力元・許可リスト・実行の設定・プロンプトを保存します。
SETUP.mdが勧める初期値は次のとおりです。
- 許可するのは運用者のアカウントだけ
- 受付モードは
observe - auto-mergeは有効にしない(有効にするには別アカウントのCLIが必要)
- ブランチ名の接頭辞は
agent/ - 普段使いのHarnessとはプロファイルを分ける(ポート3082)
動作確認には scripts/dsh-superagent status を使います。終了コードは0が正常、1が再起動で直る可能性あり、2が再起動では直らない、3が未設定です。1時間ごとの死活確認も推奨されています。
使う前に知っておくべき危険性
Super-agentのWorkerは、運用者のOSユーザーの権限で、承認なしにコマンドを実行します。 RouterとWorkerのどちらのプリセットも danger-full-access で動くため、作業用のPCや本番の認証情報がある環境にそのまま入れるのは避けてください。
公式ドキュメントに書かれている注意点
- プロセスは分離されない: アカウントの切り替えは使う認証情報を選ぶだけで、プロセスを隔離するものではありません。分離したい場合は、エージェント用の認証情報だけを持つ専用のOSアカウントで動かすよう公式が勧めています
- 禁止コマンドの指定は完全な防御ではない:
DSH_SUPERAGENT_BLOCKED_COMMANDSで実行を禁じるコマンドを指定できますが、名前で呼ばれたときに失敗させる方式です。別の書き方で同じ処理をされると防げません - 環境変数の取り除き: 導入時に、名前に KEY・PASSWORD・SECRET・TOKEN を含む環境変数を取り除きます
- 許可リストで見落としやすい設定: リスト外の人がメンションしたときの扱いを
explicitにすると、その範囲の誰でも作業を依頼できるようになります - 自動レビュアーは「人」と見なされる: 通常のアカウントで動くレビュー用ボットは人として扱われるため、プロンプトでボットだと伝えておく必要があります
- ポリシーを弱めても進行中の作業はすぐ止まらない: 確認されるのは作業の再開時です
- マージなどの扱いはプロンプト頼み: 成果物をどう扱うかはポリシーではなくエージェントへの指示で決まります。auto-mergeを勧めない理由の1つです
プロンプトインジェクションへの考え方
権限の仕組みは、許可リスト・ルール・作業の委任(Mandate)をホスト側が強制し、メッセージの内容によって権限が変わらないように作られています。Mandateが変わるのは「受け付けで作られる」「人が止めて取り消す」「再検証に失敗して取り消す」の3つだけです。CIの結果やボットのコメントも文脈として読みますが、それで権限は増えません。
ただし、設計文自身がセキュリティとプライバシー(端末の認証情報、プロンプトインジェクション)を未解決の課題に挙げています。承認なしで動くエージェント全般の危うさは、Claude Codeのautoモードとプロンプトインジェクションが参考になります。
データの送り先と、DeepSeekを取り巻く規制
セルフホストのOSSでも、DeepSeekのAPIをつなげば、IssueやPRの内容、コード、Feishuのメッセージはモデルの入力としてDeepSeekのAPIに送られます。米国では2026年10月に、連邦の民間機関からDeepSeek製品を排除する命令が公表されました。中国系のサービスの利用を社内規程で制限している会社は、試す前に情報システム部門やセキュリティ担当と相談してください。DeepSeekという会社とサービス全体の状況はDeepSeekとはにまとめています。
試すときのチェックリスト
確認すること | 推奨 |
|---|---|
動かす場所 | 業務用PCではなく、専用のVM・サーバー・OSアカウント |
GitHubアカウント | エージェント専用のユーザーを作り、対象リポジトリだけに書き込み権限を与える |
対象リポジトリ | 機密を含まない検証用リポジトリから始める |
許可リスト | 運用者1人から始め、 |
受付モード |
|
マージ | auto-mergeは無効。ブランチ保護で人のレビューを必須にする |
認証情報 | 本番のAPIキーやクラウドの管理者権限を置かない |
データ | 社内規程でDeepSeek APIへの送信が認められているか確認する |
記録 | SQLiteは自動で古い記録を消さないため、容量とバックアップを管理する |
AIエージェントを試すだけでなく、自社の業務で承認・停止・再実行まで含めて動かすとなると、権限の管理、失敗時のやり直し、監視といった仕組みをプロトタイプの外側に用意する必要があります。どこまでを追加で作るかは、AIエージェントの本番導入で追加する開発範囲で整理しています。
現時点の弱み・制約
公式のREADMEとdocsから読み取れる制約は次のとおりです。
- 公式製品ではなく研究用コード。バグや一貫しないコードがありうると明記されており、サポートや更新を続けるとは書かれていない
- 対象は1つのリポジトリだけ。github.com専用で、GitHub Enterprise Serverには対応しない
- 入力元はGitHubとFeishuだけ。Slack・Microsoft Teams・メール・カレンダーには非対応(入力元を追加する手順はdocsにある)
- GitHub Appとして動かせない。専用のユーザーアカウントが必要
- 設計文の機能の一部が未実装。Watchdogや、クラウドと手元の分離などはまだない
- 記録が増え続ける。古い記録が削除されないため、SQLiteのファイルが大きくなる
- 戻すにはバックアップが要る。アップグレード後のDBは古い版で開けない
- ドキュメントは中国語と英語。日本語のドキュメントや日本語での動作確認は見当たらない
- 第三者の評価がない。公表された数値はすべてDeepSeekの合成テスト
Claude Code・GitHub Copilotとの違い
いちばん大きな違いは「動き出すきっかけ」です。 Claude Codeは人がセッションを開いて指示し、GitHub Copilotのクラウドエージェントは人がIssueを割り当てて動かします。Super-agentはリポジトリやチャットに常駐し、届いた依頼やイベントを自分で振り分けます。
比較項目 | DeepSeek Super-agent | DeepSeek Harness本体 | Claude Code(Agent Teams含む) | GitHub Copilot(クラウドエージェント) |
|---|---|---|---|---|
動き出すきっかけ | GitHub・Feishuでのメンション、ルールに一致した発言 | 人がセッションで指示 | 人がセッションで指示。Agent Teamsはリーダーがメンバーに割り振る | 人がIssueを割り当てる・指示する |
常駐するか | 常駐して約1分ごとに確認 | しない(定期実行プラグインはある) | しない(GitHub Actions連携などで自動化は可能) | GitHub側で動く |
並列化の単位 | 依頼(Ticket)ごとにWorkerを立てる | Agent teamsは1つの作業を分担 | Agent Teamsは1つの作業を複数メンバーで分担(実験的機能) | タスクごと |
提供形態 | セルフホストのみ(研究用プロトタイプ) | デスクトップアプリ・Web UI・CLI(プレビュー) | 製品として提供 | 製品として提供 |
料金 | 無料(API代は別) | 無料(API代は別) | 有料プランまたはAPI従量 | 有料プランで利用(2026年6月からAIクレジット制) |
公式サポート | なし | プレビュー | あり | あり |
ソースコード | MIT | MIT | 非公開 | 非公開 |
Claude CodeとCopilotの料金や機能は更新が早いので、最新の内容はClaude Codeとは、Claude Code Agent Teamsの使い方、GitHub Copilotとはで確認してください。ほかのツールも含めて選ぶならAIコーディングツールおすすめが入口になります。
選び分けの目安
やりたいこと | 選ぶもの |
|---|---|
今日から安定してコーディングを任せたい | Claude Code、またはGitHub Copilot |
GitHubのIssueをAIに割り当て、PRで受け取りたい(製品として) | GitHub Copilotのクラウドエージェント |
1つの大きな作業を複数のAIで分担させたい | Claude Code Agent Teams、またはHarnessのAgent teams |
「チームに常駐して依頼を拾うエージェント」の設計を研究・検証したい | DeepSeek Super-agent |
チャットツールから雑多な作業を頼みたい | OpenClawやHermes Agentなどの常駐型エージェント |
Bloombergは「Claude Code対抗」と位置づけましたが、今のSuper-agentはClaude Codeの代わりというより、「チームに常駐するAI」の設計を示した参照実装と考えるほうが実態に近いです。
こんな人におすすめ
当てはまる状況 | 理由 |
|---|---|
AIエージェントの設計や、複数エージェントの振り分けを研究したい | Router/Worker構成、Mandateによる権限管理などの実装をMITライセンスで読める |
GitHub上の少人数チームで、Issue対応をAIに任せる形を試したい | メンションからPRまでの流れを、検証用リポジトリで再現できる |
すでにDeepSeek Harnessを使っている | 同じ基盤にプロファイルを追加するだけで試せる |
Feishu(Lark)を社内チャットに使っている | 公開コードで対応している唯一のチャットツール |
API費用を抑えて常駐型エージェントを試したい | 本体は無料で、flashならトークン単価が低い |
おすすめしない人
当てはまる状況 | 理由 |
|---|---|
本番運用やベンダーのサポートを求めている | 公式製品ではない研究用コードで、更新の約束もない |
GitHub Enterprise Serverや複数リポジトリで使いたい | github.comの1リポジトリだけが対象 |
SlackやMicrosoft Teamsから依頼したい | 公開コードはGitHubとFeishuだけに対応 |
中国系サービスの利用が社内規程で制限されている | DeepSeek APIを使えばコードや会話がDeepSeekに送られる |
ターミナル操作や権限設計に慣れていない | 承認なしでコマンドが実行されるため、専用環境の準備が欠かせない |
Windowsだけで使いたい | tmuxなどを前提とし、Windowsでの動作は確認されていない |
よくある質問
Q. DeepSeek Super-agentは無料で使えますか。
本体はMITライセンスで無料です。ただし動かすにはDeepSeek HarnessとモデルのAPIが必要で、API代は従量でかかります。依頼を受けるたびにRouterの判定とWorkerの作業でトークンを使い、DeepSeekのテストでは単一セッションの2〜4倍を消費しました。常駐させるマシンの費用も見込んでください。
Q. Claude Codeの代わりになりますか。
今は代わりになりません。Super-agentは研究用のプロトタイプで、コードを書く力そのものを比べたデータもありません。公表されたテストが測ったのは振り分けの効率で、コーディング作業は模擬でした。日々の開発はClaude Codeなどの製品を使い、Super-agentは設計の参考として試すのが現実的です。
Q. 日本語で依頼できますか。
ドキュメントと画面の言語設定は中国語と英語で、日本語での動作は公式には確認されていません。依頼文はモデルへの入力になるため、接続するモデルが日本語を理解すれば日本語のコメントでも処理できる可能性はあります。ただし、ルールによる判定などが日本語で期待どおりに動くかは、自分で確かめる必要があります。
Q. Slackから使えますか。
2026年11月1日時点の公開コードでは使えません。設計文ではチャット・メール・カレンダーを起点にする構想が書かれていますが、実装されている入力元はGitHubとFeishuの2つです。docsに入力元を追加する手順があるので、自分で拡張することはできます。
Q. DeepSeekのモデル以外でも動きますか。
公式には確認されていません。基盤になっているDeepSeek HarnessはAnthropicやOpenAIなどのプロバイダを設定できますが、Super-agentでの動作確認は見つかっていません。データをDeepSeekに送りたくない場合は、他社モデルで動くかを検証環境で試してから判断してください。
Q. 社内のリポジトリで試しても大丈夫ですか。
勧めません。Workerは承認なしにコマンドを実行し、運用者のOSユーザーの権限で動きます。試すなら、機密を含まない検証用リポジトリ、専用のGitHubアカウント、専用のVMかOSアカウントを用意し、受付モードは observe から始めてください。
まとめ
DeepSeek Super-agentは、GitHubリポジトリに常駐して依頼を拾い、作業ごとに別のエージェントで処理してPRで返す「自分から動く」コーディングエージェントの研究用プロトタイプです。
- 2026年10月31日公開。MITライセンスで無料、DeepSeek Harnessのプラグインとして動く。公式製品ではない
- 受付役のRouterと作業役のWorkerに分かれ、依頼(Ticket)ごとに専用のセッションとディレクトリで並列に処理する
- 入力元はGitHub(github.comの1リポジトリ)とFeishuだけ。Watchdogやクラウドとの分離は未実装
- DeepSeekのテストでは単一セッションより速く安定したが、トークンは2〜4倍。数値は合成テストの自社計測
- Workerは
danger-full-accessで承認なしにコマンドを実行する。専用のアカウントと環境で、observeから試す
今の付き合い方としては、本番には入れず、検証環境で「チームに常駐するAI」の設計を確かめる教材として使うのが妥当です。リポジトリの更新や英語版の設計文の公開が続く見込みなので、動向はあわせて追っておきましょう。
このツールを自社のシステムや業務にどう組み込むか、ご提案します
この記事の著者
AI革命
編集部
AI革命株式会社の編集部です。最新のAI技術動向から実践的な導入事例まで、企業のデジタル変革に役立つ情報をお届けしています。豊富な経験と専門知識を活かし、読者の皆様にとって価値のあるコンテンツを制作しています。
最新記事
Meta Muse Spark 1.3とは?ツール呼び出し20%減の実力とClaude Fable 5.1・GPT-5.6 Solとの違い【2026年11月更新】
2026/09/04
Claude Fable 5.1・Mythos 5.1とは?Fable 5からの変更点・キャッシュ読取75%値下げ・利用制限リセットと移行ポイント【2026年11月最新】
2026/09/02
ソニー・ワーナーがAnthropicを提訴|音楽出版2社の著作権訴訟・1曲15万ドル請求の中身とBartz和解との違い【2026年11月最新】
2026/08/31
Anthropicが国防総省に地裁で勝訴、控訴裁で敗訴|「サプライチェーンリスク」指定の違憲判決と自律兵器の線引き【2026年11月最新】
2026/08/30
Apple Intelligenceが中国で承認・12月提供へ|22カ月越しのCAC認可、Qwen統合とBaiduの役割、iPhoneユーザーへの影響【2026年11月最新】
2026/07/20
AIサイバー攻撃の公開書簡に約700組織が署名|OpenAI・Anthropic・Google・Microsoft連名の共同声明の中身と企業が今すぐ取るべき防御策【2026年11月更新】
2026/08/30