claude-context(Zilliz製)使い方完全ガイド|コードベース全体をセマンティック検索するMCPプラグイン【2026年最新】
この記事のポイント
claude-context(Zilliz製)は、Claude Codeなどにコードベース全体のセマンティック検索を追加するOSSのMCPサーバーです。2026年10月時点の仕様(Node.js 20以上・Zilliz Cloud無料枠のコレクション上限・PostToolUseフックでの再インデックス)をもとに、設定手順・料金・セキュリティ上の注意・Serenaとの違いを整理します。
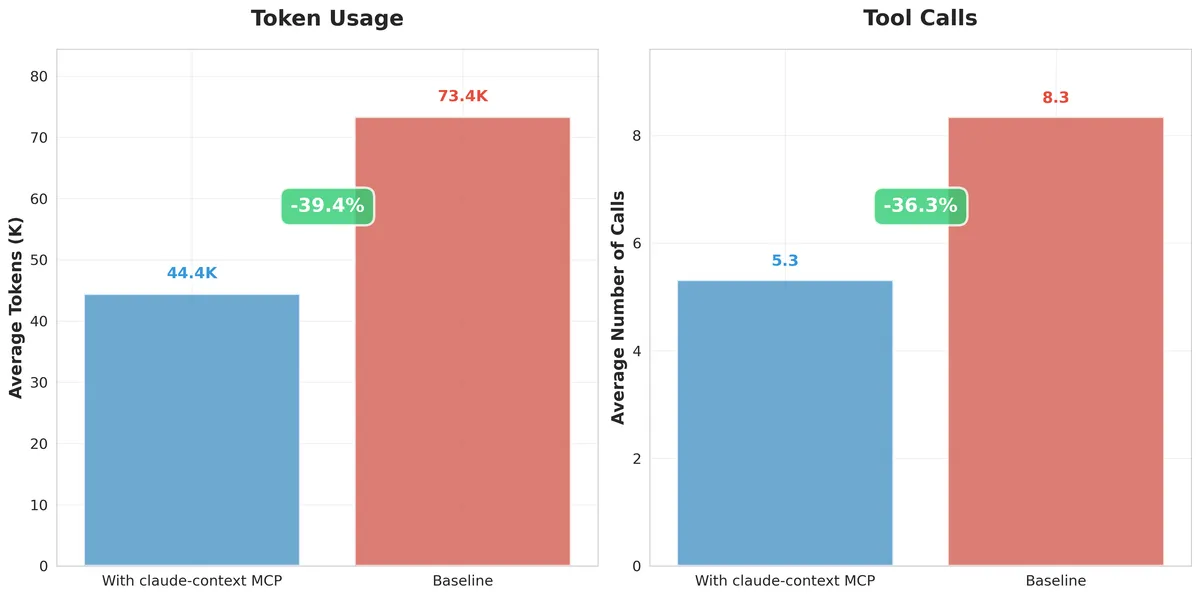
claude-context は、ベクトルDB「Milvus」を開発する Zilliz 社がオープンソースで公開しているMCPサーバーで、Claude Code などのAIコーディングエージェントに「コードベース全体のセマンティック検索」を追加します。使い方は、claude mcp add で登録して「Index this codebase」と頼み、あとは自然言語で検索するだけです。開発元の評価では、grep だけで探す場合に比べてトークン使用量が平均39.4%、ツール呼び出し回数が36.3%減ったと報告されています(2026年10月時点のGitHubスター数は約12,600、npm 最新版は 0.1.15)。
この記事でわかること
- claude-context の構成(MCPサーバー・埋め込みモデル・ベクトルDBの3つ)と4つのMCPツール
- Claude Code での最短セットアップ(
claude mcp add1行 → インデックス → 検索)と、Cursor・Gemini CLI・Codex CLI での設定 - 料金の考え方と、Zilliz Cloud 無料枠の「コレクション5個まで」という制限
search_codeを使ってもらうための CLAUDE.md の書き方、PostToolUse フックで編集直後に再インデックスする方法- 社外秘コードで使うときのセキュリティ上の注意(2026年10月時点で未解決の Issue を含む)
- Serena・Context7 など、ほかのMCPとの使い分け
想定読者:Claude Code や Cursor で「関連コードを探すだけでトークンを使い切る」と感じているエンジニア、大きなモノレポをAIと一緒に読みたいチーム、社外秘コードでの導入可否を判断したい情報システム担当者。
claude-context とは:Zilliz製のコード検索MCPサーバー
claude-context は、コードベースをベクトル化して、AIコーディングエージェントに「意味でのリポジトリ横断検索」を提供するMCPサーバーです。GitHub で公開されている MITライセンスのOSSで、商用利用もできます。npm パッケージ @zilliz/claude-context-mcp として配布され、Claude Code・Cursor・Gemini CLI・Codex CLI などMCPに対応したクライアントから使えます。
なお、公式は「MCP plugin」と呼んでいますが、実体はMCPサーバーです。Claude Code の /plugin で入れるプラグインとしての配布は、2026年10月時点では確認できませんでした。MCPという仕組み自体は「MCPとは(Model Context Protocol)」で解説しています。
公式が挙げている技術的な特徴は3つです。
- ハイブリッド検索:BM25(キーワード一致)と密ベクトル(意味検索)を組み合わせる。
HYBRID_MODE=falseで密ベクトルだけにもできる - ASTベースのコード分割:tree-sitter で関数・クラス単位に分割する。既定のチャンクサイズは2,500文字・重なり300文字(行数ではなく文字数)。対応していない言語は文字ベースの分割に自動で切り替わる
- Merkle Tree による差分インデックス:変更されたファイルだけを再処理する。既定では5分ごとにバックグラウンドで同期する
「ファイルを都度読ませる」のではなく、「ベクトルDBに登録しておいて関連チャンクだけを渡す」考え方です。コードベース向けのRAG(検索拡張生成)と捉えるとわかりやすいでしょう。大きなリポジトリでもコンテキストウィンドウを使い切りにくくなります。
claude-context の仕組み(3つのコンポーネント)
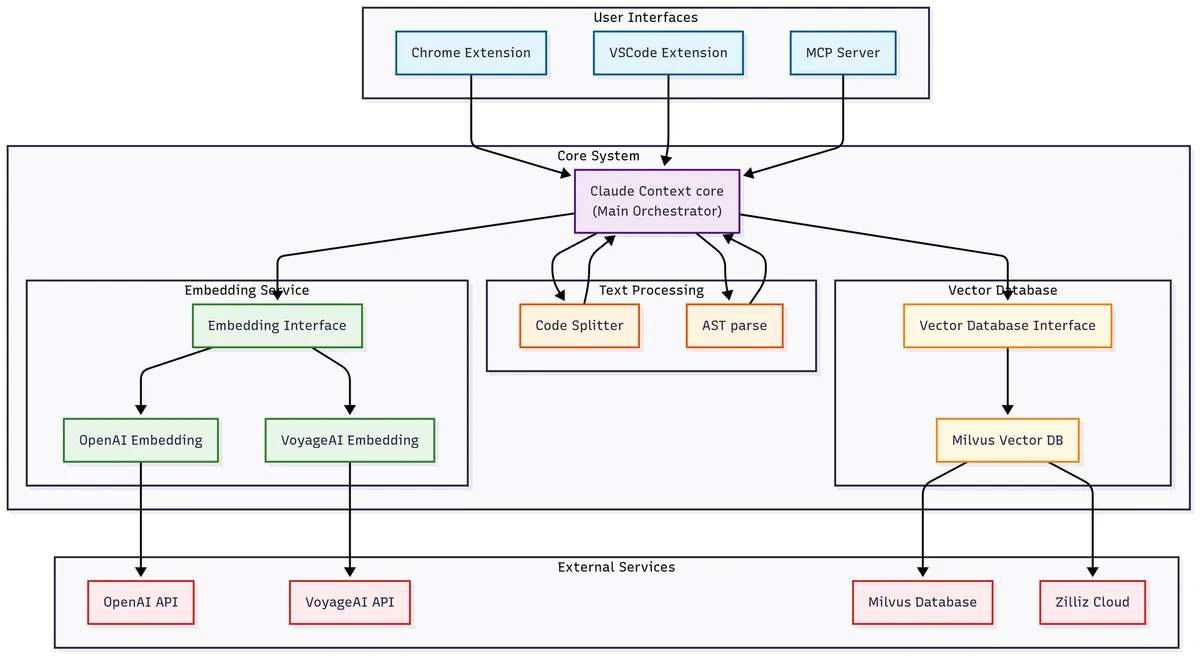
出典: zilliztech/claude-context GitHub公式
claude-context は単体では動きません。MCPサーバー本体・埋め込みプロバイダー・ベクトルDBの3つがそろって初めて動きます。導入でつまずく原因の多くはこの3つにあるので、最初に分けて押さえておきます。
コンポーネント | 役割 | 選択肢 |
|---|---|---|
① MCPサーバー(claude-context 本体) | コードの収集・分割・検索 |
|
② 埋め込みプロバイダー | コードのチャンクをベクトルに変換 | OpenAI / VoyageAI / Gemini / Ollama |
③ ベクトルDB | ベクトルとコード本文を保存し、類似検索を返す | Milvus(セルフホスト)/ Zilliz Cloud(マネージド) |
動作の流れ
index_codebaseが呼ばれると、対象ディレクトリのファイルを AST で関数・クラス単位に分割する- 各チャンクを埋め込みプロバイダーに送ってベクトルにする
- ベクトルとコード本文をベクトルDBに保存する(コードベースごとに1コレクション)
search_codeに自然言語の質問が来たら、質問もベクトルにしてDBを検索する- 上位のチャンクを MCP 経由でクライアントに返す
埋め込みに OpenAI などのクラウドAPIを選ぶと、コードのチャンクは外部に送られる点に注意してください。社外秘コードを外に出せない場合は、Ollama+ローカル Milvus の構成を選びます。
claude-context が提供する4つのMCPツール
ツール名 | 機能 | 主なパラメータ |
|---|---|---|
| ディレクトリをハイブリッド検索用にインデックス化。バックグラウンドで動き、すぐに応答が返る |
|
| 自然言語でコードを検索。インデックス作成中でも途中までの結果で検索できる |
|
| 指定したコードベースのインデックスを削除(実行中のインデックス作成も取り消す) |
|
| 進捗(%)と状態(indexed / indexing / indexfailed / not_found)を確認 |
|
進捗の%は段階ごとのおおまかな値です(0%=準備、約5%=スキャン、10〜100%=分割・埋め込み・書き込み)。大きなリポジトリでもすぐ10%になるのは仕様です。
対象になる言語・ファイル
README では TypeScript / JavaScript / Python / Java / C++ / C# / Go / Rust / PHP / Ruby / Swift / Kotlin / Scala / Markdown の14言語が対応言語として挙がっています。実際の既定の対象拡張子はこれより広く、2026年5月以降に Solidity(.sol)、Dart(.dart)、Objective-C(.m .mm)、Jupyter Notebook(.ipynb)も加わっています。
一方、.json .yaml .sql .sh .html .css などは既定では対象外です。必要なら CUSTOM_EXTENSIONS で足すか、チャットで「.vue と .svelte も含めてインデックスして」のように頼みます。
できること・できないこと
出典: zilliztech/claude-context GitHub公式
claude-context は、「どこで何をしているか」を意味で探すのは得意で、「この関数をどこから呼んでいるか」を正確にたどるのは不得意です。
できること
- 自然言語でのコード検索:「JWTの検証をしている場所」のような、ファイル名や関数名を知らなくても探せる検索
- 複数コードベースの管理:コードベースは絶対パスで区別する。クライアントの作業ディレクトリから、今どのコードベースかを判断する
- 差分インデックスと定期同期:変更ファイルだけを再処理し、既定では5分ごとにバックグラウンドで同期する
- 編集直後の再インデックス:
~/.context/.sync-triggerを更新すると再インデックスが始まる。Claude Code の PostToolUse フックと組み合わせられる - インデックス作成中の検索:完了を待たずに、途中までの結果で検索できる
- ローカル完結の運用:Ollama(埋め込み)+ Milvus(ベクトルDB)なら、コードを外部サービスに送らずに使える
開発元の評価で示されている効果
開発元のリポジトリの evaluation では、SWE-bench Verified から選んだ30問で、grep・read・edit だけのエージェントと比べています。
指標 | grep のみ | claude-context あり | 差 |
|---|---|---|---|
平均F1(変更すべきファイルの特定精度) | 0.40 | 0.40 | 同等 |
平均トークン | 73,373 | 44,449 | -39.4% |
平均ツール呼び出し | 8.3回 | 5.3回 | -36.3% |
数字を読むときは、次の条件に注意してください。
- 開発元自身の評価で、第三者の検証ではない
- モデルは GPT-4o-mini(LangGraph の ReAct エージェント)。Claude 系モデルで測った数値ではない
- 計測は
claude-context-mcp@0.1.0の時点 - 精度は上がっておらず、同じ精度をより少ないトークンで出したという結果
自社のリポジトリと使い方で効果が出るかは、実際に試して確かめるのが確実です。
できない・不得意なこと
- シンボル単位の定義ジャンプ・参照元の追跡:LSP を使う Serena などのほうが向いている
- 即時の同期:既定は5分ごと。すぐ反映したいならトリガーファイルか
forceでの再インデックスが必要 - ベクトルDBなしでの動作:Milvus か Zilliz Cloud が必ず要る
- 完全一致の保証:ハイブリッド検索でも意味検索の性格が強く、文字列の完全一致を探すなら grep のほうが確実
- マシンをまたいだインデックス共有:コレクション名にパスのハッシュを使うため、標準の仕組みではチームで共有しにくい
- 索引の所要時間の公式目安:公式には示されていない。リポジトリの大きさと埋め込みAPIの速度で大きく変わる
料金:本体は無料、実運用費は「埋め込みAPI+ベクトルDB」で決まる
出典: Zilliz 公式サイト
claude-context 本体は MITライセンスのOSSで無料です。費用がかかるのは埋め込みAPIとベクトルDBで、個人で試す規模ならどちらも無料か数円程度に収まります。
構成要素 | 費用 | 備考(2026年10月時点の公式情報) |
|---|---|---|
claude-context 本体 | 無料(MIT) | npx で実行 |
埋め込み:Ollama(ローカル) | API料金なし | マシンのCPU / GPU を使う |
埋め込み:OpenAI | 従量課金 | 入力100万トークンあたり $0.02(OpenAI公式) |
埋め込み:OpenAI | 従量課金 | 入力100万トークンあたり $0.13 |
埋め込み:VoyageAI(既定 | 従量課金 | 単価は VoyageAI公式 ・Google の公式料金ページで確認 |
ベクトルDB:Milvus(セルフホスト) | 無料 | Docker Compose で起動 |
ベクトルDB:Zilliz Cloud Free | 無料 | 5GBストレージ・月250万vCU・コレクション最大5個 |
ベクトルDB:Zilliz Cloud Serverless / Dedicated | 従量課金 | Serverless の読み書きは100万vCUあたり $4。ストレージ単価や Dedicated の料金は Zilliz Cloud 料金ページ で確認 |
Zilliz Cloud は、業務用メールで新規登録すると $100 分のクレジット(30日で失効)がもらえます。支払い方法を登録すると、さらに $100 が追加され、有効期限が1年に延びます(Zilliz 公式ドキュメント)。
無料枠は「5リポジトリまで」と考える
claude-context はコードベース(絶対パス)ごとにコレクションを1つ作ります。Zilliz Cloud Free のコレクション上限は5個なので、無料枠でインデックスできるコードベースは実質5つまでです。上限に達すると「collection limit」に関するエラーが出ます。使わなくなったコードベースは clear_index で消すか、ローカル Milvus に切り替えます。
同じリポジトリでも、別の場所にクローンしたものやシンボリックリンク経由のパスは別のコードベースとして扱われ、コレクションを1つ余分に使う点にも注意してください。
埋め込み費用の試算
OpenAI の埋め込みを使う場合の初回インデックス費用を、次の前提で試算します(1ドル=150円で計算)。
- 10万行のリポジトリ、1行あたり平均10トークン → 約100万トークン
- チャンクの重なり(300文字)による増加分を見込み、約1.2倍 → 約120万トークン
モデル | 計算 | 初回インデックス費用の目安 |
|---|---|---|
| 1.2 × $0.02 | 約 $0.024(約4円) |
| 1.2 × $0.13 | 約 $0.16(約23円) |
1行あたりのトークン数は言語やコードの書き方で変わるため、あくまで目安です。差分インデックスなので、2回目以降は変更分だけがかかります。埋め込み費用より、Claude Code 側で関連コードを探すために使うトークンのほうがずっと大きいことが多く、claude-context の費用対効果は Claude Code 側のトークンをどれだけ減らせるかで考えるのが実態に合います。Claude Code 全体のトークン節約は「Claude Code のコスト最適化」も参考になります。
構成ごとの比較
構成 | 費用 | コードが外に出るか | コードベース数 | 手間 |
|---|---|---|---|---|
OpenAI + Zilliz Cloud Free | ほぼ無料(埋め込みは数円〜) | 出る(OpenAI と Zilliz Cloud) | 5つまで | 少ない |
OpenAI / VoyageAI / Gemini + Zilliz Cloud 有料 | 従量課金 | 出る | 上限はプラン次第 | 少ない |
Ollama + ローカル Milvus | API料金なし(マシン資源のみ) | 出ない | 制限なし(マシン資源次第) | Docker と Ollama の運用が要る |
前提条件:始める前にそろえる4つ
始める前に次の4つをそろえます。
- Node.js 20 以上:README の要件は「Node.js >= 20.0.0」で、2026年4月に Node.js 24 への対応も明記されました。
node -vで確認します - 埋め込みAPIのキー または Ollama のローカル環境
- ベクトルDBの接続情報:Zilliz Cloud なら API キー(Personal API Key)、ローカルなら Milvus を Docker で起動
- MCPクライアント:Claude Code / Cursor / Gemini CLI / Codex CLI など
以前は「Node.js 24 以上は非対応」と案内されていましたが、2026年10月時点の README では20以上なら動きます。「24未満」という条件が残っているのは、開発元の評価スクリプトを再現する場合だけです。
使い方①:Claude Code で claude-context を使う最短セットアップ
Claude Code では、~/.claude.json を手で編集するより claude mcp add コマンドで登録するのが公式の手順です。ここでは OpenAI の埋め込みと Zilliz Cloud を使う、いちばん手軽な構成で説明します。Claude Code 自体の導入がまだなら「Claude Code 使い方」を先にご覧ください。
ステップ1:APIキーを用意する
- OpenAI:APIキー(
sk-...) - Zilliz Cloud:無料クラスターを作り、Personal API Key をコピーする。作り方は Zilliz 公式ドキュメント にある
2026年10月時点の公式ドキュメントでは、Zilliz の Personal API Key を使う場合、接続先(MILVUS_ADDRESS)はトークンから自動で解決されるため省略できます。ローカルの Milvus を使う場合は MILVUS_ADDRESS が必須です。
ステップ2:claude-context を MCPサーバーとして登録する
ターミナルで次のコマンドを実行します(README のコマンドと同じ形です)。
claude mcp add claude-context \
  -e OPENAI_API_KEY=sk-your-openai-api-key \
  -e MILVUS_ADDRESS=your-zilliz-cloud-public-endpoint \
  -e MILVUS_TOKEN=your-zilliz-cloud-api-key \
  -- npx @zilliz/claude-context-mcp@latest
-- より後ろがサーバーの起動コマンドで、-e で環境変数を渡します。登録できたかは claude mcp list、または Claude Code のセッション内で /mcp を開いて確認します。
登録先(スコープ)は -s で選べます。
スコープ | 保存先 | 使いどころ |
|---|---|---|
|
| 自分だけ、このプロジェクトだけで使う |
| プロジェクト直下の | チームで設定を共有する(Git に入る) |
|
| 自分の全プロジェクトで使う |
project スコープの .mcp.json は Git で共有されるので、APIキーを直接書かないでください。キーは各自の ~/.context/.env(claude-context が読むグローバル設定ファイル)に置くのが安全です。スコープの詳しい使い分けは「Claude Code MCP連携ガイド」で解説しています。
ステップ3:インデックスを作る
プロジェクトのディレクトリで Claude Code を起動し、チャットで頼みます。
cd your-project-directory
claude

> Index this codebase日本語で「このコードベースをインデックスして」と頼んでもかまいません。index_codebase はバックグラウンドで動くので、すぐに応答が返ります。進み具合は「Check the indexing status(インデックスの進み具合を確認して)」で get_indexing_status を呼んでもらいます。
ステップ4:自然言語で検索する
> ユーザー認証を処理している関数を探して
> 決済処理のエラーハンドリングをしている箇所を一覧にして
Claude Code は search_code を呼び、関連するチャンクだけを取り込んで答えます。limit は既定10件・最大50件です。Claude Code はMCPツールの出力が既定で2.5万トークンを超えると打ち切るため、limit を大きくしすぎないほうが安定します。
工夫1:search_code を使ってもらうための指示を CLAUDE.md に書く
登録しただけでは、Claude Code が search_code を使わずに grep や bash で探し続けることがあります(GitHub Issue #434、2026年10月時点でオープン)。当社では、プロジェクトの CLAUDE.md に次のような指示を書く方法を勧めています(公式の推奨手順ではありません)。
## コード探索
- 関連コードを探すときは、まず claude-context の search_code を使う
- 完全一致の文字列を探すときだけ grep を使う
- インデックスが無い・古いと思ったら get_indexing_status で確認する
工夫2:PostToolUse フックで編集直後に再インデックスする
既定の同期は5分ごとなので、Claude Code がファイルを書き換えた直後は検索結果が古いことがあります。公式は、Claude Code の PostToolUse フックでトリガーファイルを更新する例を示しています。.claude/settings.json に次のように書きます。
{
  "hooks": {
    "PostToolUse": [
      {
        "matcher": "Edit|Write",
        "hooks": [
          { "type": "command", "command": "touch ~/.context/.sync-trigger" }
        ]
      }
    ]
  }
}
トリガーファイルが更新されると、2秒待ってから差分の再インデックスが始まります。複数の MCP プロセスが同じホームディレクトリを使っていても、同期を実行するのは1つだけです。フックの基本は「Claude Code Hooks 使い方」をご覧ください。
なお、Claude Code 自体をMCPサーバーとして外部から呼び出す構成は「claude-code-mcp 使い方ガイド」で解説しています。
使い方②:Cursor / Windsurf / Gemini CLI / Codex CLI での設定
claude-context はMCPの stdio に対応したクライアントなら使えます。起動コマンド(npx @zilliz/claude-context-mcp@latest)と環境変数はどのクライアントでも同じで、違うのは設定ファイルの場所と書式だけです。
クライアント | 設定ファイル | 書式 |
|---|---|---|
Claude Code |
| コマンド / JSON |
Cursor |
| JSON( |
Gemini CLI |
| JSON( |
Qwen Code |
| JSON( |
Codex CLI |
| TOML(ほかと違う) |
Claude Desktop / Windsurf / Cline / Roo Code / Cherry Studio / Void / Augment / Zencoder | 各アプリ・拡張機能のMCP設定 | JSON が中心 |
VS Code | Zilliz 公開の拡張機能「Semantic Code Search」、またはMCP対応の拡張機能 | GUI / JSON |
Cursor や Gemini CLI の JSON は、次の形です。
{
  "mcpServers": {
    "claude-context": {
      "command": "npx",
      "args": ["-y", "@zilliz/claude-context-mcp@latest"],
      "env": {
        "OPENAI_API_KEY": "your-openai-api-key",
        "MILVUS_TOKEN": "your-zilliz-cloud-api-key"
      }
    }
  }
}
Codex CLI だけは TOML で書きます(README の例)。
[mcp_servers.claude-context]
command = "npx"
args = ["@zilliz/claude-context-mcp@latest"]
env = { "OPENAI_API_KEY" = "your-openai-api-key", "MILVUS_TOKEN" = "your-zilliz-cloud-api-key" }
startup_timeout_ms = 20000 # 起動のタイムアウト(既定10秒)を延ばす。任意各ツールの概要は「Cursorとは」「OpenAI Codexとは」をご覧ください。
複数のクライアントで使うなら ~/.context/.env にまとめる
2026年10月時点の claude-context は、グローバル設定ファイル ~/.context/.env を読みます。ここにキーを書いておけば、各クライアントの設定から env を省けます。
# ~/.context/.env
EMBEDDING_PROVIDER=OpenAI
OPENAI_API_KEY=sk-your-openai-api-key
MILVUS_TOKEN=your-zilliz-cloud-api-key
優先順位は「プロセスの環境変数 → ~/.context/.env → 既定値」です。Cursor などの設定は "args": ["-y", "@zilliz/claude-context-mcp@latest"] だけで済みます。ファイルは平文なので、権限(chmod 600 など)とバックアップ先には気をつけてください。
設定を変えたら、Claude Code は /mcp reconnect claude-context、Gemini CLI は /mcp refresh で読み直します。
GitHub の操作もMCPで自動化したい場合は「github-mcp-server 使い方ガイド」も参考になります。
使い方③:ローカル完結構成(Ollama + Milvus Standalone)
社外秘コードを外に出せない場合や、APIの従量課金を避けたい場合は、埋め込みもベクトルDBも手元で動かせます。公式は「手軽さではマネージドの Zilliz Cloud を勧めるが、ローカル構成もできる」という立場です。
1. Ollama で埋め込みモデルを用意する
# 埋め込みモデルの取得(例)
ollama pull nomic-embed-text
ollama serve
Ollama のインストールや基本は「Ollamaとは」で解説しています。
2. Milvus Standalone を Docker で起動する
Milvus は、公式の Docker Compose でのインストール手順 に沿って起動します。docker-compose.yml のダウンロードURLはバージョンごとに変わるので、記事のURLを写すより公式ページの最新手順を使うのが確実です。既定のポートは 19530 です。
ハイブリッド検索には疎ベクトルの機能を使うため、古い Milvus では動かない可能性があります。公式手順に載っている現行のバージョンを使ってください。
3. claude-context の環境変数を切り替える
Claude Code なら次のように登録します。
claude mcp add claude-context \
  -e EMBEDDING_PROVIDER=Ollama \
  -e OLLAMA_HOST=http://127.0.0.1:11434 \
  -e OLLAMA_MODEL=nomic-embed-text \
  -e MILVUS_ADDRESS=127.0.0.1:19530 \
  -- npx @zilliz/claude-context-mcp@latest
Milvus で認証を有効にした場合だけ MILVUS_TOKEN を足します。この構成なら、コードは埋め込みのために外部サービスへ送られません。ただし、Claude Code 自体は質問と検索結果を Anthropic のAPIに送るので、「AIにコードを一切見せない」構成ではない点は押さえておいてください。
主要な環境変数一覧
公式の環境変数ガイド(2026年10月時点)で確認できる主な変数です。6月以降に増えたものも含めています。
変数名 | 用途 | 既定値 / 例 |
|---|---|---|
| 埋め込みプロバイダー |
|
| 使うモデル(全プロバイダー共通) | プロバイダーごとの既定(例: |
| OpenAI のキー / 接続先 | — / |
| VoyageAI のキー | — |
| Gemini のキー / 接続先 | — |
| Ollama の接続先 / モデル |
|
| Milvus / Zilliz Cloud の認証トークン | Zilliz Personal API Key を推奨 |
| Milvus の接続先 | Zilliz Personal API Key なら省略可(自動解決)。ローカルは |
| インデックス前のコレクション上限チェックのタイムアウト |
|
| ハイブリッド検索 |
|
| 埋め込みのバッチサイズ(大きいほどインデックスが速い) |
|
| 分割方式 |
|
| 追加の対象拡張子 / 除外パターン(カンマ区切り) | 例: |
| コレクション名の接頭辞(パスのハッシュは残る) | なし |
| トリガーファイルの監視 |
|
| 起動時と定期のバックグラウンド同期 |
|
| 同期の間隔 |
|
対象ファイルは「対象拡張子 − 除外パターン」で決まります。除外には既定のパターン(node_modules/** dist/** .git/** *.min.js など)に加え、.gitignore、各種 ignore ファイル、グローバルの .contextignore が足されます。2026年6月の 0.1.15 からは、.gitignore の否定パターン(!)にも対応しています。
セキュリティ・プライバシー上の注意点
社外秘コードで使うなら、確認するのは「コードがどこへ送られ、どこに残るか」「エージェント経由で余計なファイルまで読まれないか」の2点です。AIコーディング全般のリスクは「AIコーディングのセキュリティリスク」で整理しています。
1. 埋め込みAPIにコードが送られる
OpenAI・VoyageAI・Gemini を使うと、分割したコードは埋め込みのために各ベンダーへ送られます。データの保持期間や学習への利用は、各社の利用規約・API のデータポリシーで確認してください。Ollama なら外部には送られません。
2. ベクトルDBにはコードの原文も残る
ベクトルDBにはベクトルだけでなく、検索結果として返すためのコード本文とファイルパスも保存されます。Zilliz Cloud を使う場合は、コードの原文がクラウドに置かれると考えてください。データの所在地(リージョン)と暗号化の扱いは Zilliz Cloud 側で確認します。
3. APIキーは平文で保存される
claude mcp add -e で渡したキーは ~/.claude.json に、~/.context/.env に書いたキーもそのまま平文で保存されます。dotfiles を Git で管理している場合は誤ってコミットしないよう除外し、.mcp.json(project スコープ)にはキーを書かないでください。
4. 秘密情報のファイルを対象に足さない
既定では .env .env.* *.local は除外されています。ただし customExtensions や CUSTOM_EXTENSIONS で .pem .key .json .yaml などを足すと、設定ファイルに含まれる秘密情報までインデックスされてしまいます。足すときは、除外パターンもあわせて見直してください。
5. プロジェクト外のパスもインデックスできてしまう(Issue #435)
2026年9月13日に、利用者から次のような指摘が GitHub Issue #435 として報告されました。2026年10月19日時点でも未解決(オープン)です。開発元が認めた脆弱性ではなく、利用者からの報告です。
index_codebaseのpathが作業中のプロジェクト内に制限されておらず、~/.sshや~/.awsなども指定できる- インデックスすれば、
search_codeでその中身が返る - エージェントが信頼できない内容(Webページ・メール・外部ファイル)を読み、プロンプトインジェクションでこの2つを呼ばされると、情報の持ち出しにつながる
当社では、修正されるまで次の対策を勧めています。
- Claude Code の権限設定で、
mcp__claude-context__search_codeは許可リストに入れてもよいが、mcp__claude-context__index_codebaseは許可リストに入れず、毎回承認を求める - 外部のWebページや受信メールなど、信頼できない内容を読む作業と同じセッションで使わない
- インデックス先のパスを承認するときは、プロジェクトのディレクトリかどうかを必ず確かめる
Claude Code の公式ドキュメントも、サードパーティのMCPサーバーは接続前に信頼できるか確認するよう注意しています。また、.mcp.json のサーバーは対話モードでは承認を求めますが、claude -p や SDK からの実行では確認なしで読み込まれます。権限設定の全体像は「Claude Code のセキュリティ」をご覧ください。
6. 業務で使うならバージョンを固定する
@latest は常に最新版を取るので手軽ですが、意図しない更新が入る可能性もあります。業務で使うなら @zilliz/claude-context-mcp@0.1.15 のようにバージョンを固定し、更新内容を確かめてから上げる運用を当社では勧めています。
また、2026年10月時点では最新版が 0.1.15(2026年6月22日公開)で、7月以降は master への更新が止まっています。オープンの Issue と PR は合わせて147件あります。導入するときは、メンテナンスがゆるやかになっていることも判断材料に入れてください。
業種・環境別の推奨構成
業種・環境 | 推奨構成 | 理由 |
|---|---|---|
個人のOSS開発 | OpenAI + Zilliz Cloud Free | 費用がほぼかからず、設定も簡単。5リポジトリまで |
自社プロダクト・スタートアップ | OpenAI または VoyageAI + Zilliz Cloud 有料 | 手間が少なく、リポジトリ数の制限も外せる |
受託開発・SES | Ollama + ローカル Milvus | 契約先のコードを第三者のサービスに出さない |
金融・医療・官公庁 | Ollama + ローカル Milvus + 閉域網。Claude Code 自体の利用可否も社内規程で確認 | 規制・コンプライアンス対応 |
claude-context のようなOSSを手元で使うのとは別に、社内のコード検索や社内文書の検索を自社の業務システムに組み込みたい場合は、要件定義から運用まで見込んだ費用の把握が先です。組み込みの方法ごとの費用の目安は「AI開発の費用相場」でまとめています。
他のコード検索系MCPとの使い分け
claude-context は「自分のリポジトリを意味で探す」道具です。シンボル単位の操作なら Serena、ライブラリの最新ドキュメントなら Context7 と、役割が分かれています。公式FAQの説明をもとに整理すると次のとおりです。
ツール | 方式 | 得意なこと | 前提 |
|---|---|---|---|
claude-context(Zilliz) | ベクトル+BM25 のハイブリッド検索 | 自分のリポジトリを意味で横断検索する | 埋め込み手段とベクトルDB |
Serena | LSP(シンボル単位) | 定義ジャンプ・参照元の追跡・リファクタリング | 言語ごとの LSP |
Context7 | ライブラリのドキュメント取得 | 外部ライブラリの最新の使い方を取り込む | 外部サービスへのアクセス |
DeepWiki | GitHub リポジトリからドキュメントを生成 | 公開リポジトリの全体像を読む | 公開リポジトリ |
memsearch(Zilliz) | 長期記憶 | セッションをまたいで過去の作業内容を覚えておく | 詳細は公式で確認 |
選び方の目安
- 「どこで何をしているか」を意味で探したい → claude-context
- 「この関数はどこから呼ばれているか」を正確に追いたい → Serena
- 外部ライブラリの最新の使い方を聞きたい → Context7
- 公開リポジトリの構造をざっと把握したい → DeepWiki
これらは役割が重ならないので、組み合わせて使うこともできます。なお、claude-context と Serena などを第三者が同じ条件で比べたベンチマークは、2026年10月時点では見つかりませんでした。
Claude Code Auto Mode と組み合わせ、claude-context で関連コードを探しながら自律的に修正させる使い方もあります。その場合も、index_codebase を承認制にしておくと安全です。
よくあるトラブルと対処
Q1. index_codebase がエラーで止まる
node -vで Node.js が20以上か確認する- Zilliz Cloud のトークンに改行や空白が入っていないか確認する
- ローカル Milvus なら
docker compose psでコンテナが動いているか、MILVUS_ADDRESSを指定しているか確認する - 「埋め込みモデルが使えない」旨のエラーが出たら、
EMBEDDING_PROVIDERとEMBEDDING_MODELの組み合わせ、APIキーを確認する(0.1.14 からエラーとして表示されるようになった)
Q2. 「0 files, 0 chunks」と表示されて検索結果が出ない
公式FAQでは、clear_index でインデックスを消してから、同じ絶対パスで index_codebase をやり直すよう案内しています。
> このコードベースのインデックスをクリアして、最初からインデックスし直してファイル数・チャンク数は完了後に ~/.context/mcp-codebase-snapshot.json に書かれるので、インデックス作成中は件数が出ないのが正常です。関連する修正の PR は2026年10月時点でオープンのものもあり、すべて解決済みとは言えません。
Q3. Zilliz Cloud で gRPC のタイムアウトが出る
インデックス前のコレクション上限チェックは、既定で15秒でタイムアウトします。クラスターの立ち上がりが遅いときは、MILVUS_COLLECTION_LIMIT_CHECK_TIMEOUT_MS を大きくします。
-e MILVUS_COLLECTION_LIMIT_CHECK_TIMEOUT_MS=30000Q4. 「collection limit」のエラーが出る
Zilliz Cloud Free のコレクション上限(5個)に達しています。使わなくなったコードベースを clear_index で消すか、有料プランやローカル Milvus に移ります。別の場所にクローンした同じリポジトリも、別のコードベースとして1つ分に数えられます。
Q5. Claude Code が search_code を使わず grep で探し続ける
Issue #434 で報告されている現象です。CLAUDE.md に「コード探索はまず search_code を使う」と書くか、チャットで「claude-context で探して」と明示します。
Q6. 検索結果が的外れに感じる
- 埋め込みモデルを、コード向けの
voyage-code-3(VoyageAI)などに変えてみる HYBRID_MODEをfalseにしていないか確認する- 主な言語が AST 分割の対象か確認する(対象外は文字ベースの分割になる)
- 対象外の拡張子(
.vue.sqlなど)に重要なコードがないか確認する - 小さなプロジェクトなら、
@ファイル名での指定や grep のほうが早いこともある
Q7. インデックスが大きくなる・時間がかかる
CUSTOM_IGNORE_PATTERNSで生成コードやテスト用の大きなデータを除外する.gitignoreに入っているものは自動で除外されるので、まず.gitignoreを整えるEMBEDDING_BATCH_SIZEを大きくすると速くなる(APIのレート制限に注意)
Q8. ファイルを変えたのに検索結果に反映されない
既定の同期は5分ごとです。すぐ反映したいなら、PostToolUse フックでトリガーファイル(~/.context/.sync-trigger)を更新するか、force 付きで再インデックスします。同期の間隔は CLAUDE_CONTEXT_SYNC_INTERVAL_MS で変えられます。
こんな方におすすめ / おすすめしない方
claude-context がおすすめな人・組織
- Claude Code・Cursor・Codex CLI で大きなリポジトリを扱っていて、関連コード探しにトークンや時間を使いすぎている
- 「似た処理をしている場所」を意味で横断検索したい
- モノレポを運用していて、AIエージェントにリポジトリ全体を把握させたい
- 社内規程でローカル完結の構成が必要(Ollama + Milvus で対応できる)
- OSSを自分で検証し、設定を調整する手間をいとわない
claude-context をおすすめしない方
- 小さなプロジェクト:
@ファイル名や grep で十分で、ベクトルDBを用意する手間に見合わない - 定義ジャンプ・参照元の追跡が主な用途:Serena のほうが向いている
- ベクトルDBの運用を避けたいが、6つ以上のリポジトリで使いたい:無料枠に収まらず、有料プランかローカル運用が要る
- ベンダーの保守やサポートが必須の業務環境:OSSで、2026年7月以降は更新がゆるやか。未解決の Issue(#435 など)を自社で管理できる体制が要る
- 信頼できない外部コンテンツを読む作業と同じセッションで使いたい:Issue #435 の論点があるため、承認制などの対策なしには勧めにくい
よくある質問(FAQ)
Q. GitHub のスター数はどのくらい?
2026年10月19日時点で約12,600です。2026年4月に GitHub のトレンドに入って注目を集めました。最新の数は GitHub 公式リポジトリ で確認してください。
Q. 公式の「40%トークン削減」は本当?
開発元のリポジトリにある評価の結果で、平均トークン39.4%減・ツール呼び出し36.3%減です。ただし、GPT-4o-mini で SWE-bench Verified の30問を解いた開発元自身の計測で、Claude 系モデルでの数値ではありません。精度(F1)は grep だけの場合と同じでした。以前出回っていた「個別の事例で93%削減」といった数字は、2026年10月時点の公式ページでは確認できませんでした。
Q. VS Code 拡張機能もあるの?
はい。Zilliz が「Semantic Code Search」という拡張機能を VS Code Marketplace で公開しています。npm 版(MCPサーバー)との機能の違いは、Marketplace のページで最新の状況を確認してください。
Q. 最新バージョンはどこで確認できる?
GitHub Releases は更新されていないので、npm の @zilliz/claude-context-mcp で確認するのが確実です。ターミナルなら npm view @zilliz/claude-context-mcp version で確かめられます。2026年10月時点の最新は 0.1.15 です。
Q. Claude Code のサブエージェントでも使える?
MCPサーバーとして登録してあれば、サブエージェントからも search_code などを呼べます。サブエージェントの定義で tools を絞っている場合は、claude-context のツールを含めてください。サブエージェントの設定は「Claude Code サブエージェントの使い方」で解説しています。
Q. 会社のコードが学習に使われない?
claude-context 自体はデータを集めませんが、埋め込みに使うクラウドAPIとベクトルDBのサービスにはコードが渡ります。学習に使われるかどうかは各社のAPI利用規約で決まるので、契約前に確認してください。外部に出したくない場合は Ollama + ローカル Milvus を選びます。
Q. @zilliz/claude-context-core パッケージとの違いは?
@zilliz/claude-context-mcp はMCPクライアントから使うサーバーです。@zilliz/claude-context-core はインデックスと検索の本体を TypeScript のライブラリとして使うパッケージで、LangChain や LangGraph などで自作のエージェントに組み込むときに使います。
Q. チームでインデックスを共有できる?
標準の仕組みではできません。コレクション名に絶対パスのハッシュを使うため、マシンや置き場所が違うと別のコードベースとして扱われます。CODE_CHUNKS_COLLECTION_NAME_OVERRIDE で変えられるのは接頭辞だけで、ハッシュの部分は残ります。
Q. Gemini の新しい埋め込みモデルにも対応している?
2026年5月の 0.1.13 で Gemini Embedding 2(gemini-embedding-2)に対応しました。EMBEDDING_PROVIDER=Gemini と EMBEDDING_MODEL=gemini-embedding-2 を指定します。VoyageAI の voyage-4 系も対応モデルに入っています。
まとめ:claude-context を最短で導入する3つの判断ポイント
- まず構成を決める:試すだけなら OpenAI + Zilliz Cloud Free(5リポジトリまで)。社外秘コードなら Ollama + ローカル Milvus
claude mcp addで登録する:Zilliz の Personal API Key ならMILVUS_ADDRESSは省略できる。キーは.mcp.jsonに書かず、~/.context/.envなどに置く。Codex CLI だけは TOML で書く- インデックス → 状態確認 → 検索で動作を確かめる:使ってもらえないときは CLAUDE.md に指示を書き、編集をすぐ反映したいなら PostToolUse フックを足す。業務で使うならバージョン固定と
index_codebaseの承認制もセットにする
2026年10月時点で、最新版は 0.1.15(6月公開)です。Node.js 24 への対応や Zilliz Cloud 無料枠の内容など、春ごろの情報から変わった点がいくつもあります。料金・対応バージョン・未解決の Issue は、Zilliz Cloud 料金ページ と GitHub 公式リポジトリ で確認してから導入してください。
関連記事
- Claude Codeの全体像を知りたい方は「Claude Codeとは」
- Claude Code の料金・プランを比べたい方は「Claude Code 料金」
- MCPという仕組みを理解したい方は「MCPとは(Model Context Protocol)」
- MCPサーバーの登録やスコープを詳しく知りたい方は「Claude Code MCP連携ガイド」
- Claude Code 自体をMCPサーバーとして動かす方法は「claude-code-mcp 使い方ガイド」
- GitHub の操作をMCPで自動化したい方は「github-mcp-server 使い方ガイド」
- Claude Code の自律実行モードについては「Claude Code Auto Mode とは」
- コーディング支援AIを比べるなら「AIコーディングツール おすすめ 比較」
このツールを自社のシステムや業務にどう組み込むか、ご提案します
この記事の著者

AI革命
編集部
AI革命株式会社の編集部です。最新のAI技術動向から実践的な導入事例まで、企業のデジタル変革に役立つ情報をお届けしています。豊富な経験と専門知識を活かし、読者の皆様にとって価値のあるコンテンツを制作しています。
最新記事
Claudeで攻撃対象領域を削減|OpenSSHの認証前コード約5分の1を削った手法とsshd運用者の対応【2026年10月】
2026/10/21
AIコーディング初心者の始め方【2026年10月】無料ツール・料金・注意点をレベル別に整理
2026/04/02
レセプトチェック自動化の費用|レセチェッカー価格は月6,000円〜、残る作業の削減時間と開発費の回収【2026年10月最新】
2026/09/07
Qwen 3.5-Omniとは?機能・料金・3バリアントの違い・後継3.8-Omni-FlashやGPT・Geminiとの比較を解説
2026/04/06
ChatGPTスーパーアプリとは?全7機能・料金・日本での使い方を徹底解説【2026年10月】
2026/04/10
AIブラウザおすすめ11選を徹底比較|料金・安全性・用途別の選び方【2026年10月最新】
2026/04/11