Arcee AI Trinity Largeとは?400BオープンウェイトLLMの性能・料金・使い方を徹底解説【Apache 2.0→OpenMDW変更も】
この記事のポイント
Arcee AI Trinity Largeは、米Arcee AIが一から学習した約400B(稼働約13B)のMoE型オープンウェイトLLMです。2026年10月時点の料金(入力$0.25/出力$0.80)、Apache 2.0からOpenMDW-1.1へのライセンス変更、ベンチマーク、API・vLLMでの使い方、セルフホストに必要なメモリを解説します。
Arcee AI Trinity Largeは、米国のスタートアップArcee AIが一から事前学習した総パラメータ約400B(1トークンあたり約13Bだけが動く)スパースMoE型のオープンウェイトLLMです。主力の推論版「Trinity-Large-Thinking」は、2026年10月時点のArcee公式APIで入力$0.25/出力$0.80(100万トークンあたり)です。公開当初はApache 2.0として発表されましたが、2026年5月29日に全TrinityモデルのライセンスがOpenMDW-1.1へ変更されています。
この記事でわかることは次のとおりです。
- Trinity Largeのスペックと、Preview / Base / TrueBase / Thinking の違い
- ベンチマークから見た得意・不得意(比較相手は公式公表の2026年4月時点モデル)
- 現行料金(Arcee API / OpenRouter / セルフホスト)と、Claude Opus 5.5などとの費用試算
- Apache 2.0からOpenMDW-1.1への変更点と、企業が確認すべきこと
- Arcee API・OpenRouter・vLLMでの使い方と、マルチターン実装でつまずきやすい点
- 量子化形式ごとの重みサイズ(実測)と、セルフホストに必要なGPUの目安
想定読者: APIコストを下げたいエンジニア・PM、AIエージェントの基盤モデルを選ぶ開発者、米国製のオープンウェイトモデルを自社環境で動かしたい企業のIT・法務担当者。
出典: Arcee AI 公式ブログ
Arcee AI Trinity Largeとは
Trinity Largeは、重みが公開されていて自社環境でも動かせる、約400BパラメータのスパースMoE型LLMです。全体は約400B(Hugging Faceの表記では約398B)ありますが、1トークンの処理で動くのは約13Bだけなので、規模の割に推論が軽く、API料金も低く抑えられています。
開発元のArcee AIは米国のスタートアップです。2026年9月16日にSeries Bを発表し、公式には「評価額10億ドル超」とされています(調達額は非公表。報道では1.5億ドル以上)。Vista Equity Partners、Cambium Capital、Emergence Capitalがリードし、日立、M12(Microsoft)、Wiproなども参加しました。同じ発表で、次世代のTrinityを学習中であることも公式に明かしています(名称・時期は未発表)。
主要スペック(2026年10月時点)
項目 | 内容 |
|---|---|
開発元 | Arcee AI(米国) |
総パラメータ | 約400B(HFの表記は約398B) |
1トークンあたりの稼働パラメータ | 約13B |
アーキテクチャ | スパースMoE。エキスパート256(うち共有1)から4つを選ぶ(ルーティング比率1.56%)、Dense層6 |
コンテキスト長 | モデル本来は512K。APIで使えるのは262,144トークン(最大出力80,000) |
入出力 | テキストのみ(画像・音声入力は公式に記載なし) |
ライセンス | OpenMDW-1.1(2026年5月29日にApache 2.0から変更) |
提供形態 | 重みをHugging Faceで公開/Arcee API/OpenRouter など |
事前学習 | 17兆トークン(10T+4T+3Tの3段階。データ整備はDatologyAI) |
学習環境 | NVIDIA B300 GPU 2,048基、事前学習本体は33日 |
学習コスト | 約2,000万ドル(Trinity Largeを含む2025年のモデル群全体。Arcee の自己申告) |
技術レポート |
なぜ「米国製のオープンウェイトモデル」として注目されているのか
オープンウェイトの大型モデルは、DeepSeek・GLM・Kimi・Qwenなど中国勢が先行してきました。Trinity Largeは米国企業が一から学習した400B級のオープンウェイトモデルという点で、調達の要件として中国製モデルを避けたい組織から選ばれやすい立ち位置にあります。TechCrunchやVentureBeatも同じ観点で取り上げています。中国製モデルが広がった背景は中国製AIモデルの台頭で整理しています。
利用実績はArceeとNVIDIAの発表ベースで、Previewは公開から2か月でOpenRouter上の処理量が3.37兆トークン、Thinkingは公開から3週間足らずでKilo Codeで552億トークン、OpenClawで256億トークンを処理したとされています(NVIDIA事例)。
Trinityファミリーの全体像:Nano / Mini / Large
Trinityシリーズは小型のNano、中型のMini、大型のLargeの3階層です。NanoとMiniは2025年12月1日、Largeは2026年1月27日に公開され、推論版のLarge-Thinkingが2026年4月1日に加わりました。
モデル | 規模 | 主な用途 | 現在の提供 |
|---|---|---|---|
Trinity Nano Preview | 6B MoE(稼働は約1B。第三者のまとめによる値) | エッジ・組み込み | 重みをHFで公開 |
Trinity Mini | 26B MoE | 軽めの本番用途・オンプレ | 重みをHFで公開(OpenRouterの現行一覧には無し) |
Trinity Large(Preview / Base / TrueBase) | 約400B MoE(稼働13B) | 汎用対話・研究・追加学習の起点 | 重みをHFで公開 |
Trinity-Large-Thinking | 約400B MoE(稼働13B) | 推論・エージェント・長時間タスク | 重みを公開+Arcee API/OpenRouterで提供 |
選ぶ目安は次のとおりです。
- APIで使うなら、現在ホストされているのはTrinity-Large-Thinkingだけ(2026年10月23日時点のOpenRouterモデル一覧では、Arceeのモデルはこの1つ)
- 自社でゼロから調整したいならBaseかTrueBase
- 小さなGPUで動かしたいならMiniかNano(性能はLargeより大きく下がる)
Trinity Largeの4バリアント
バリアント | 中身 | おすすめの使い方 |
|---|---|---|
Trinity-Large-Preview | 軽い事後学習のみ。推論(thinking)なしのinstructモデル | 汎用対話。無料提供は「少なくとも2026年2月まで」と告知されていた期間限定で、現在のOpenRouter一覧には無い |
Trinity-Large-Base | 17兆トークンの全工程を終えた最良の事前学習チェックポイント | 研究・独自ファインチューニングの起点 |
Trinity-Large-TrueBase | 10兆トークン時点の初期チェックポイント。instructデータも学習率アニールも入っていない | 規制業種などが自社データだけで一から調整したい場合 |
Trinity-Large-Thinking | 推論とエージェント用途に特化した事後学習版 | 本番のエージェント・長時間タスク(現行の主力) |
いま「Trinity Large」と言えば、ほとんどの場合Thinking版を指します。<think>...</think> で考えた過程を出力してから回答し、ツール呼び出しを含むマルチターンの処理に合わせて調整されています。
なぜ400Bなのに速いのか:スパースMoEの仕組み
Trinity Largeが400Bでも速いのは、1トークンごとに256のエキスパートから4つだけを選んで計算するからです。全体の知識量は400B分ありながら、毎回の計算量は約13B分で済みます。
MoEを直感的に理解する
256人の専門家がいる組織で、案件ごとに最適な4人(+全案件に入る共通担当1人)だけを呼ぶ、とイメージするとわかりやすいです。組織全体の知識は保ったまま、毎回の人件費(計算量)は小さく抑えられます。
この設計から、次の特徴が出てきます。
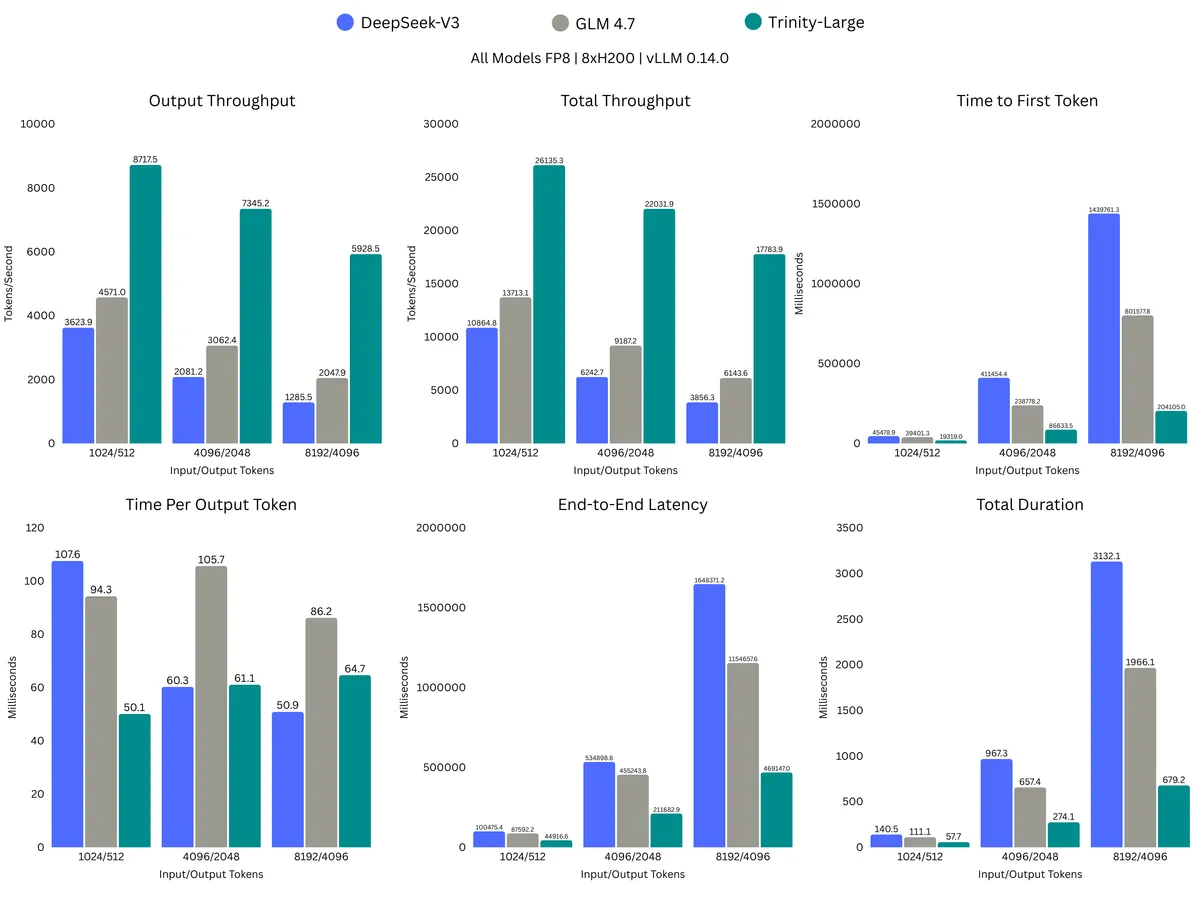
- 推論が速い: Artificial Analysisの第三者計測では、出力速度は約350トークン/秒、最初の回答トークンが出るまで約6.8秒(推論時間を含む)
- API料金が安い: 計算量が小さいぶん、400B級としては低い単価で提供されている
- ただしメモリは400B分必要: 動くのは13Bでも、重みはすべてGPUメモリに載せる必要がある。セルフホストが重いのはこのため
Trinity Large固有の技術的工夫
技術レポートでは、大規模MoEを安定して学習させるための工夫が公開されています。
- SMEBU(Soft-clamped Momentum Expert Bias Updates): エキスパートの負荷分散を、符号ベースの更新からtanhによる連続的な更新に置き換えた手法。特定のエキスパートに処理が偏るのを防ぐ
- Muonオプティマイザの併用: 埋め込み層・出力層はAdamW、中間層はMuonで最適化
- ローカル/グローバル注意の組み合わせ: ローカル(RoPE)とグローバル(NoPE)の注意層を3:1で交互に配置
- 3段階の学習カリキュラム: 後の段階ほど数学・コードの比率を高める
出典: Arcee AI 公式ブログ
ベンチマーク性能:得意なこととそうでないこと
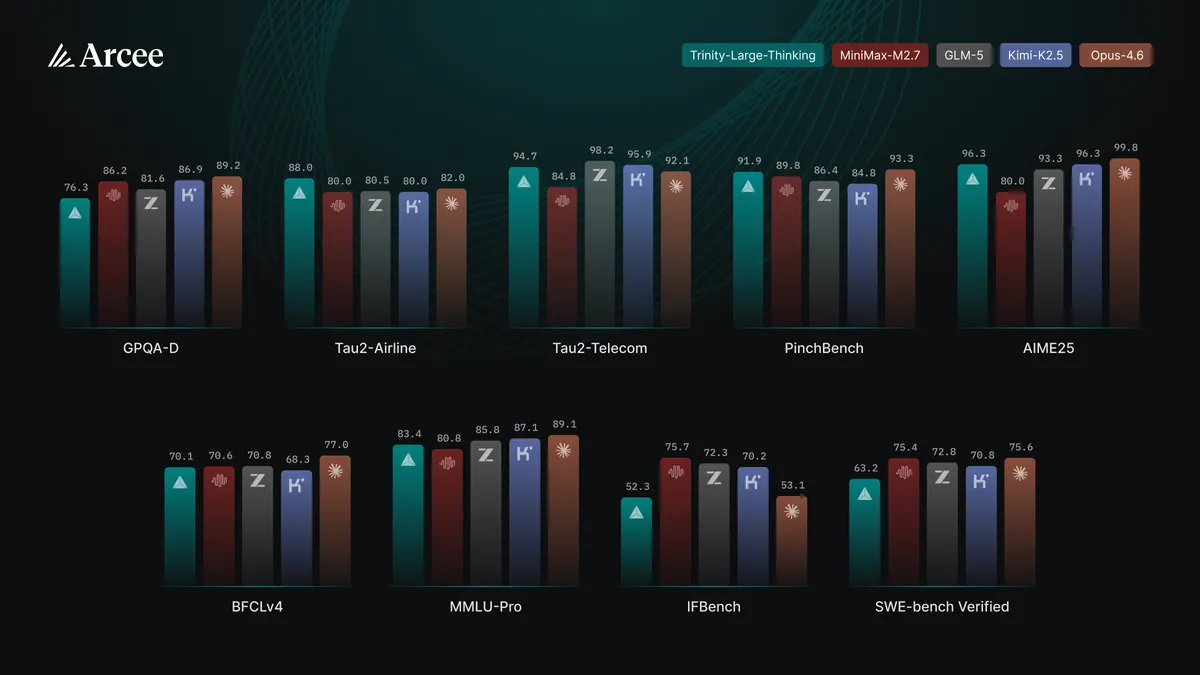
公式のベンチマークでは、ツールを使うエージェント系の評価は上位、知識・科学推論・指示追従・コーディングは見劣りします。「何でも最高」ではなく、エージェント用途に寄せた低価格モデルとして見るのが実態に近いです。
主要ベンチマーク(Trinity-Large-Thinking)
数値はHugging Faceのモデルカードに載っているArceeの自己申告です。比較相手は2026年4月の公開時点のモデル(Claude Opus 4.6、GLM-5、Kimi K2.5など)で、現行のClaude Opus 5.5やGLM-5.3、Kimi K3とは比べていません。
ベンチマーク | 測るもの | Trinity-Large-Thinking | Claude Opus 4.6 | GLM-5 | Kimi K2.5 |
|---|---|---|---|---|---|
Tau2-Airline | ツールを使った顧客対応 | 88.0 | 82.0 | 80.5 | 80.0 |
Tau2-Telecom | 同上(通信) | 94.7 | 92.1 | 98.2 | 95.9 |
PinchBench | エージェントの総合力 | 91.9 | 93.3 | 86.4 | 84.8 |
AIME25 | 数学 | 96.3 | 99.8 | 93.3 | 96.3 |
GPQA-Diamond | 大学院レベルの科学 | 76.3 | 89.2 | 81.6 | 86.9 |
MMLU-Pro | 幅広い知識 | 83.4 | 89.1 | 85.8 | 87.1 |
BFCLv4 | 関数呼び出し | 70.1 | 77.0 | 70.8 | 68.3 |
IFBench | 指示追従 | 52.3 | 53.1 | 72.3 | 70.2 |
SWE-bench Verified | 実務のコード修正 | 63.2 | 75.6 | 72.8 | 70.8 |
モデルカードの文中に「LiveCodeBench 98.2%」という記述がありますが、表の数値と食い違うという指摘があるため、本記事では扱っていません。
第三者の評価では、Artificial Analysisの総合指数(Intelligence Index)は11です(2026年10月閲覧)。数値だけでは高いか低いかわかりにくいので、同サイトで比較したいモデルと並べて見るのがおすすめです。
得意領域・苦手領域の整理
得意なのは次の点です。
- 複数ターンにわたるツール呼び出し、エージェントのループ処理(Tau2、PinchBench)
- 数学の推論(AIME25)
- 同じ価格帯での速さと安さ
苦手なのは次の点です。
- 実務のソフトウェア開発(SWE-bench Verified 63.2)。Arcee自身もブログで「一夜で最強のオープンなコーディングモデルになるとは思っていない」と書いている
- 大学院レベルの科学推論・幅広い知識(GPQA-Diamond、MMLU-Pro)
- 細かい指示の厳密な追従(IFBench 52.3。GLM-5やKimi K2.5より大きく低い)
- 画像・音声の入力(テキストのみ)
- 日本語(公式の日本語評価なし)
出典: Arcee AI 公式ブログ
料金体系:$0.25/$0.80・「Opus比96%安」の実態
出典: OpenRouter
2026年10月23日時点のArcee公式APIの料金は、入力$0.25/出力$0.80/キャッシュ入力$0.06(いずれも100万トークンあたり)です。公開時(2026年4月)の出力$0.90から下がっています。
「Opus比96%安」は、もともとArceeが4月に出力$0.90とClaude Opus 4.6の出力$25を比べて示した数字です。現行の最新モデルClaude Opus 5.5(入力$4/出力$20)と比べ直すと、出力単価は約25分の1(約96%安)、入力単価は16分の1で、割合としてはほぼ変わりません。ただし、価格が安いことと性能が同じことは別の話です。
プラットフォーム別料金(2026年10月時点)
提供先 | 入力 / 100万トークン | 出力 / 100万トークン | 備考 |
|---|---|---|---|
Arcee 公式API | $0.25 | $0.80 | キャッシュ入力$0.06。プリペイドのウォレットにチャージして使う |
OpenRouter | $0.25 | $0.80 | キャッシュ読み取り$0.06。プロバイダはArcee AIの1社のみ。クレジット購入時にOpenRouterの手数料がかかる |
Vercel AI Gateway | 公式ページで確認 | 公式ページで確認 |
|
セルフホスト | 無料(ライセンス料なし) | 無料 | 費用はGPUのみ |
(参考)Claude Opus 5.5 | $4.00 | $20.00 | クローズドモデル(Anthropic公式) |
2026年5月時点で提供されていたOpenRouterの無料版(:free)やTrinity Large Previewは、10月23日時点のOpenRouterモデル一覧に載っていません。NVIDIAの事例ページにはAmazon Bedrockでの提供も記載されていますが、AWS側の公式カタログでは確認できていません。
月間コストの試算
エージェント用途を想定し、月に入力1億トークン・出力2,000万トークンを使った場合の概算です(キャッシュ割引は考慮せず。Trinity以外のオープンモデルはArcee API上の価格で計算)。
モデル | 入力の費用 | 出力の費用 | 月額の合計 | 1ドル150円での目安 |
|---|---|---|---|---|
Trinity-Large-Thinking | $25 | $16 | $41 | 約6,200円 |
DeepSeek V4 Flash | $14 | $5.6 | $19.6 | 約2,900円 |
GLM-5.3 | $140 | $88 | $228 | 約34,000円 |
Kimi K3 | $300 | $300 | $600 | 約90,000円 |
Claude Opus 5.5 | $400 | $400 | $800 | 約120,000円 |
Trinityは最安ではありません。同じArcee APIの中ならDeepSeek V4 Flashのほうが安く、Trinityを選ぶ理由は「米国製であること」や「エージェント系の評価」に置くほうが筋が通ります。DeepSeek V4系の詳細はDeepSeek V4 Flashとはを参照してください。
セルフホスト(Hugging Face)
重みのダウンロードとライセンス料は無料ですが、GPUの費用がかかります。2026年10月23日にHugging Faceの公式リポジトリ(arcee-ai配下)で、Thinking版の重みの合計サイズを確認した結果は次のとおりです。
形式 | 重みの合計サイズ |
|---|---|
BF16(原本) | 約797GB |
Q8_0(GGUF) | 約424GB |
FP8-Block | 約404GB |
Q4_K_M(GGUF) | 約242GB |
NVFP4 | 約235GB |
W4A16 / IQ4_XS(GGUF) | 約213GB |
Q2_K(GGUF) | 約139GB |
IQ1_S(GGUF) | 約81GB |
実際に動かすには、このサイズに加えてKVキャッシュ(会話の文脈を保持するメモリ)の分が必要です。
価格の安さが生きるケース・生きないケース
価格差が大きな意味を持つのは次のケースです。
- 出力が長いエージェント処理や計画タスク
- 大量のバッチ処理、社内向けAPIとしての常用
- 月に数億〜数十億トークンを使う規模
価格差が小さくなるのは次のケースです。
- 出力が短い分類・抽出(もともとの金額が小さく、品質やサポートの差のほうが大きく影響する)
- 月数十万トークン程度の試験運用
- 品質不足でやり直しが増える用途(コーディングや厳密な指示追従など)
使い方:OpenRouter・Arcee公式API・vLLM・Hugging Face
出典: Hugging Face(arcee-ai/Trinity-Large-Thinking)
すぐ試すならArcee公式APIかOpenRouter、データを外に出せないならvLLMなどでのセルフホストです。どちらもOpenAI互換のAPIで呼べるため、既存のChatGPT/Claude向けコードはエンドポイントとモデル名を差し替えれば動きます。画面で試したいだけならチャットUIのchat.arcee.aiもあります(料金・無料枠の条件は未確認)。
1. OpenRouter経由(最短)
ほかのモデルと同じAPIキーで切り替えて使いたい場合に便利です。OpenRouterの仕組みはOpenRouterとはで解説しています。
from openai import OpenAI

client = OpenAI(
    base_url="https://openrouter.ai/api/v1",
    api_key="YOUR_OPENROUTER_API_KEY",
)

response = client.chat.completions.create(
    model="arcee-ai/trinity-large-thinking",
    messages=[
        {"role": "user", "content": "社内問い合わせ対応エージェントの処理手順を設計してください"}
    ],
)
print(response.choices[0].message.content)
以前案内されていた arcee-ai/trinity-large-preview:free などの無料モデルIDは、2026年10月23日時点のOpenRouter一覧にありません。
2. Arcee公式API
ベースURLは https://api.arcee.ai/api/v1 です(docs.arcee.ai)。platform.arcee.aiでアカウントを作り、ウォレットにチャージしてからAPIキーを発行します。
from openai import OpenAI

client = OpenAI(
    base_url="https://api.arcee.ai/api/v1",
    api_key="YOUR_ARCEE_API_KEY",
)

response = client.chat.completions.create(
    model="trinity-large-thinking",
    messages=[{"role": "user", "content": "この手順書の抜け漏れを指摘してください"}],
)
print(response.choices[0].message.content)
Arcee APIは2026年8月13日に「Open Models API(Beta)」に拡張され、同じAPIキーでDeepSeek V4、GLM-5.3、Kimi K3など他社のオープンウェイトモデルも呼べるようになりました。一部のモデルはFireworks AIなど外部パートナー経由で配信されています。同じ日には、長時間のエージェント作業を動かすためのOSSハーネス「nac」(Apache 2.0、MCPサーバー同梱)も公開されています。
3. vLLM セルフホスト(公式推奨)
Hugging FaceのモデルカードではvLLM 0.11.1以上を推奨し、推論過程とツール呼び出しを分けて受け取る設定を載せています。
vllm serve arcee-ai/Trinity-Large-Thinking \
  --dtype bfloat16 \
  --reasoning-parser deepseek_r1 \
  --enable-auto-tool-choice \
  --tool-call-parser qwen3_coder
推奨パラメータは出典によって違います。HFのモデルカードは temperature=0.45〜0.6、top_p=0.95、top_k=50、公式ドキュメントの例は temperature=0.3 です。まずはモデルカードの値で始め、用途に合わせて調整するのが無難です。SGLangにも対応しています。
4. Hugging Face Transformers・GGUF
from transformers import AutoTokenizer, AutoModelForCausalLM
import torch

model_id = "arcee-ai/Trinity-Large-Thinking"
tokenizer = AutoTokenizer.from_pretrained(model_id)
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    torch_dtype=torch.bfloat16,
    device_map="auto",
    trust_remote_code=True,
)
GGUF版はllama.cpp、Ollama、LM Studioで読み込めます。Ollamaの基本はOllamaとはを参照してください。
マルチターンの重要な注意点
Thinking版を会話やエージェントで使うときは、前のターンの思考(推論過程)を消さずに次のリクエストへ渡す必要があります。モデルカードに書かれている注意点は次のとおりです。
- アシスタントの発話に含まれる
reasoning_contentを履歴に残したまま送る(OpenRouter経由ならreasoning_detailsをそのまま戻す) - ツールを呼び出したターンでは、content を
nullではなく空文字""にする - 履歴が長くなったら、直近の思考だけを消すのではなく、古いターンを丸ごと削る
reasoningとreasoning_contentのフィールド名を取り違えない
思考を履歴から消すと、特に多段のタスクでツール呼び出しがおかしくなりやすくなります。他モデル向けに作ったエージェントを流用するときに引っかかりやすい点です。
セルフホストの現実的なハードウェア要件
重みのサイズから見た目安です(KVキャッシュ分の余裕を含めた概算。実際の構成は推論エンジンや同時接続数で変わります)。
形式 | 重みのサイズ | GPU構成の目安 |
|---|---|---|
BF16 | 約797GB | H200(141GB)×8 や B200 クラスの8基構成。H100 80GB×8(640GB)には載らない |
FP8 | 約404GB | H100 80GB×8、H200×4〜8 |
4bit(NVFP4 / W4A16 / Q4系) | 約213〜242GB | H100 80GB×4〜8 |
2bit以下(Q2_K / IQ1_S) | 約81〜139GB | 大容量ユニファイドメモリのMacなどで試せる可能性はあるが、動作・速度は未確認 |
24〜32GBの一般的なGPUやノートPCでは動きません。実際の選択肢は、クラウドGPUを時間単位で借りるか、APIを使うか、規制要件があって自社データセンターに複数GPUのサーバーを置くか、のいずれかです。
このツールを自社のシステムや業務にどう組み込むか、ご提案します
初回相談は無料・30分(オンライン)。要件が決まっていなくても大丈夫です。改修100万円〜・PoC300万円〜(税別)
ライセンス:Apache 2.0からOpenMDW-1.1へ(エンタープライズへの影響)
Trinityの全モデルは2026年5月29日からOpenMDW-1.1で提供されています。Nano・Mini・Large・Large-Thinkingと全量子化版が対象で、すでに公開済みのモデルにもさかのぼって適用されました(公式発表)。Hugging Faceのモデルカードも5月28日に更新されています。
Arceeは変更理由を「Apache 2.0はソースコード向けのライセンスで、重み・設定・評価資料などを明確に扱っていない。OpenMDWならモデルに関わる資料を1本のライセンスでまとめられる」と説明しています。利用分野の制限や別途の商用ライセンスはなく、商用利用・セルフホスト・追加学習・蒸留・改変・再配布ができる、というのがArceeの立場です。NVIDIAも今後のCosmos、Isaac GR00T、NemotronでOpenMDW-1.1を採用予定としています。
なお、2026年10月時点でも、公式ドキュメント(docs.arcee.ai)のモデルページとNVIDIAの事例ページはApache 2.0と書いたままです。現行の条件はHugging Faceのリポジトリに置かれたLICENSEで確認してください。Apache 2.0の時期にダウンロードした重みがどちらの条件で扱われるかについて、公式の説明はありません。
OpenMDW-1.1の要点
公式の条文から、企業の利用で押さえたい点をまとめます。
区分 | 内容 |
|---|---|
対象 | モデル(アーキテクチャ・パラメータ)と関連する資料(データ・ドキュメント・ソフトウェア)をまとめて「Model Materials」として扱う |
許諾 | 著作権・特許・データベース権・営業秘密を含めて、無償・無制限に利用を許諾 |
出力 | 生成物の利用・改変・共有には制限も義務もない |
再配布時の義務 | ライセンスの写しと、著作権表示などの由来表示を残す |
許諾の終了 | 本モデルが特許・著作権を侵害していると訴えた場合は許諾が終わる(相手からの訴えへの反訴は除く) |
保証 | 無保証。学習データに含まれる他者の著作権など、第三者の権利の確認は利用者の責任と明記 |
OSI承認 | 2026年8月にOSIへ承認申請が出ているが、承認されたかは未確認 |
主要ライセンスとの比較
ライセンス | 主な対象 | 商用利用 | 改変・再配布 | 利用規模の条件 | 特許の扱い |
|---|---|---|---|---|---|
OpenMDW-1.1(Trinity 現行) | 重み・データ・ドキュメントなどモデル一式 | ○ | ○(ライセンスの写しと表示を残す) | なし | 許諾あり |
Apache 2.0(Trinity 公開当初) | ソースコード | ○ | ○(表示・変更告知が必要) | なし | 許諾あり |
MIT | ソースコード | ○ | ○(表示を残す) | なし | 明示なし |
Llama 4 Community License | Meta独自 | △ | △(条件あり) | 月間7億ユーザー超は別途許諾 | — |
クローズド(Claudeなど) | APIの利用規約 | 規約の範囲内 | × | 規約による | — |
TrueBaseが規制産業に好まれる理由
TrueBaseは10兆トークン時点のチェックポイントで、指示応答用のデータも学習率の調整も入っていない「素の」ベースモデルです。VentureBeatなどは、金融・医療・防衛のように「他社が施したチューニングが入っていない状態から、自社データだけで調整したい」組織に向くと紹介しています。
主要モデルとの比較
Trinity Largeの比較相手は、同じくオープンウェイトのDeepSeek V4・GLM-5.3・Kimi K3・Llama 4 Maverickと、クローズドのClaude Opus 5.5です。性能を同じ条件で並べたデータはないため、ここでは料金・開発国・提供形態で比べます。
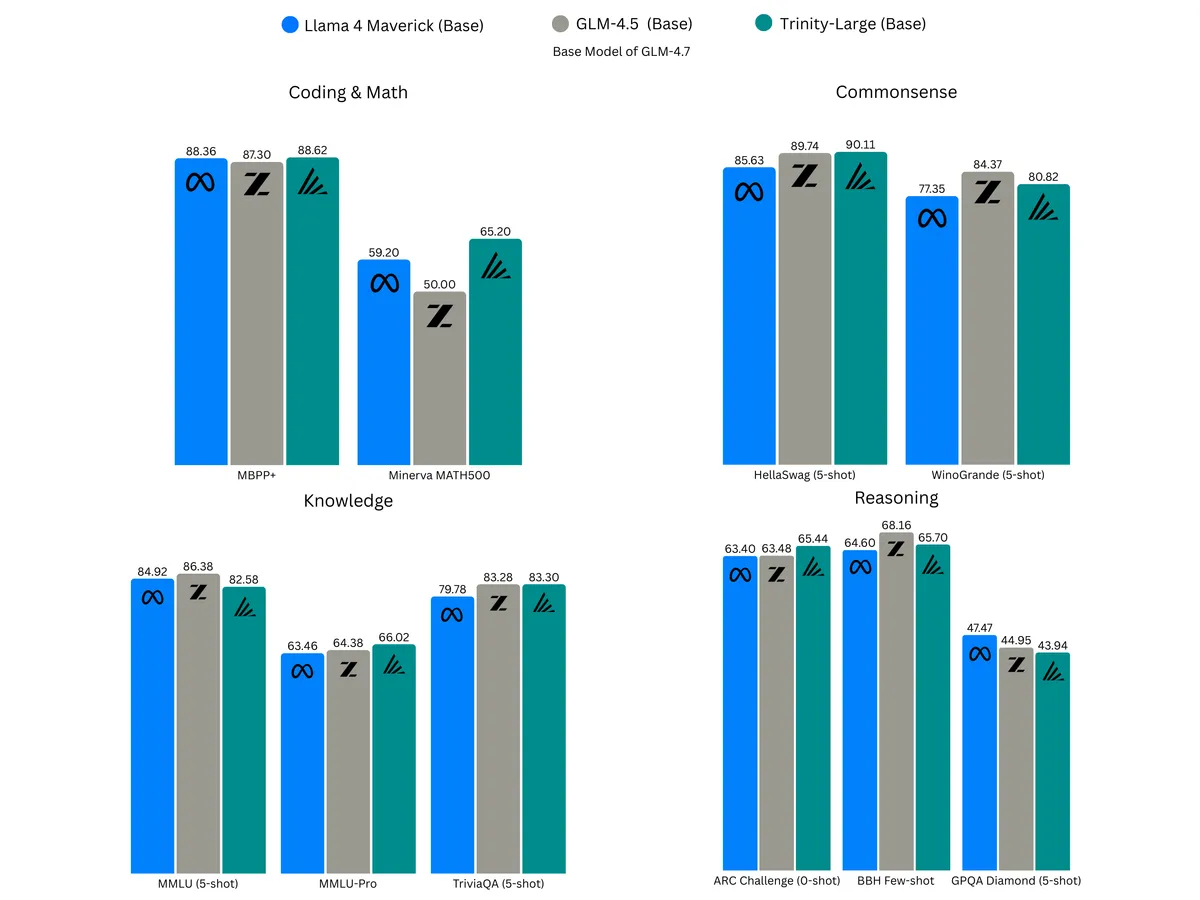
出典: Arcee AI 公式ブログ
項目 | Trinity-Large-Thinking | DeepSeek V4 Flash | GLM-5.3 | Kimi K3 | Llama 4 Maverick | Claude Opus 5.5 |
|---|---|---|---|---|---|---|
開発国 | 米国 | 中国 | 中国 | 中国 | 米国 | 米国 |
形態 | オープンウェイト | オープンウェイト | オープンウェイト | オープンウェイト | オープンウェイト | クローズド |
規模 | 約400B(稼働13B) | 各モデルカード参照 | 各モデルカード参照 | 各モデルカード参照 | 約400B(稼働17B) | 非公開 |
入力 / 出力(100万トークン) | $0.25 / $0.80 | $0.14 / $0.28 | $1.40 / $4.40 | $3.00 / $15.00 | 配信先ごとに異なる | $4 / $20 |
ライセンス | OpenMDW-1.1 | 各モデルカード参照 | 各モデルカード参照 | 各モデルカード参照 | Llama 4 Community License | 利用規約 |
セルフホスト | ○ | ○ | ○ | ○ | ○(条件あり) | × |
DeepSeek V4・GLM-5.3・Kimi K3の料金はArcee API上の価格、Claude Opus 5.5はAnthropic公式の価格です(2026年10月23日時点)。各モデルの詳細はGLM-5.3とは、Kimi K3とは、Llama 4 Maverickとは、Claude Opus 5.5とはで解説しています。
用途別おすすめ
用途 | 第一候補 | 理由 |
|---|---|---|
エージェント中心・大量のAPI呼び出し・コスト重視 | Trinity-Large-Thinking | Tau2・PinchBenchが上位で、出力$0.80 |
米国製のオープンウェイトが調達条件 | Trinity Large / Llama 4 Maverick | 中国製モデルを避けたい場合の選択肢 |
とにかく安く大量に処理したい | DeepSeek V4 Flash | 同じArcee APIでもTrinityより安い |
本格的なコード生成・リファクタリング | Claude Opus 5.5 / Claude Code | TrinityのSWE-bench Verifiedは63.2 |
画像・音声の入力が必要 | Llama 4 Maverick / Claude | Trinityはテキストのみ |
日本語の業務文書を高い精度で扱う | Claudeなど日本語の実績があるモデル | Trinityは日本語の公式評価なし |
自社データで一から調整したい | Trinity-Large-TrueBase / Base | 指示応答の調整前の重みが公開されている |
「Trinity Large vs 中国製オープンモデル」の選択ポイント
- 調達条件や地政学リスクを重く見る組織 → Trinity Large(米国製)
- 価格と性能だけで選ぶ → DeepSeek V4やGLM-5.3も有力。指示追従(IFBench)は中国製モデルのほうが高い項目がある
- 同じAPIで試し比べたい → Arcee Open Models APIなら、Trinity・DeepSeek V4・GLM-5.3・Kimi K3を同じキーで切り替えられる
DeepSeek V4についてはDeepSeek V4とはも参照してください。
できないこと・制約・注意点
Trinity Largeは安くて速い一方で、苦手分野と運用上の制約がはっきりしています。「Opus比96%安」だけを見て置き換えると、品質やサポートの面でつまずきます。
制約 | 詳細 |
|---|---|
テキストのみ | 画像・音声の入力は公式に記載なし |
APIのコンテキストは262K | 512Kを使い切れるのはセルフホスト時のみ(それでもKVキャッシュ分のメモリが必要) |
セルフホストが重い | BF16で約800GB、4bitでも210〜240GB。個人や小規模のオンプレ運用は現実的でない |
コーディングは最前線ではない | SWE-bench Verified 63.2(Opus 4.6は75.6) |
知識・科学推論が弱め | GPQA-Diamond 76.3、MMLU-Pro 83.4 |
指示追従が弱め | IFBench 52.3(GLM-5は72.3) |
日本語の公式評価がない | 品質は自社で確かめる必要がある |
ベンチマークは自己申告 | 比較相手も2026年4月時点の旧世代モデル |
APIの提供元が実質1社 | OpenRouterでもプロバイダはArcee AIのみ。障害時に冗長化しにくい |
データの扱いが文書化されていない | ArceeはXで「API出力を監視・学習に使わない」と表明しているが、公式のデータ保持ポリシー文書やホスト地域は未確認 |
企業導入前にチェックすべき項目
- 自社データでの実測: 公開ベンチマークではなく、自社の業務データで品質とコストを測る。日本語を使うなら特に必須
- 予備のモデルを用意する: APIの提供元が1社なので、本番では別モデルへの自動切り替えを組んでおく
- コンテキストの上限: APIは262Kまで。それ以上が必要ならセルフホストを検討する
- データの送り先: 機密データを扱うならセルフホストを第一に考える。APIを使う場合は保持・学習利用の条件をArceeに確認する
- ライセンスの確認: OpenMDW-1.1は第三者の権利の確認を利用者に求めているため、規制業種は法務の確認を通す
- エージェントの権限設計: OpenClawなどに組み込むときのリスクはモデルよりも、ファイル操作・シェル実行・外部送信などエージェント側の権限にある(OpenClawの危険性を参照)
Trinityのような新しいモデルを自社の業務システムに組み込む場合、API連携で済むのか、セルフホストのGPU環境まで作るのかで費用は大きく変わります。PoCから本開発までの金額の目安はAI開発の費用相場にまとめています。
こんな人・組織におすすめ
次のどれかに当てはまるなら、Trinity-Large-Thinking(または用途に合ったバリアント)は有力な候補です。
1. エージェント処理のAPIコストを下げたい開発チーム
Claude OpusなどのAPI費用が重く、ツール呼び出し中心の処理ならTrinityの品質で足りる場合、コスト差が大きな意味を持ちます。OpenClaw、Hermes Agent、Kilo Code、Cline、OpenCodeなどのエージェントでの利用を公式がうたっています。
2. データを外部に出せない規制業種
金融・医療・公共などで機密データを外部APIに送れない組織は、重みをダウンロードして自社の環境だけで推論基盤を作れます。
3. 米国製のオープンウェイトモデルが必要な組織
調達条件で中国製モデルを使いにくい場合、400B級で米国製のオープンウェイトという選択肢は多くありません。
4. 自社専用モデルを作るベースモデルがほしい開発者
BaseやTrueBaseを使った追加学習・蒸留・改変・再配布がライセンス上認められています。
こんな人・組織にはおすすめしない
次に当てはまる場合は、現時点では別のモデルを選ぶほうが安全です。
本格的なコーディングエージェントが主な用途
SWE-bench Verified 63.2は実用の範囲ではあるものの、コーディングが中心ならClaude Code、GitHub Copilot、Cursorなどコード向けのツールのほうが合います。
画像・音声・動画の入力が必要
Trinityはテキストのみです。画像を読ませたいならClaudeやGeminiなどマルチモーダル対応のモデルを選びましょう。
日本語の業務文書で高い精度が必要
公式の日本語評価がなく、品質を客観的に判断できません。企画書・契約書・要約が中心なら、日本語の実績があるモデルのほうが確実です。
個人や小規模チームでローカル実行したい
4bitに量子化しても200GBを超えるため、一般的なGPUでは動きません。APIを使うか、Trinity Miniなど小型のモデルを検討してください。
とにかく最安で大量処理したい
同じArcee APIでもDeepSeek V4 Flashのほうが安く提供されています。
よくある質問
Q. Trinity Largeは今もApache 2.0ですか?
いいえ。2026年5月29日にOpenMDW-1.1へ変更され、公開済みのモデルにもさかのぼって適用されています。自社でファインチューニングしたモデルを配布する場合も、OpenMDW-1.1の写しと由来表示を同梱する必要があります。公式ドキュメントの一部はApache 2.0の表記が残っているため、Hugging FaceのLICENSEを正として確認してください。
Q. Trinity-Large-ThinkingとTrinity-Large-Previewはどちらを使うべき?
APIで使うならThinkingです。2026年10月23日時点で、OpenRouterの一覧とArcee APIの料金表に載っているTrinityはThinkingだけで、Previewは重みをダウンロードしてセルフホストする形になります。推論なしの軽い対話を自社環境で動かしたいならPreview、追加学習の起点ならBaseかTrueBaseです。
Q. 日本語はどの程度使えますか?
Arceeは日本語の評価結果を公開していません。日本語の指示に応答はしますが、業務で使えるかどうかは自社の文書で実際に試して判断する必要があります。
Q. 無料で試す方法はありますか?
2026年10月時点で、恒常的な無料枠は確認できていません。OpenRouterの無料版は一覧から消えており、Arcee APIもチャージ式です(Open Models API Betaの発表時には登録者に$5分のクレジットを配っていましたが、今も続いているかは未確認)。試すだけならチャットUIのchat.arcee.aiがあります。重み自体は無料なので、GPU環境があればセルフホストで試す手もあります。
Q. Arcee AIは今後も開発を続けるのか?
2026年9月にSeries Bを発表し、評価額は10億ドルを超えたと公式に発表しています。次世代のTrinityを学習中であることも明かしていますが、名称や公開時期は発表されていません。
Q. Amazon BedrockやAzureで使えますか?
NVIDIAの事例ページにはAmazon Bedrockで提供中、Microsoft Foundryは近日提供と書かれていますが、AWS・Microsoftの公式情報では確認できていません。使う前に各クラウドのモデルカタログで確かめてください。
まとめ:Trinity Largeを選ぶべきか
Arcee AI Trinity Largeは、米国製・約400Bのオープンウェイト・エージェント向け・出力$0.80という組み合わせのモデルです。ライセンスはApache 2.0からOpenMDW-1.1に変わりましたが、商用利用・セルフホスト・追加学習ができる点は変わっていません。
選ぶべきなのは次のようなケースです。
- ツール呼び出し中心のエージェント処理を、低いコストで回したい
- 米国製のオープンウェイトモデルが調達条件になっている
- 機密データを外に出さず、自社環境で大型モデルを動かしたい(GPU環境を用意できる)
- 自社専用モデルを作るベースモデルがほしい
他を選ぶべきなのは次のようなケースです。
- 本格的なソフトウェア開発支援が中心(→ Claude Code / GitHub Copilot)
- 画像・音声などマルチモーダルが必要(→ Claude / Gemini)
- 日本語の品質や長期サポートを最優先する(→ 実績のあるクローズドモデル)
- 価格だけで選ぶ(→ DeepSeek V4 Flash)
生成AIツール全体の比較は生成AIツールおすすめ比較、エージェントの基本はAIエージェントとは、クローズドモデルとの違いはClaudeとはで確認できます。
このツールを自社のシステムや業務にどう組み込むか、ご提案します
この記事の著者
AI革命
編集部
AI革命株式会社の編集部です。最新のAI技術動向から実践的な導入事例まで、企業のデジタル変革に役立つ情報をお届けしています。豊富な経験と専門知識を活かし、読者の皆様にとって価値のあるコンテンツを制作しています。
最新記事
Google UCP(Universal Commerce Protocol)とは?エージェントコマースの仕組み・機能・導入準備を解説
2026/04/01
AIエージェントのセキュリティ対策|リスクの全体像と実務で使える対策チェックリスト【2026年版】
2026/04/04
マルチエージェントAIとは?仕組み・活用事例・フレームワーク・導入判断まで徹底解説
2026/04/05
Mistral Medium 3.5とは?128B統合モデルの料金・Vibe Workモード・SWE-bench 77.6%を解説【2026年10月最新】
2026/05/04
Thinking Machines Inklingとは?Mira Murati初のオープンウェイトモデルの性能・料金・使い方を完全解説【2026年10月最新】
2026/07/16
AnimeGenとは?AIdeaLab製アニメ特化動画生成AIの機能・料金・商用利用・使い方を整理【2026年10月】
2026/07/14