
Reflection Beamとは|501B/アクティブ23Bのオープンウェイトモデル・Apache 2.0・1Mコンテキスト・GLM-5.2/Qwen 3.8との比較と使い方【2026年11月最新】
この記事のポイント
Reflection Beamは、米Reflection AIが2026年10月16日にApache 2.0で重みを公開した総501B・アクティブ23BのMoE型LLMです。スペック、1Mコンテキスト、料金、API・Mirror CLI・vLLMでの使い方、GLM-5.2/Qwen3.8-Maxとの比較、日本語やセキュリティの注意点を整理します。
Reflection Beam(正式名: Beam 1.0)は、米国のAIスタートアップReflection AIが開発した、総パラメータ5,010億(501B)・アクティブ230億(23B)のMoE型テキストLLMです。 2026年10月5日に発表され、10月16日にHugging FaceでApache 2.0の重みが公開されました。公式APIのパブリックベータや、OpenRouter・AWS・Google Cloudなどの各種クラウドから今すぐ使えます。
この記事では、Beamのスペック、できること・できないこと、料金、API・Mirror CLI・vLLMでの使い方、GLM-5.2・Qwen3.8-Maxとの性能・料金・ライセンスの違いをまとめます。発表時(10月上旬)に「予定」とされていた重みの公開・Apache 2.0・1Mコンテキストは、2026年11月17日時点ですべて実現しています。
こんな方に向けた記事です
- 米国製でライセンスの緩いオープンウェイトモデルを探している企業の開発・情報システム担当者
- GLM-5.2やQwen3.8-Maxなど中国製モデルの代わりを検討しているエンジニア
- コーディングエージェントを推論コストを抑えて動かしたい開発者
Reflection Beamの要点まとめ
Beamは「最高性能のモデル」ではありません。「GLM-5.2と同じくらいの性能を、より少ない計算量(アクティブ23B)で出す、米国製・Apache 2.0のモデル」と考えると実態に合います。
- 性能: Reflectionの公表値では、コーディングとエージェント作業でGLM-5.2と互角、Qwen3.8-Maxにやや届かない。素の性能ではKimi K3が上だとReflection自身も認めている
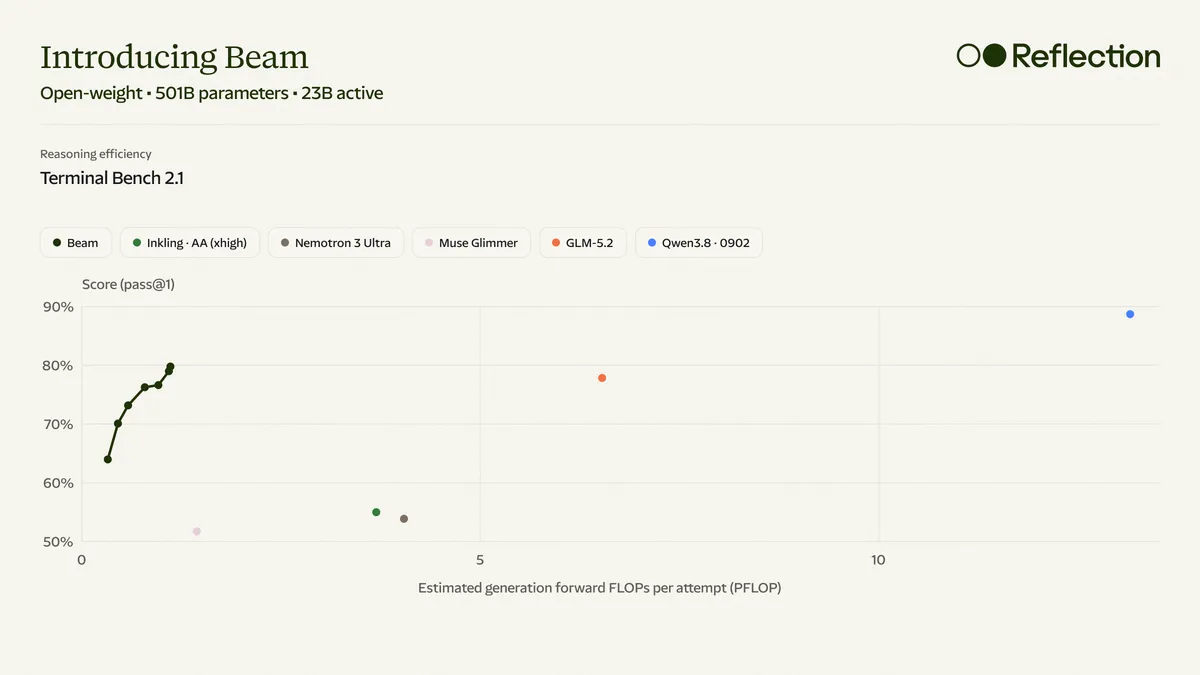
- 軽さ: 1トークンあたりに使うのは23Bぶん(総パラメータの約4.6%)だけ。公式は「主要オープンモデルと同等の品質を、約3分の1の推論トークンで出せる」と主張している
- ライセンス: Apache 2.0。商用利用・改変・再配布に加え、出力を使った蒸留や他モデルの学習も利用ポリシーで明示的に認められている
- 料金: 公式APIの単価は未公表(ベータは「無料で開始可」)。OpenRouter経由では100万トークンあたり入力$0.25〜0.40/出力$1.00〜1.20(2026年11月17日確認)
- 注意点: テキスト専用で、公式の言語は「主に英語」。セルフホストにはB200級GPU4枚以上が必要
発表時点と現在の違い
発表直後の記事には「重みは今月後半に公開予定」「APIは256Kまで」と書かれたものが残っています。2026年11月17日時点の状況は次のとおりです。
項目 | 発表時(2026年10月5日) | 現在(2026年11月17日時点) |
|---|---|---|
重み | 未公開(「今月中」と予告) | 10月16日にHugging Faceで公開済み |
ライセンス | Apache 2.0(予定) | Apache 2.0(適用済み) |
公式API | 順番待ちリスト制のβ | パブリックベータ(無料で開始可) |
APIのコンテキスト | 256K | 1M(1,048,576トークン)。最大出力は131,072トークン |
モデルID |
|
|
外部の提供先 | なし | AWS、Google Cloud、Microsoft Foundry、OpenRouter、Vercelなど20社以上 |
安全性評価 | 未公開 | モデルカードと安全性レポートで公開 |
API料金 | 未公開 | 公式は未公表。他社経由の価格は公開済み |
名前が似たモデルとの混同に注意: 2024年9月に話題になった「Reflection 70B」(HyperWriteのMatt Shumer氏が発表したLlama 3.1ベースのモデル)は、今回のReflection AIとは別の組織・別のモデルです。「Reflection AI」で検索すると両方の情報が混ざって出てくるので注意してください。
Reflection Beamの基本情報
Beamは、Reflection AIが初めて公開したオープンウェイトLLMです。公式ブログでは、企業や開発者が日常的に使う「ワークホース(主力)モデル」と位置づけられており、今後シリーズ化する予定とされています。数値はHugging Faceのモデルカードを基準にしています。
項目 | 内容 |
|---|---|
開発元 | Reflection AI(米ニューヨーク・ブルックリン拠点、2024年創業。元Google DeepMindのMisha Laskin氏・Ioannis Antonoglou氏が創業) |
発表日/重みの公開日 | 2026年10月5日/2026年10月16日(米国時間) |
モデルID |
|
アーキテクチャ | スパースMoE(Mixture-of-Experts)。52層(Dense 3層+MoE 49層)、エキスパート256個 |
アテンション | Gated GQA+スライディングウィンドウ(ローカル/グローバルを交互に配置) |
パラメータ | 総501.3B/アクティブ23.4B(1トークンあたり) |
コンテキスト | 1Mトークン(追加学習で拡張)。APIの最大出力は131,072トークン |
入出力 | テキスト入力・テキスト出力のみ |
言語 | 主に英語(モデルカードの記載) |
知識カットオフ | 2026年6月30日 |
ライセンス | Apache 2.0 |
配布形式 | Safetensors(BF16/FP8/NVFP4)。投機的デコード用の小型ドラフターモデル(約2B)も公開 |
学習の規模
公式ブログによると、事前学習には23.8兆トークン(Webデータと独自にライセンスを得たデータ)を使い、NVIDIA GB300を6,144基使って4週間弱で終えています。その後の強化学習(RL)ではGB300を約10,500基使い、約100万種類の環境で1億回超の試行を回したとされています。
一部メディアでは事前学習とRLのGPU数が混同されていますが、事前学習が6,144基、RLが約10,500基です。
Reflection AIという会社
TechCrunchによると、Reflection AIはNVIDIA・Sequoia・Lightspeedなどから累計約47億ドルを調達し、評価額は250億ドル(プレマネー)とされています。SpaceXやNebiusと計70億ドル超の計算資源契約を結び、GB300を2029年まで確保していると報じられています。
米国では「中国製のオープンウェイトモデル(GLM・Qwen・Kimi・DeepSeek)に対抗できる米国製モデルが足りない」という議論が続いていました。Beamはその不足を補うモデルとして注目されています。背景は中国製AIモデルの台頭でも整理しています。
なお2026年10月10日には、英FTが「NVIDIAがReflectionの買収や追加出資を初期協議中」と報じました(SiliconANGLE)。両社はコメントしておらず、11月17日時点で続報は確認できていません。
MoEの「アクティブ23B」とは?軽いのは計算であってメモリではない
出典: Hugging Face(reflection/Beam-1.0-501B-A23B)
「アクティブ23B」は、1トークンを生成するときに実際に計算に使うパラメータが23Bぶんだけという意味です。MoEモデルは多数の「エキスパート(専門家)」を持ち、入力ごとに一部だけを呼び出して計算します。そのため、計算量は23B級のモデルに近くなります。
ただし、どのエキスパートが呼ばれるかは入力によって変わるため、メモリには501B分のすべての重みを載せておく必要があります。「アクティブ23Bだから一般的なPCでも動く」というのは誤解です。
観点 | Beamの性質 |
|---|---|
1トークンあたりの計算量 | 23B級に近い(軽い) |
必要なメモリ | 501B分(重い) |
推論コストへの影響 | 同程度の性能で、アクティブパラメータが大きいモデルより計算コストを抑えやすい |
ローカル実行 | 一般的なPCや単一GPUでは困難 |
セルフホストに必要なGPUの目安
重みの公開に合わせて、vLLMの公式レシピに必要な構成が載りました。
形式 | ディスク | 最低GPUメモリ合計 | 推奨構成 |
|---|---|---|---|
NVFP4(既定) | 294GB | 353GB | B200/B300×4、またはGB200/GB300の1トレイ。H100×8でも可 |
FP8 | 503GB | 604GB | H200×8 |
BF16 | 1,003GB | 1,204GB | B200/B300×8、MI300X級×8 |
- 最低メモリには、実行時のメモリやKVキャッシュ用に20%の余裕が含まれている
- NVFP4はBlackwell世代向け。H200はFP4に対応しないためFP8を使う
- 1Mトークンをフルに使う場合、KVキャッシュだけで1系列あたり約36GiB(BF16)が必要(Hugging Faceブログ)
- 初回起動にはMoEカーネルの自動調整で約10分かかる
一番軽いNVFP4でも350GB超のGPUメモリが要るため、データセンター級のGPUサーバーかクラウドでの運用が前提です。OllamaやLM Studioも対応先に名前がありますが、手元のPCで実用的に動くかは確認できていません。手元のPCでローカルLLMを動かしたい場合は、Ollamaの解説や、Apache 2.0の小型モデルQwen3.8(27B)の解説も参考にしてください。
Reflection Beamでできること
公式によると、Beamはエージェント型コーディング・少ないトークンでの推論・ツール呼び出しを重視して学習されています。主な用途と、モデルカードに載っているベンチマーク(BF16、Reflectionの自社計測)は次のとおりです。
用途 | 内容 | モデルカードの主な数値 |
|---|---|---|
エージェント型コーディング | GitHub issueの解決、バグ修正、CLI・DevOps作業 | SWE-bench Verified 81.6、SWE-Bench Pro v1 66.1、Terminal-Bench 2.1 80.1 |
推論 | 数学・科学・論理問題 | AIME 2026 97.7、GPQA Diamond 90.6 |
ツール呼び出し・MCP連携 | 外部APIや社内ツールを組み合わせたワークフロー | MCP Atlas 80.8 |
Web検索・調査 | 検索とブラウジングを繰り返して情報を集める | BrowseComp(文脈管理あり)76.8 |
長い文書の読解 | 長い仕様書・コードベースの分析 | AA-LCR 78.2、LongBench v2 67.5 |
指示への追従・構造化出力 | 形式指定のある出力、JSONスキーマに沿った出力 | IFBench 79.6 |
※発表時(10月5日)の数値とは少し違います(例: SWE-bench Verifiedは発表時80.9、モデルカード81.6)。
公式ブログでは、明示的に学習していないブラウジング作業にも対応できたこと、Web検索・別のLLMへの問い合わせ・OCR APIを自分から使い分けたことが紹介されています。
ファインチューニング・蒸留の元になるモデルとして使える
重みが公開されたことで、自社データでの追加学習もできるようになりました。Unsloth・Axolotl・TRL・NeMo RLなどが対応しており、TRLのLoRA学習例ではB300×8で毎秒約19,000トークンの速度が示されています。フルパラメータの強化学習にはH200が約48〜96基必要です。
利用ポリシーでは、出力を使った蒸留や他モデルの学習も明示的に許可されています。大きなBeamで作った回答を教師データにして、小さな社内モデルを育てる使い方も規約上は問題ありません。
企業向けの「AI Factory」構想
Reflection AIは、企業や国家がBeamを自社データで追加学習し、自前のAI基盤を持てるようにする「AI Factory」という構想も打ち出しています。TechCrunchによると、韓国の新世界(Shinsegae)グループがテストパートナーです。DellやHPE経由で、オンプレミスやネットから切り離した環境(エアギャップ)に導入する選択肢も用意されています。
Reflection Beamの強み
Beamの強みは、素の性能ではなく「性能・軽さ・ライセンス・開発国」の組み合わせにあります。
1. 米国製オープンウェイトの中では最上位クラス
Reflectionの公表値では、同じ西側のオープンウェイトモデルを上回っています。たとえばSWE-bench Verifiedでは、Beamが81.6、Thinking MachinesのInklingが77.6、NVIDIAのNemotron 3 Ultraが70.7です。
2. 総パラメータに対して性能が高い
Qwen3.8-Maxが総2.4T・アクティブ95Bなのに対し、Beamは総501B・アクティブ23Bです。総パラメータは約5分の1ですが、公式ベンチマークでの差は数ポイントにとどまる項目が多くあります。
3. Apache 2.0でライセンスの制約が少ない
Apache 2.0は、商用利用・改変・再配布を認める代表的な寛容ライセンスです。利用者の規模による条件もありません。一定規模以上で条件が付くQwen3.8-Maxの独自ライセンスと比べると、法務チェックの負担を軽くしやすくなります。
4. 安く、多くの場所で使える
OpenRouter経由の価格は入力$0.25〜0.40/出力$1.00〜1.20(100万トークンあたり)で、GLM-5.2の公式API($1.40/$4.40)より大幅に安くなっています。AWS・Google Cloud・Microsoft Foundry・Databricks・Cloudflareなど、すでに契約しているクラウドから使える可能性が高いのも利点です。
5. 中国製モデルを使いづらい組織の選択肢になる
日本企業の中にも、取引先との契約や社内のセキュリティ方針で、中国製モデルの利用に慎重な組織があります。そうした組織にとって「米国製・Apache 2.0・GLM-5.2並みの性能」という組み合わせは、現実的な選択肢になり得ます。
6. OpenAI互換APIで移行しやすい
公式APIはOpenAIのChat Completions形式に対応しており、OpenAI公式SDKのベースURLを差し替えるだけで呼び出せます。既存のアプリやエージェントからの切り替えテストを始めやすい作りです。
Reflection Beamの弱み・制約
重みもAPIもそろった一方で、日本語・入力形式・APIの機能には今も制約があります。
- テキスト専用: 画像・音声・ファイルの入力に対応していない
- 公式の言語は「主に英語」: 日本語のベンチマークは公式・第三者とも見つかっていない(SWE-bench Multilingualの「多言語」はプログラミング言語の話で、日本語のような自然言語の性能を示すものではない)
- 公式APIの料金とデータ保持方針が未公表: ベータは無料で始められるが、単価・無料枠の上限は書かれていない
- APIの機能が限られる: 使えるのは
POST /chat/completions、GET /models、GET /models/{model}のみ。Responses API・Embeddings・Batch・Files・Assistants・画像/音声APIには非対応 - 推論をオフにできない: どの
reasoning_effortを選んでも推論トークンが発生する - stopシーケンスとseedが効かない: パラメータは受け付けるが無視されるため、出力の切り詰めは自前で行う必要がある
- 固定・非対応のパラメータがある:
n=1、store=falseなどは固定。APIリファレンスにないパラメータを送ると400エラーになる - ベンチマークは自社計測: 第三者による網羅的な検証はまだ少ない
- 最高性能ではない: Kimi K3やDeepSeek V4.1 Flashには、Terminal-BenchやDeepSWEなどで届いていない
- セルフホストが重い: 最小構成でもB200級GPU4枚程度が必要
このツールを自社のシステムや業務にどう組み込むか、ご提案します
初回相談は無料・30分(オンライン)。要件が決まっていなくても大丈夫です。改修100万円〜・PoC300万円〜(税別)
Reflection Beamの料金
出典: OpenRouter(Beam 1.0 501B A23B)
2026年11月17日時点で、Reflection公式APIの単価は公表されていません。 公式APIはパブリックベータで「無料で開始可」とだけ書かれています。一方、OpenRouterなどの他社経由の価格は公開されています。
提供元ごとの価格(100万トークンあたり)
OpenRouterのモデルページに表示されている価格です(2026年11月17日確認)。
提供元 | 入力 | 出力 |
|---|---|---|
Nebius Token Factory | $0.25 | $1.00 |
CoreWeave | $0.30 | $1.00 |
DigitalOcean | $0.40 | $1.20 |
Baseten | $0.40 | $1.20 |
Together | $0.40 | $1.20 |
利用方法 | 料金の状況 |
|---|---|
Reflection公式API(platform.reflection.ai) | パブリックベータ。無料で開始可。単価・無料枠の上限は未公表 |
Vercel AI Gateway | 無料版の |
セルフホスト | Apache 2.0のためライセンス費用は不要。GPU・運用費は別途必要 |
価格は提供元ごとに頻繁に変わります。発表直後に一部メディアが報じた価格には誤りとみられるものもあるため、契約前に各社の最新ページを確認してください。
レート制限の仕組み
公式ドキュメントによると、レート制限は組織単位で、すべてのAPIキー・プロジェクトで共有されます。APIキーを増やしても上限は増えません。分単位・日単位のリクエスト数とトークン数、同時実行数で制御され、上限を超えるとHTTP 429と Retry-After ヘッダーが返ります。上限の引き上げは developers@reflection.ai に申請します。
「3〜4倍安い」とは言えない理由
公式が主張する「GLM-5.2より3〜4倍少ない推論計算量」は、計算量の推定であって料金の比較ではありません。 プロンプトの読み込み(prefill)や長い文脈でのアテンション計算、サービング時のオーバーヘッドは含まれていません。
また、推論トークンは出力トークンとして数えられます。公式APIの既定の推論の深さは最大(max)になっている例があり、そのまま使うと出力トークンが膨らみやすくなります。他社経由で従量課金するときは、reasoning_effort を下げた場合の品質とトークン量を比べてから決めるのが安全です。
Reflection Beamの使い方
出典: Reflection AI 公式(開発者ドキュメント)
Beamを使う方法は大きく3つあり、手軽な順に並べると次のとおりです。
方法 | 向いている人 | 費用の目安 | 必要なスキル |
|---|---|---|---|
① OpenRouter・クラウド経由のAPI | まず性能を試したい人、既存クラウドで使いたい企業 | 従量課金(100万トークンあたり入力$0.25〜) | API呼び出しの基礎 |
② 公式API+Mirror CLI/OpenCode | コーディングエージェントとして使いたい開発者 | ベータ期間は無料で開始可 | ターミナル操作 |
③ vLLMなどでセルフホスト | データを外に出したくない企業、追加学習したい企業 | GPUサーバー代(B200×4級〜) | GPUサーバーの運用 |
手順1: 公式APIのキーを作成する
- Reflectionの開発者プラットフォーム(platform.reflection.ai)でアカウントを作成する
- コンソールでAPIキーを作成し、環境変数
REFLECTION_API_KEYに設定する - まずは短いプロンプトで、応答の傾向と推論トークンの量を確認する
OpenRouterを使う場合は、モデルIDに reflection/beam-1.0-501b-a23b を指定するだけです。使い方はOpenRouterの解説を参考にしてください。
手順2: OpenAI SDKからAPIを呼び出す
公式APIはOpenAI互換です。ベースURLを https://api.reflection.ai/openai/v1 に変えるだけで、OpenAI公式のPython/TypeScript SDKから呼び出せます。
pip install openai
export REFLECTION_API_KEY="取得したAPIキー"
import os
from openai import OpenAI
client = OpenAI(
base_url="https://api.reflection.ai/openai/v1",
api_key=os.environ["REFLECTION_API_KEY"],
)
resp = client.chat.completions.create(
model="Beam-1.0-501B-A23B",
reasoning_effort="medium", # low / medium / high / xhigh / max
messages=[
{"role": "system", "content": "あなたは優秀なPythonエンジニアです。"},
{"role": "user", "content": "CSVを読み込んで列ごとの欠損率を出す関数を書いてください。"},
],
max_completion_tokens=16000,
)
msg = resp.choices[0].message
print(msg.content) # 最終回答
print(getattr(msg, "reasoning_content", None)) # 推論の過程(ユーザーには表示しない)
print(resp.usage) # 推論トークンも出力トークンに含まれるcurlで確認する場合は次のとおりです。
curl https://api.reflection.ai/openai/v1/chat/completions \
  -H "Authorization: Bearer $REFLECTION_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "Beam-1.0-501B-A23B",
    "reasoning_effort": "low",
    "messages": [{"role": "user", "content": "MoEとは何か、3行で説明してください。"}]
  }'
公式APIでは、ストリーミング、ツール呼び出し、構造化出力(JSONスキーマ)、system・developer・user・assistant・toolの各ロールなどが使えます。
推論の深さ(reasoning_effort)の選び方
Beamは常に推論(思考)してから回答します。推論の深さは reasoning_effort で5段階から選べます。公式のモデル一覧の例では既定が max になっており、組織によって異なる場合があるとされています。
設定 | 向いている用途 |
|---|---|
| 分類・要約・簡単な質問など、速さを優先したいとき |
| 一般的なコーディング・調査。コストと品質のバランスを取りたいとき |
| 複数ファイルにまたがる修正や、難しめの推論 |
| 難しい数学・アルゴリズム問題など、時間とトークンをかけてでも精度が欲しいとき |
推論の過程は reasoning_content、最終回答は content に分かれて返ります。推論トークンも出力上限に数えられるため、上限が小さいと回答の途中で finish_reason: "length" で止まります。既定の出力上限は32,768トークンの例が示されていますが、長いプロンプトを送るときは自分で上限を指定してください。
なお、Hugging Faceブログの試用では、low にすると指示した説明を省いたり、出力形式が崩れたりする例が報告されています。形式が大事な処理では medium 以上から試すのが無難です。
手順3: Mirror CLIでコーディングエージェントとして使う
Mirror CLIは、Reflection純正のターミナル型コーディングエージェントです。既定のモデルはBeamで、現在は初期ベータです。
# uvを入れてからインストール
uv tool install reflection-mirror

export REFLECTION_API_KEY="取得したAPIキー"
cd your-project
mirror

# 更新するとき
mirror update- 対応OS: macOS 14以降(Apple Silicon)、Linux(glibc 2.28以降、x86-64/ARM64)
- ネイティブのWindowsには非対応(WindowsではWSL2などのLinux環境を使う形になる)
- 主な機能:
/worktreeで複数エージェントの並列作業、/resume・/rewindで会話の再開・分岐、AGENTS.mdとスキルの読み込み、MCP連携(Linear・Notionなど)
公式ドキュメントでは、Mirror以外にOpenCode・Pi・Hermes Agentの設定手順も案内されています。普段OpenCodeを使っている方は、OpenCodeの解説もあわせて確認してください。
手順4: vLLMでセルフホストする
自社のGPUサーバーで動かす場合は、vLLM(0.33.0以降)が手軽です。SGLang・Transformers・NVIDIA Dynamoなども対応しています。NVFP4版をB200級GPU4枚で動かす最小例は次のとおりです(vLLM公式レシピより)。
vllm serve reflection/Beam-1.0-501B-A23B-NVFP4 \
  --kv-cache-dtype fp8 \
  --tensor-parallel-size 4 \
  --reasoning-parser beam \
  --enable-auto-tool-choice \
  --tool-call-parser beam
起動後はOpenAI互換のエンドポイントとして呼び出せます。H200環境ではFP8版を8枚構成で使います。
Reflection BeamとGLM-5.2・Qwen3.8-Maxの違い
性能を優先するならQwen3.8-Max、ライセンスの自由度と安さを優先するならBeam、実績のあるMITライセンスのモデルならGLM-5.2、という選び分けになります。「Qwen 3.8」で検索すると27Bの小型モデルも出てきますが、Beamの比較相手はシリーズ最上位のQwen3.8-Maxです。
なお、Reflectionが比べているGLM-5.2には、2026年8月に後継のGLM-5.3が出ています。Beamの比較相手は1世代前のモデルである点に注意してください。
スペック・料金・ライセンスの比較表
項目 | Reflection Beam | GLM-5.2 | Qwen3.8-Max |
|---|---|---|---|
開発元(国) | Reflection AI(米国) | Z.ai(中国) | Alibaba(中国) |
総/アクティブパラメータ | 501B / 23B | 753B / 約40B | 2.4T / 95B |
ライセンス | Apache 2.0 | MIT | 独自ライセンス(一定規模以上の事業者には条件あり) |
重みの公開 | 2026年10月 | 2026年6月 | 2026年8月 |
コンテキスト | 1M | 1M | 重み版 262K(拡張で約1M)/API版 1M |
入力 | テキストのみ | テキストのみ | 重み版はテキストのみ/API版は画像・動画にも対応 |
API料金(100万トークンあたり 入力/出力) | 公式は未公表。他社経由 $0.25〜0.40 / $1.00〜1.20 | $1.40 / $4.40(Z.ai公式) | $2.00 / $6.00(シンガポールなど)。米国リージョンのGlobal区分は$1.65 / $4.95との集計もある(いずれも第三者サイトの値) |
セルフホストの目安 | B200×4(NVFP4)/H200×8(FP8) | 公式記載なし(総パラメータはBeamの約1.5倍) | 総2.4Tで非常に大きい |
※料金は改定されることがあるため、契約前に各社の最新の料金ページを確認してください。Qwen3.8-Maxの料金はAlibaba Cloud公式ページでの確認がとれていないため、Model Studioの料金ページで必ず確かめてください。GLM-5.2のアクティブパラメータは出典によって数字が揺れています。
ベンチマーク比較(Reflection公表値)
ベンチマーク | Reflection Beam | GLM-5.2 | Qwen3.8-Max | 測っている能力 |
|---|---|---|---|---|
SWE-Bench Pro v1 | 65.5 | 62.1 | 67.7 | 実務的なコード修正 |
Terminal-Bench 2.1 | 80.1 | 81.0 | 86.6 | ターミナル操作を伴うタスク |
DeepSWE v1.1 | 44.4 | 44.0 | 51.0 | 長いソフトウェア開発タスク |
MCP Atlas | 78.7 | 77.8 | 84.5 | ツール呼び出し |
GPQA Diamond | 90.5 | 91.2 | 92.6 | 大学院レベルの科学知識 |
HLE(ツールなし) | 36.2 | 40.5 | 43.6 | 超難問の推論 |
AIME 2026 | 97.8 | 99.2 | 掲載なし | 数学 |
※すべてReflectionの発表ブログ(10月27日更新)に載った値で、比較相手の数値もReflectionが掲載したものです。各社が自ら公表している値とは測定条件が違う可能性があります。Beamの数値はモデルカードの値と少し異なります(例: SWE-Bench Pro v1はモデルカードで66.1、MCP Atlasは80.8)。
数値を見ると、GLM-5.2とは項目によって勝ったり負けたりの互角で、Qwen3.8-Maxには多くの項目でわずかに届きません。 ただしBeamのアクティブパラメータはGLM-5.2の約半分、Qwen3.8-Maxの約4分の1です。「同じくらいの性能を、より少ない計算で出せるか」がBeamを評価するポイントになります。
Reflectionの比較表にはKimi K3とDeepSeek V4.1のFlash版も載っています。Kimi K3はTerminal-Bench 2.1で88.3、BrowseCompで91.2、DeepSeek V4.1 FlashはTerminal-Bench 2.1で90.6と、Beamを明確に上回っています。素の性能を最優先するなら、これらのモデルも比較に入れるべきです。
各モデルの詳細は、GLM-5.2の解説とQwen3.8-Maxの解説で紹介しています。
目的別の選び分け
目的 | 選ぶべきモデル | 理由 |
|---|---|---|
オープンウェイトで最高クラスの性能が欲しい | Qwen3.8-Max/Kimi K3 | 公表値でBeamを上回る |
画像入力も使いたい | Qwen3.8-Max(API版) | Beam・GLM-5.2はテキスト専用 |
米国製・寛容ライセンスのモデルが条件 | Reflection Beam | Apache 2.0で、Reflectionの公表値では西側オープンウェイトの最上位クラス |
APIの従量課金を安く抑えたい | Reflection Beam | 他社経由で入力$0.25〜/出力$1.00〜 |
社内でホストし、推論コストを抑えたい | Reflection Beam | アクティブ23Bで計算が軽い。B200×4級から動く |
自社データで追加学習・蒸留したい | Reflection Beam/GLM-5.2 | どちらもライセンスの制約が少ない |
日本語の文章作成が中心 | 3モデルとも要検証。日本語に強いモデルも候補 | Beamの公式言語は「主に英語」 |
日本語の品質を重視する場合は、Sakana AIのNamazuのような日本語に強いモデルも比較に入れてください。
セキュリティ・利用上の注意点
Beamを業務で使う場合は、データの送り先・エージェントの権限・安全性評価の数値・オープンウェイト特有のリスクの4点を押さえておく必要があります。
データの送り先と保持方針を確認する
公式APIでは store が false に固定されており、レスポンスには適用されたデータ保持の区分を示す reflection-data-retention ヘッダーが付きます。ただし、2026年11月17日時点で保持期間や学習への利用有無をまとめた説明は確認できていません。OpenRouterやクラウド経由で使う場合は、データの送り先が各事業者になるため、それぞれの規約も確認が必要です。機密情報や個人情報を入れる前に、利用規約とプライバシーポリシーを必ず確認してください。
データを外に出せない業務なら、重みを自社環境で動かすか、DellやHPE経由のオンプレミス構成を検討することになります。自社の業務システムに新しいモデルを組み込む場合は、API経由かセルフホストかで開発費・運用費が大きく変わるため、AI開発の費用相場で方法ごとの目安を把握しておくと判断しやすくなります。
Mirror CLIはサンドボックスではない
Mirror CLIは、既定ではツールの実行ごとに承認を求める手動モードで動きます。Autoモードに切り替えると確認が減りますが、公式ドキュメントには「Mirrorはサンドボックスではない。承認したコマンドは自分のアカウント権限で実行される」と書かれています。
- 業務用のPCでは手動承認モードのまま使う
- Autoモードを使うなら、コンテナや仮想マシンなど隔離した環境で動かす
- 本番環境の認証情報(
.env・クラウドの認証キーなど)が置かれたフォルダで実行しない
安全性評価の数値の読み方
モデルカードには、単発・複数ターン・脱獄・エージェント場面を含む安全性評価の結果が載っています。
指標 | BF16 | FP8 | NVFP4 |
|---|---|---|---|
有害な依頼を断る・そらす割合 | 88.9% | 89.7% | 88.5% |
無害な依頼に応じる割合 | 81.5% | 81.6% | 82.1% |
裏を返すと、有害な依頼の約1割には応じてしまい、無害な依頼の約2割は断る(過剰に拒否する)ということです。顧客向けのチャットなどに組み込むときは、入力と出力のフィルタを別に用意してください。
オープンウェイト特有のリスク
重みは誰でもダウンロード・改変できます。技術的には安全機構を外したモデルを作ることも可能です。また、自社で動かす場合は、出力フィルタ・監視・アクセス制御をすべて自前で用意する必要があります。オープンウェイトの是非をめぐる議論は、Anthropicのオープンウェイトに対する立場やオープンモデルのセキュリティ連合の動きでも整理しています。
会社の先行きによる影響
NVIDIAによる買収協議の報道は未確定です。Apache 2.0で公開済みの重みは、仮に会社の体制が変わっても使い続けられます。一方で、公式APIの提供条件や今後のモデルの方針は変わる可能性があるため、公式APIだけに依存しない構成にしておくと安心です。
Reflection Beamがおすすめな人・おすすめしない人
こんな人におすすめ
- 米国製で寛容なライセンスのオープンウェイトモデルが条件になっている企業(中国製モデルを社内利用しづらい組織)
- コーディングエージェントを、推論コストを抑えて大量に回したい開発チーム
- 自社データで追加学習・蒸留し、社内専用モデルを作りたい企業
- データを外に出さず、自社GPUやオンプレミスで大規模モデルを動かしたい組織
- OpenAI互換APIで、複数のモデルを入れ替えて比較検証している開発者
こんな人にはおすすめしない
- 画像・音声・PDFを直接読ませたい人: テキスト専用のため、マルチモーダル対応のモデルが必要
- 日本語の文章作成が中心の人: 公式の言語は「主に英語」で、日本語の評価がない
- 手元のPC1台で動かしたい人: 一番軽いNVFP4でも350GB超のGPUメモリが必要
- とにかく最高性能が欲しい人: Kimi K3やDeepSeek V4.1 Flash、クローズドな最上位モデルのほうが性能は上
- 公式APIの料金が確定していないと困る人: 公式APIの単価は未公表(他社経由なら価格は確定している)
導入判断の目安
あなたの状況 | おすすめの行動 |
|---|---|
まず性能の傾向を知りたい | OpenRouterか公式APIのベータで、自社の課題を英語と日本語の両方で試す |
既存のOpenAI互換アプリがある | ベースURLとモデルIDを差し替え、 |
コーディングエージェントに使いたい | Mirror CLIかOpenCodeを、隔離した環境で手動承認モードから試す |
社内ホストを検討している | vLLMレシピの構成(B200×4またはH200×8)で必要なGPU費用を見積もり、LICENSEファイルを確認する |
日本語の業務文書が中心 | 自社データの小さなサンプルで品質を測り、日本語に強いモデルと比べてから決める |
よくある質問(FAQ)
Q. Reflection Beamは無料で使えますか?
A. 公式APIはパブリックベータで「無料で開始可」とされていますが、無料枠の上限や正式な単価は2026年11月17日時点で公表されていません。重みはApache 2.0なので、自社サーバーで動かす場合はライセンス費用がかかりません。ただし、B200級GPU4枚以上のサーバー代は別に必要です。
Q. 「Beam-1.0-501B-A23B」というモデル名はどういう意味ですか?
A. 「1.0」が世代、「501B」が総パラメータ数(5,010億)、「A23B」がアクティブパラメータ数(230億)を表します。オープンウェイトのMoEモデルでよく使われる命名方法で、Qwen系の「235B-A22B」なども同じルールです。発表直後のAPIでは Beam-501B-A23B というIDでしたが、現在は Beam-1.0-501B-A23B です。
Q. Hugging Faceからダウンロードできますか?
A. できます。2026年10月16日から reflection/Beam-1.0-501B-A23B で公開されています。BF16・FP8・NVFP4の3形式があり、BF16は約1TB、NVFP4でも約300GBあります。
Q. Claude CodeやCursorから使えますか?
A. 公式に設定手順が案内されているのは、Mirror CLI・OpenCode・Pi・Hermes Agentです。APIはOpenAI互換なので、OpenAI互換のエンドポイントを設定できるツールなら接続できる可能性があります。ただし、Responses APIに非対応、stopシーケンスが無視されるといった違いがあるため、うまく動かない場合もあります。
Q. 日本語は使えますか?
A. 日本語で質問し、日本語で答えさせることはできます。ただし、公式の対応言語は「主に英語」で、日本語の性能は公式・第三者ともに評価が出ていません。日本語の業務文書に使う予定があるなら、実際の業務に近いサンプルで品質を確かめてから判断してください。
Q. NVIDIAに買収されたら使えなくなりますか?
A. 公開済みの重みはApache 2.0なので、買収の有無にかかわらず使い続けられます。買収協議は2026年10月に報じられたものの未確定です。影響を受ける可能性があるのは、公式APIの提供条件や今後のモデルの方針です。
Q. 2024年に話題になった「Reflection 70B」の後継ですか?
A. いいえ、無関係です。Reflection 70BはHyperWriteのMatt Shumer氏が2024年9月に発表したモデルで、性能の数値が水増しされていたのではないかという疑惑で注目を集めました。Beamを開発したReflection AIは、元Google DeepMindの研究者が2024年に創業した別の会社です。
まとめ
Reflection Beamは、総501B・アクティブ23BのMoE構造で、GLM-5.2と互角の性能を、より少ない計算量で出すことを狙った米国製のオープンウェイトモデルです。2026年10月16日にApache 2.0で重みが公開され、1Mコンテキストの公式APIや、OpenRouter・各種クラウドからも使えるようになりました。
一方で、テキスト専用で公式の言語は「主に英語」、ベンチマークはReflectionの自社計測です。素の性能ではQwen3.8-MaxやKimi K3に届かない項目が多く、比較相手のGLM-5.2にはすでに後継が出ています。
まずはOpenRouterや公式APIのベータで自社の課題を試し、日本語の品質と推論トークンの量を確かめてから、API利用かセルフホストかを決めるのが現実的です。性能を重視するならQwen3.8-Max、MITライセンスのモデルならGLM-5.2とあわせて比較してください。
参考情報(公式・報道)
- Reflection AI公式ブログ「Introducing Beam」
- Reflection AI公式ブログ「Beam is now available」
- Hugging Face: reflection/Beam-1.0-501B-A23B(モデルカード)
- Hugging Faceブログ: Reflection Beam
- Reflection開発者ドキュメント(Models)
- Reflection開発者ドキュメント(OpenAI互換)
- vLLM Recipes: Beam-1.0-501B-A23B
- OpenRouter: Beam 1.0 501B A23B
- TechCrunch: Reflection debuts Beam
このツールを自社のシステムや業務にどう組み込むか、ご提案します
この記事の著者

AI革命
編集部
AI革命株式会社の編集部です。最新のAI技術動向から実践的な導入事例まで、企業のデジタル変革に役立つ情報をお届けしています。豊富な経験と専門知識を活かし、読者の皆様にとって価値のあるコンテンツを制作しています。
最新記事
Claude Code Hooks 使い方|PreToolUse/PostToolUse/Stop/SubagentStop 完全ガイド
2026/04/22
Claude Code Routines 使い方完全ガイド【2026年11月最新】|スケジュールタスク(旧Routines)の定期実行・API・GitHub Event 設定と実行上限
2026/04/22
Augment Codeとは?機能・料金・使い方・Cursor/Claude Codeとの違いを徹底解説
2026/04/12
Everything Claude Codeとは?Claude Codeを最大化するOSSフレームワーク完全ガイド【2026年11月最新】
2026/04/17
Gemini Mac 自動操作(Computer use)の使い方|日本で使える?利用条件・設定手順・安全な許可の決め方【2026年11月】
2026/11/21
CLAUDE.md 書き方ベストプラクティス|設計パターン・300行ルール完全ガイド
2026/04/22

