
Inkling 2 Miniとは?ノートPCで動くThinking Machinesの小型モデル|性能・料金・使い方・注意点【2026年11月】
この記事のポイント
Inkling 2 Miniは、Thinking Machines Labが2026年11月20日に公開した、メモリ32GBのMacでも動く26.4Bのオープンウェイトモデルで、ライセンスはApache 2.0です。ループ型の仕組み、ベンチマークの強み・弱み、Tinker料金、Ollamaでの使い方、日本語対応や破壊的操作などの注意点を公式情報をもとに整理しました。
Inkling 2 Mini(インクリング・ツー・ミニ)は、Mira Murati氏が率いるThinking Machines Labが2026年11月20日(米国時間)に公開した、ノートPCで動く小型のオープンウェイトモデルです。 総パラメータは26.4B、重みは約20GBで、メモリ32GB以上のMacやNVIDIA DGX Spark 1台で動きます。ライセンスはApache 2.0なので商用利用もできます。コーディングやエージェント作業に強い一方で、日本語の品質は公式に保証されておらず、ツール操作でファイルを確認なしに消すことがあるとモデルカードに書かれています。
この記事でわかること
- Inkling 2 Miniの基本情報と、Inklingファミリーの中での位置づけ
- 「ループ型トランスフォーマー」の仕組みと、3.4B/5.4Bという2つのパラメータ数の意味
- 公式ベンチマークで強い分野・弱い分野(比較相手に負けている項目も載せています)
- 料金(ローカルなら無料、Tinkerの単価)と、自分のPCで動くかどうかの目安
- Ollama・llama.cppなどでの使い方と、公開直後ならではのつまずきやすい点
- 日本語対応・ハルシネーション・破壊的操作などの注意点
こんな方に向けた記事です:手元のPCでコーディングエージェントやローカルLLMを動かしたい開発者、機密データを外部APIに送れない企業の開発・情報システム担当者、Thinking Machines Labの新モデルを追っている方。
公開から間もないため、数値の多くは開発元の発表で、第三者の評価はArtificial Analysisなどに限られます。2026年11月21日時点の公式発表・モデルカード・Tinker料金ページをもとに整理しています。
出典: Thinking Machines Lab 公式サイト
Inkling 2 Miniとは?Inkling第2世代でいちばん小さいモデル
出典: Thinking Machines Lab「Inkling 2 Mini」公式発表
Inkling 2 Miniは、大きなサーバーを持たない人でも手元で動かせるように作られた、Inkling第2世代の最小モデルです。上位には2026年11月に出たInkling 2 Smallがあり、Miniはその強み(コーディング・エージェント・検索やツールの利用・画面の理解)を小さいサイズに詰めた位置づけです。
公式発表では、DeepSWE v1.1やVals Index v2.2などいくつかのベンチマークで「総パラメータ100B未満のオープンウェイトモデルの中で最高」とされています。
項目 | 内容 |
|---|---|
モデル名 | Inkling 2 Mini |
開発元 | Thinking Machines Lab, Inc.(米国。CEOはMira Murati氏) |
公開日 | 2026年11月20日(米国時間) |
ライセンス | Apache 2.0(商用利用・改変・再配布が可能) |
総パラメータ | 26.4B(264億) |
アクティブパラメータ | 1パスあたり3.4B、ループ込みで約5.4B/トークン |
構造 | ループ型トランスフォーマー+スパースMoE |
コンテキスト長 | 最大1Mトークン(モデル仕様) |
入力 | テキスト、画像(推奨サイズは1辺40〜4096px) |
出力 | テキストのみ |
重みのサイズ | 約20GB(単一チェックポイント) |
入手先 | Hugging Face |
必要なハード(公式) | DGX Spark 1台、またはメモリ32GB以上のApple silicon搭載Mac |
ChatGPTのような一般向けのチャットアプリはありません。試すなら、ローカルで動かすか、Tinkerの「Playground」を使います。開発元の成り立ちや資金調達の経緯は「Thinking Machines Labとは」で解説しています。
Inklingファミリーの中での位置づけ
Thinking Machines Labは2026年7月に初代のInklingとInkling-Smallを公開し、11月にInkling 2 Small、続いてInkling 2 Miniを出しました。4つのモデルの規模とTinker料金を並べると、Miniだけが桁違いに小さいことがわかります。
モデル | 総/アクティブパラメータ | 公開 | Tinker入力単価 | Tinker出力単価 | ローカル実行 |
|---|---|---|---|---|---|
Inkling | 975B/41B | 2026年7月 | $1.87 | $4.68 | データセンター級GPUが必要 |
Inkling-Small | 276B/12B | 2026年7月 | $0.58 | $1.44 | 量子化しても大きなGPUメモリが必要 |
Inkling 2 Small | 594B/17B | 2026年11月 | $0.30 | $1.00 | データセンター級GPUが必要 |
Inkling 2 Mini | 26.4B/3.4B(ループ込み5.4B) | 2026年11月 | $0.15 | $0.50 | 32GBのMacで動く |
※単価はUSD/100万トークン。2026年11月時点のTinker公式料金ページより。
初代モデルの詳細は「Thinking Machines Inklingとは」「Inkling-Smallとは」にまとめています。初代は音声も入力できますが、Inkling 2 Miniの入力はテキストと画像だけです。
ループ型トランスフォーマーの仕組み:同じ層を3回通して「多く考え、少なく書く」
出典: Goodfire「Interpreting Inkling 2 Mini」
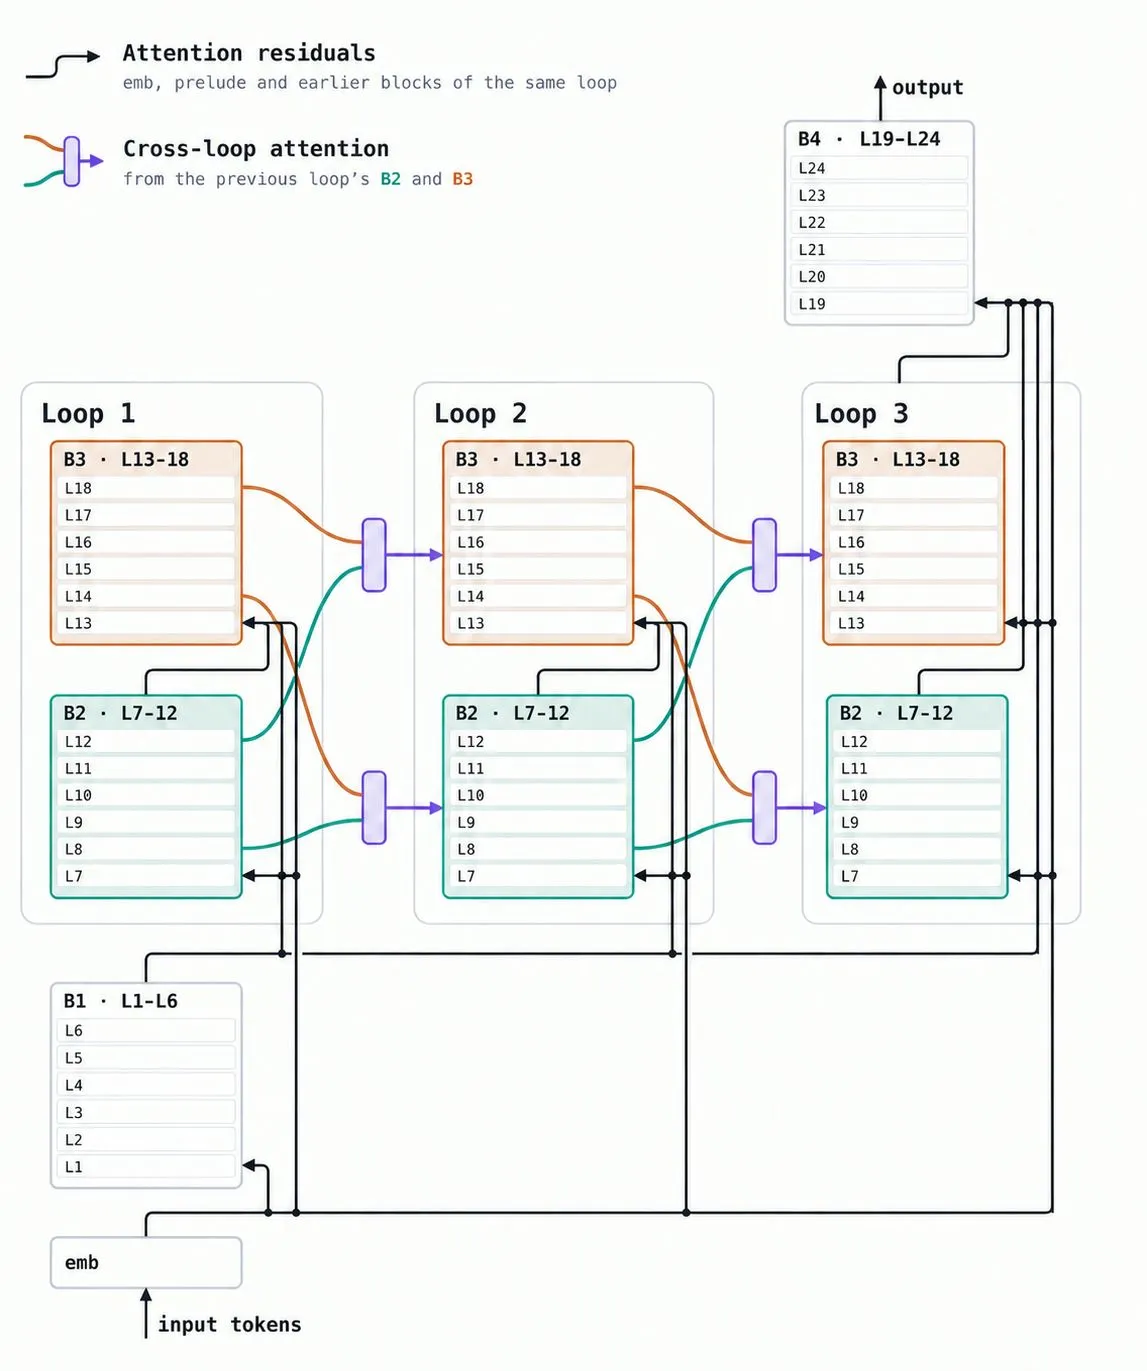
Inkling 2 Miniのいちばんの特徴は、中央の層を1トークンにつき3回くり返して計算する「ループ型」の設計です。Murati氏はこれを「Looping lets a model think more and write less(ループで、モデルは多く考え、少なく書く)」と説明しています。
たとえるなら、本の中盤を3回読み直して理解を深めるやり方です。重み(本そのもの)は増やさずに、1トークンあたりにかける計算を増やします。
項目 | 内容 |
|---|---|
層の数 | 24層(6層×4ブロック) |
ループの範囲 | 中央の2ブロック(12層)を3回実行。最初と最後のブロックは1回 |
実質の計算 | 24層ぶんの重みで、48層ぶんの計算 |
MoE | 1層あたり128エキスパートのうち、1トークンで8個を使う |
注意機構 | ローカル注意とグローバル注意の組み合わせ。前の周回の情報を学習済みのゲートで合流させる |
画像の扱い | ViTで画像を符号化し、テキストと同じ空間で処理 |
数値形式 | 20層がNVFP4、最後の4層がMXFP8。事前学習から強化学習まで4ビットで学習 |
「4ビットで学習」も実務では重要な点です。配布用にあとから量子化したモデルと違い、最初から4ビットで学習しているので、公式は「配布時の量子化による劣化がない」としています。約20GBに収まるのはこのためです。
3.4Bと5.4B、2つのパラメータ数がある理由
アクティブパラメータの表記は、出典によって3.4B・5.4B・約3B・3.5Bとばらつきます。ループを数えるかどうかの違いです。
出典 | 表記 | 数え方 |
|---|---|---|
公式発表・モデルカード | 3.4B/5.4B | 1回通すぶんと、ループ3回込みのぶんを併記 |
Artificial Analysis・Ollama | 5.4B | ループ3回を含む |
Hugging Face公式ブログ | 約3B | 概数 |
vLLMのレシピ | 3.5B | 概数 |
なお、事実の知識をどれだけ覚えていられるかは総パラメータ(26.4B)で決まり、ループで計算を増やしても知識は増えません。これがInkling 2 Miniの弱みにもつながっています。
ループの効果(公式の主張)
- 中央12層をループさせると、最後の12層をループさせる場合より、28の評価のうち27で精度の伸びが大きかった
- ループなしのモデルは学習の計算が7.5%少なく済む一方、512Kトークンのエージェント作業で同じ損失に届くには推論の計算が140%多く必要だった
同時に、ループの回数を1〜5回で変えられる研究用モデル「TML-d24-varloop-research」もHugging Faceで公開されています。
Inkling 2 Miniでできること
Inkling 2 Miniが得意なのは、手元のPCで動かすコーディングエージェントや、検索・ツールを使うエージェントです。モデルカードとOllamaのページでは、次の用途が挙げられています。
- コーディング:SWE-bench Verified(bashのみ)で79.2%。リポジトリのバグ修正やコード生成をエージェントとしてこなす
- エージェント・ツール呼び出し:関数呼び出しに対応。MCP Atlas 82.7%、BrowseComp 79.0%
- 画面・文書の理解:スクリーンショットからボタン位置を特定するScreenSpot Proで87.7%(Python使用時)。文書読み取りのOmniDocBenchで92.8%
- 画像を見ながらのデザイン作業や金融タスク:公式が得意分野として挙げている
- 長文の処理:モデル仕様では最大1Mトークン(1,048,576)まで扱える
- 推論の深さの調整:
reasoning_effortをnone〜max(または0.0〜0.99)で指定。既定はhigh - ファインチューニング:TinkerのAPIで追加学習でき、強化学習はSkyRL・Miles・NVIDIA AutoModelに対応
ローカルで動かせば、プロンプトやコードが外部のサーバーに送られません。社外に出せないソースコードや文書を扱う作業に向いており、この点はクラウドのAPIにない利点です。
性能・ベンチマーク:コーディングと検索に強く、会話と知識は弱い
公式のベンチマークでは、コーディング・検索エージェント・文書や画面の理解ではQwen3.8-27BやGemma 4 31Bを上回る一方、複雑な指示・多ターン会話・事実の知識では負けています。公式自身が負けている項目も載せているので、そのまま整理します。
分野 | ベンチマーク | Inkling 2 Mini | 最も強い比較相手 | 結果 |
|---|---|---|---|---|
総合 | Vals Index v2.2 | 46.5% | Nemotron 3.5 Super VL 29.8% | 勝ち |
コーディング | SWE-bench Verified(bashのみ) | 79.2% | Qwen3.8-27B 77.8% | 勝ち |
コーディング | SWE-bench Pro v2(Hard) | 77.9% | Qwen3.8-27B 73.8% | 勝ち |
コーディング | DeepSWE v1.1 | 48.2% | Qwen3.8-27B 42.2% | 勝ち |
コーディング | Vibe Code Bench v1.1 | 77.9% | Qwen3.8-27B 64.9% | 勝ち |
コーディング | Terminal Bench v2.1 | 71.6% | Qwen3.8-27B 73.0% | 負け |
検索・エージェント | DeepSearchQA | 85.3% | Qwen3.8-27B 79.7% | 勝ち |
検索・エージェント | MCP Atlas | 82.7% | Qwen3.8-27B 77.3% | 勝ち |
視覚 | OmniDocBench v1.6 | 92.8% | Qwen3.8-27B 91.5% | 勝ち |
視覚 | MMMU Pro | 74.9% | Qwen3.8-27B 76.3% | 負け |
推論 | ARC-AGI v2 | 49.3% | Qwen3.8-27B 42.4% | 勝ち |
推論 | HLE-Diamond | 15.2% | Qwen3.8-27B 15.3% | ほぼ互角 |
実務 | GDPVal-AA | 1319 | Qwen3.8-27B 1427 | 負け |
事実性 | AA-Omniscience 非ハルシネーション率 | 63.4% | Qwen3.8-27B 71.4% | 負け |
指示追従 | MultiChallenge | 50.0% | Qwen3.8-27Bが上 | 負け |
※公式発表・モデルカードの数値(開発元の発表)。比較相手はGemma 4 31B、Muse Glimmer、Qwen3.8-27B、Nemotron 3.5 Super VL。
比較相手のモデルについては「Qwen3.8-27Bとは」「Gemma 4とは」で解説しています。
第三者の評価(Artificial Analysis)
独立した評価機関のArtificial Analysisは、Inkling 2 MiniのIntelligence Indexを20としています。
- Qwen3.8 27B(xhigh)と同じスコアで、アクティブパラメータは約5分の1
- 1タスクあたりの費用は$0.59・9.0分。Qwen3.8 27Bの$3.53・38.2分と比べ、約6倍安く約4倍速い
- 出力トークンは1タスク約152Kで、Qwen3.8 27Bより約38%多い。考える量が多いぶん出力は長くなる
- クローズドの軽量モデル(GPT-6 Lunaのmax設定はスコア28・1タスク$0.15)と比べると、費用面での優位はない
つまり、同じ規模のオープンウェイトモデルと比べると効率がよい一方、APIで使うクローズドの軽量モデルより安いわけではありません。Inkling 2 Miniを選ぶ理由は「手元で動く」「重みを持てる」「追加学習できる」点にあります。
Hugging Faceの公式ブログも、Qwen3.8 27Bとの比較の一部は体感テストで、さらに検証が必要だと書いています。
料金:ローカルなら無料、Tinkerは入力$0.15・出力$0.50
重みはApache 2.0で無料配布されているので、自分のPCで動かす限りモデルの利用料はかかりません(かかるのは電気代とハードの費用だけです)。API経由で使う場合は、開発元のTinkerで従量課金になります。
出典: Thinking Machines Lab - Tinker
項目(USD/100万トークン) | 学習コンテキスト64K | 学習コンテキスト256K |
|---|---|---|
Prefill(入力) | $0.15 | $0.15 |
キャッシュ済みPrefill | $0.015 | $0.015 |
Sample(出力) | $0.50 | $0.50 |
Train(学習) | $0.75 | $1.50 |
チェックポイントの保存 | $0.10/GB/月 | $0.10/GB/月 |
※2026年11月時点のTinker公式料金ページより。MoEモデルは総パラメータではなくアクティブパラメータで課金されます。料金は改定されることがあるので、使う前に公式ページを確認してください。
試算例:入力100万トークン+出力100万トークンなら、$0.15+$0.50=$0.65(1ドル150円換算で約98円)です。
注意点として、2026年11月21日時点で、Tinkerの「Serverless Inference(ベータ)」の対象はInkling 2 Small・Inkling・Inkling-Smallだけで、Inkling 2 Miniは入っていません。Miniを使うときは、Tinkerのsampling(入力$0.15・出力$0.50/100万トークン)か、ローカル実行になります。OpenRouterにも掲載ページがありますが、表示価格がMini本体のものかは確認できなかったため、この記事では扱っていません。
自分のPCで動く?メモリ別の目安
出典: Hugging Face「thinkingmachines/Inkling-2-Mini」
公式の推奨は、メモリ32GB以上のApple silicon搭載Mac、またはVRAM 32GB以上のGPU(あるいはDGX Spark 1台)です。 公式デモでは、MacBook Pro(M5 Pro・48GB)とDGX Spark(128GB)でネット接続なしに動かしています。
Unslothが公開している量子化ファイルの必要メモリをもとに、手持ちのPCで何が選べるかを整理しました。
PCのメモリ | 選べる量子化の目安 | 判断 |
|---|---|---|
16GB | 1〜2ビット(必要9〜11GB) | 一応読み込めるが、品質低下とOS側の余裕のなさから実用はおすすめしない |
24GB | 3ビット(必要13〜15GB) | 試すことはできるが、長いコンテキストやエージェント用途は厳しい |
32GB | 4ビット(必要17〜18GB)。Unsloth推奨の | 公式推奨の最低ライン。普段使いの基準 |
48GB以上 | 8ビット(必要24GB)や公式の約20GB版 | 余裕があり、長いコンテキストも扱いやすい |
※必要メモリはUnslothの公開値。長いコンテキストを使うほど、この値に加えてメモリが必要になります。
生成速度(1秒あたりのトークン数)は、公式もArtificial Analysisも具体的な数値を出していません。ループ型モデルへのローカル実行ツールの対応は始まったばかりで、速度は環境によって差が出るとモデルカードに書かれています。
Inkling 2 Miniの使い方:Ollama・llama.cpp・LM Studio・Hugging Face
いちばん手軽なのはOllamaで、コマンド1つで動かせます。 ただし公開直後のため、2026年11月21日時点ではOllamaのプレリリース版が必要です。
出典: Ollama 公式サイト
方法1:Ollama(Mac・DGX Spark)
- Ollamaのプレビューチャンネルからプレリリース版をインストールする
- ターミナルで次のコマンドを実行する
ollama run inkling-2-miniタグは latest・26b-a5b・26b-a5b-nvfp4(MLX向け)があり、いずれも約20GBです。Ollamaのページでは対応環境としてMac(メモリ32GB以上)とDGX Sparkが案内されており、Windowsでの動作は記載がありません。Ollama自体の使い方は「Ollamaとは」を参考にしてください。
方法2:llama.cpp/Llama App(Mac・Windows)
Hugging Faceの公式ブログでは、Llama App(macOS・Windows対応)で次のように起動する方法が紹介されています。OpenAI互換のローカルAPIが立ち上がるので、既存のツールからつなげます。
llama serve -hf ggml-org/Inkling-2-Mini-GGUF:IQ4_NL8ビット版を使う場合は末尾を :Q8_0 にします。
つまずきやすい点:UnslothのGGUFは、リポジトリ直下のファイルがUnsloth独自の層の並びになっており、指定されたビルドのllama.cpp(b12588-mix-c0c3de8)が必要です。本家のllama.cppで使うときは、Mainline_Support フォルダにあるファイルを選んでください。Unslothの推奨設定は temperature 1.0・top_p 1.0・top_k 0・min_p 0.0です。画像を読ませるときは mmproj-F16.gguf(639MB)も必要です。
方法3:LM Studio・Jan(GUIで使いたい人向け)
出典: LM Studio 公式サイト
モデルカードでは、GGUF形式でLM StudioとJanに対応するとされています。コマンドを使わずに画面で試したい人に向いています。
方法4:Hugging Face Transformers・vLLM・SGLang(サーバーで動かす)
GPUサーバーで動かすなら、Transformers、vLLM、SGLang、NVIDIA Dynamo、MLX(mlx-lm)などに対応しています。vLLMには公式のレシピ(GB200・B300・H100・H200・DGX Spark向け)があります。Transformersで使うクラス名はモデルカードとHugging Faceブログで書き方が違うため、コードを書くときは最新のモデルカードを確認してください。
方法5:Tinker(API・ファインチューニング)
自前のハードを用意せずに使う場合や、自社のデータで追加学習したい場合はTinkerを使います。Tinker Playgroundでブラウザから試すこともできます。
自社の業務システムやエージェントに組み込む場合は、ローカルで動かすのか、TinkerのAPIを使うのか、追加学習まで行うのかで工数と費用が大きく変わります。外部に開発を頼むときの費用の目安は「AI開発の費用相場」で整理しています。
このツールを自社のシステムや業務にどう組み込むか、ご提案します
初回相談は無料・30分(オンライン)。要件が決まっていなくても大丈夫です。改修100万円〜・PoC300万円〜(税別)
Inkling 2 Miniの弱み・できないこと
最も注意したいのは「日本語の品質が保証されていない」点と、「エージェントとして使うと確認なしにファイルを消すことがある」点です。 どちらもモデルカードに開発元自身が書いています。
弱み・制約 | 公式の記載 | 実務での対策 |
|---|---|---|
日本語対応が明記されていない | 「英語+一般的な多言語対応」。英語以外は品質が下がり、中国語のテストでは文が途切れたり言語が混ざったりした | 日本語中心の業務では、使う前に自社のデータで検証する |
自信を持って間違える | 大きいモデルより事実の誤りが出やすい。知識は総パラメータに比例し、ループでは増えない | 知識が要る作業は検索・社内文書の参照(RAG)と組み合わせる |
破壊的な操作をすることがある | ツール利用の信頼性が低めで、確認なしにファイルを削除・上書きすることがある | サンドボックスで実行し、取り消せない操作の前に人の承認を挟む |
推論が長いループにはまる | 特にコードのデバッグで起きやすい | 出力トークン数とエージェントのターン数に上限を設ける |
多ターン会話・複雑な指示が苦手 | MultiChallenge 50.0%、ComplexConstraints 33.4% | 指示を短く分け、チャットボット用途は慎重に評価する |
推論を完全には止められない |
| 短い応答が必要な用途は出力の長さで管理する |
出力はテキストのみ | 画像や音声は生成できない | 画像生成などは別のモデルを使う |
医療・法律など重要な用途 | 追加の学習と検証なしでは推奨しない | 専門分野では追加学習と人のチェックを前提にする |
日本語の品質は、2026年11月21日時点で公式にも第三者にも評価がありません。日本語で長い文章を書かせる、日本語で顧客対応をさせるといった用途なら、Qwen3.8-27Bなど他のモデルも候補に入れ、同じ日本語のタスクで出力を比べてから決めるのが無難です。
安全性・セキュリティの注意点
開発元は公開前に安全性を評価し、「既存のオープンウェイトモデルを超える危険な能力の上積みはない」と結論づけています。 そのうえで、使う側に次の対策を求めています。
- 重要な出力は人が確認する
- エージェントとして動かすときはサンドボックスの中で実行し、取り消せない操作の前に確認を挟む
- アプリ側にも安全策(入力・出力のフィルタなど)を入れる
公式が評価した項目は、迎合(ユーザーに合わせすぎること)、自傷に関わる話題への対応、拒否しすぎ・拒否しなさすぎ、生物・化学兵器やサイバー攻撃への悪用、制御を失うリスクなどです。不正な行動や破壊的な操作の割合(不正行動9.8%、隠れた不正8.3%、破壊的操作10.2%)は、比較相手の多くより低いとされています。それでも1割前後の割合で起こりうるので、ファイル操作やシェル実行を任せるなら、作業フォルダを限定し、バックアップを取ってから使ってください。
ループ型にすると、モデルの思考過程(CoT)を人が読んで監視しにくくなるのではないかという懸念もあります。公式は、このサイズでは監視のしやすさは大きく下がらなかったとしています。一方でMurati氏は「this may not stay the case(大きいモデルでもそうとは限らない)」と述べており、大型化したときの課題として残っています。
ローカルで動かす場合は、データが外部に送られない点が安全面の利点です。ただし、ダウンロードするファイルは公式(thinkingmachines やOllama公式ライブラリ、ggml-org・Unslothなど)のものを選びましょう。
他のモデルとの違い・選び方
手元で動かしたいならInkling 2 Mini、性能を優先してAPIで使うならInkling 2 Small、多ターン会話や事実の知識を重視するならQwen3.8-27Bも比べる、というのが選び方の目安です。
比較項目 | Inkling 2 Mini | Inkling 2 Small | Qwen3.8-27B |
|---|---|---|---|
開発元 | Thinking Machines Lab | Thinking Machines Lab | Alibaba(Qwen) |
総/アクティブパラメータ | 26.4B/3.4B(ループ込み5.4B) | 594B/17B | 27B |
ライセンス | Apache 2.0 | Apache 2.0 | Apache 2.0 |
ローカル実行 | 32GBのMacで可 | データセンター級GPUが必要 | 4ビット量子化ならVRAM 24GBのGPU 1枚で可 |
強い分野 | コーディング・検索エージェント・画面理解 | Miniと同系統で全体に上 | 多ターン会話・指示追従・事実の知識(Inkling 2 Miniの公式比較より) |
Tinker入力/出力単価 | $0.15/$0.50 | $0.30/$1.00 | $0.6975/$5.595 |
Tinker Serverless Inference | 非対応(2026年11月21日時点) | 対応(ベータ) | — |
※Tinker単価はUSD/100万トークン。2026年11月時点のTinker公式料金ページより。
用途別に選ぶなら、次のように考えると迷いにくくなります。
やりたいこと | おすすめ |
|---|---|
社外に出せないコードを手元のMacでエージェントに直させたい | Inkling 2 Mini |
画面のスクリーンショットを読ませてPC操作を自動化したい | Inkling 2 Mini(サンドボックス前提) |
できるだけ高い性能をAPIで使いたい | Inkling 2 Small |
自社データで安く追加学習したい | Inkling 2 Mini(Tinkerの学習単価がファミリーで最安) |
日本語で長文を書かせたい・顧客対応に使いたい | 複数のモデルを同じ日本語タスクで比べて検証 |
費用をとにかく抑えてAPIで使いたい | クローズドの軽量モデルも比較する |
Inkling 2 Miniはこんな人におすすめ
- メモリ32GB以上のMacやDGX Sparkを持っていて、ローカルでコーディングエージェントを動かしたい開発者
- ソースコードや社内文書を外部APIに送れない企業(ローカル実行ならデータが手元から出ない)
- 自社データで小さなモデルを追加学習したい人(Apache 2.0で、Tinkerの学習単価も安い)
- 画面理解やブラウザ操作をするエージェントを試したい人
- ループ型という新しい構造や、モデル内部の解釈に関心がある研究者(研究用モデルや、Goodfireによる解析結果も公開されている)
Inkling 2 Miniをおすすめしない人
- 日本語の文章作成や日本語での顧客対応がおもな用途の人(日本語の品質が公式に保証されていない)
- メモリ16GB以下のPCしかない人(低ビットの量子化なら読み込めても、品質と速度の面で実用的ではない)
- 事実の正確さが最優先の用途(自信を持って間違える傾向がある)
- 確認の仕組みなしにファイル操作を任せたい人(破壊的な操作の傾向が公式に書かれている)
- 設定なしで安定して動いてほしい人(公開直後で、Ollamaはプレリリース版が必要、GGUFはビルドの指定があるなど、まだ手間がかかる)
よくある質問
Inkling 2 Miniは日本語で使えますか?
日本語での品質は、2026年11月21日時点で確認されていません。モデルカードに日本語の記載はなく、「英語+一般的な多言語対応」で英語以外では品質が下がるとされています。日本語で使うなら、自分の用途で出力を試してから決めてください。
Windowsでも動きますか?
Hugging Faceブログでは、Llama AppがmacOSとWindowsに対応すると案内されており、UnslothもPowerShell用の手順を出しています。Ollamaのページには、2026年11月21日時点でMacとDGX Sparkしか書かれていません。WindowsではVRAM 32GB以上のGPUが推奨されています。
商用利用はできますか?
できます。ライセンスはApache 2.0で、商用利用・改変・再配布が認められています。ただし、出力の正確さや安全性は利用者側で確認する前提です。
無料で使えますか?
自分のPCで動かす場合、モデルの利用料はかかりません。TinkerのAPIを使う場合は、入力$0.15・出力$0.50(100万トークンあたり)の従量課金です。Tinkerの料金ページには、2026年11月時点で無料クレジットの記載はありません。
Inkling 2 SmallとMiniはどちらを選べばよいですか?
自分のPCで動かしたい、または追加学習の費用を抑えたいならMiniです。性能を優先し、APIやサーバーで動かせるならSmallが向いています。SmallはTinkerのServerless Inference(ベータ)の対象ですが、Miniは2026年11月21日時点で対象外です。
「ループ型」だと普通のモデルより遅くなりますか?
1トークンあたり中央の層を3回通すため、同じ重みの普通のモデルより計算は増えます。一方、Artificial Analysisの測定では、同じスコアのQwen3.8 27Bより1タスクあたり約4倍速く終わっています。ローカルでの速度は実行ツールの対応状況とハードで大きく変わります。
まとめ
Inkling 2 Miniは、Thinking Machines Labが2026年11月20日に公開した、26.4B・約20GBのApache 2.0のオープンウェイトモデルです。中央の層を3回くり返すループ型の設計で、メモリ32GBのMacでも動くサイズのまま、コーディングや検索エージェント、画面の理解で同規模のモデルを上回る結果を出しています。
一方で、日本語の品質は保証されておらず、事実の知識や多ターン会話はQwen3.8-27Bに及ばず、エージェントとして動かすと確認なしにファイルを消すことがあります。使うときは、ローカル実行の利点を生かしつつ、サンドボックス・人の承認・出力の上限をセットにしてください。
公開から間もないため、Ollamaの正式版への対応やTinkerのServerless Inferenceへの追加など、状況は数週間で変わる可能性があります。使う前に、公式の発表ページ・モデルカード・Tinker料金ページを確認してください。
このツールを自社のシステムや業務にどう組み込むか、ご提案します
この記事の著者

AI革命
編集部
AI革命株式会社の編集部です。最新のAI技術動向から実践的な導入事例まで、企業のデジタル変革に役立つ情報をお届けしています。豊富な経験と専門知識を活かし、読者の皆様にとって価値のあるコンテンツを制作しています。
最新記事
Claude Maxプランとは?料金(税込月約1.7万円)・Pro/Ultraとの違い・選ぶべき人を解説【2026年11月】
2026/04/02
ChatGPT Workとは?料金・使用上限・対応プラン、GPT-6.2対応とClaude Coworkとの違い【2026年11月】
2026/07/10
EU AI規制法(EU AI Act)完全施行ガイド|2026年8月2日に始まったこと・日本企業の対応義務
2026/06/06
Claude Agent SDK 課金変更【6月15日】は一時停止|Pro/Max/クレジット・実質値上げの今と10月のAPIクレジットを解説
2026/06/09
Anthropic Project Glasswing とは|AWS・Apple・Google・Microsoft・JPMorgan 12社連携Claude Mythosサイバー防衛100Mドル徹底解説
2026/05/25
OpenRouter経由のMiniMaxでプロンプト漏洩の可能性|ZDR指定でも読まれた理由と今すぐやる設定【2026年11月】
2026/11/22

