
Thinking Machines Lab(TML)とは?Mira Murati創業・フルデュプレックスAI・Inkling・Tinkerの機能と料金を解説【2026年10月】
この記事のポイント
Thinking Machines Lab(TML)は元OpenAI CTOのMira Muratiが2025年に設立したAI企業です。Tinker・Inkling・0.40秒応答のインタラクションモデルの中身と料金、いま使えるもの・使えないもの、資金調達や共同創業者の離職までを2026年10月時点で整理します。
Thinking Machines Lab(TML)は、元OpenAI CTOのMira Muratiが2025年2月にサンフランシスコで設立したAI研究・製品の会社です。2026年10月時点の柱は3つで、オープンウェイトモデルを追加学習できるAPI「Tinker」、自社のオープンウェイトLLM「Inkling」系、聞きながら話す全二重(フルデュプレックス)の「インタラクションモデル」です。
ただし、インタラクションモデルはいまも研究プレビューで、一般の人は使えません。誰でも使えるのは、TinkerとInklingの2つです。
この記事でわかること
- TMLの会社概要と、創業メンバーのその後(2026年10月時点)
- Tinker・Inkling・インタラクションモデルの中身と、いま使えるかどうか
- 「0.40秒応答」が何の数字なのかと、ベンチマークの読み方
- Tinkerの現行料金(期間限定割引と通常価格)
- GPT-Live・Gemini 3.8 Liveなど、ほかの全二重音声AIとの違い
- 資金調達・提携の最新の報道と、セキュリティ面の注意
この記事の対象読者
生成AI業界の動きを追っているエンジニア・研究者、オープンウェイトモデルの追加学習を検討している開発チーム、リアルタイム音声AIの導入を考えている企業の担当者を想定しています。
出典: Thinking Machines Lab 公式サイト
Thinking Machines Lab(TML)とは?会社の基本情報
Thinking Machines Labは、Mira Muratiが率いる非上場のAI企業です。法人形態はPublic Benefit Corporation(公益法人型の株式会社)で、利益だけでなく社会的な目的も掲げる会社として設立されています。Wikipediaによると、Muratiが取締役会で決定票を持ち、創業株主の議決権は一般株主の100倍に設定されています。
項目 | 内容 |
|---|---|
会社名 | Thinking Machines Lab(略称: TML) |
設立 | 2025年2月 |
本社 | 米国サンフランシスコ |
CEO | Mira Murati(元OpenAI CTO) |
チーフサイエンティスト | John Schulman(OpenAI共同創業者) |
CTO | Soumith Chintala(PyTorchの生みの親。2026年1月に就任) |
法人形態 | Public Benefit Corporation(非上場) |
従業員数 | 100人規模(2026年1月の報道) |
年換算売上 | 1億ドル超との報道(2026年9月。公式発表ではない) |
公式サイト | https://thinkingmachines.ai/ |
公式サイトが掲げるミッションは、誰もが自分の目的に合わせてAIを使いこなせるよう、知識とツールを広く届けることです。公式は次の3つを課題に挙げています。
- 最先端のAIシステムについて、科学的な理解が足りていない
- AIの学習のノウハウが、一部の大手研究機関に集中している
- AIを自分の用途に合わせて調整するのが難しい
追加学習の基盤を外部に開くTinkerと、重みを公開したInklingは、2と3への答えにあたります。生成AI全体の位置づけを先に押さえたい方は、生成AIとは何か・仕組み・種類・活用事例を総合解説が入口になります。
2025〜2026年の主な動き
設立から2026年10月までの主な出来事です。公式発表と報道は「出典の種類」の列で分けています。
時期 | 出来事 | 出典の種類 |
|---|---|---|
2025年2月 | 設立を発表 | 公式・報道 |
2025年7月 | シードで約20億ドルを調達。評価額120億ドル(a16z主導) | 報道 |
2025年10月 | Tinkerを発表 | 公式 |
2025年12月 | Tinkerのウェイトリストを撤廃し、一般提供を開始 | 公式 |
2026年1月 | CTOのBarret Zophを解任。CTOにSoumith Chintalaが就任 | 報道 |
2026年3月 | NVIDIAと長期の戦略提携 | 公式 |
2026年4月 | Google CloudのAI Hypercomputerの利用を拡大 | Google Cloud公式 |
2026年5月11日 | インタラクションモデル(TML-Interaction-Small)を研究プレビューとして発表 | 公式 |
2026年7月15日 | 自社初のオープンウェイトLLM「Inkling」を公開 | 公式 |
2026年7月末 | 共同創業者のLilian Wengが退社し、OpenAIへ | 報道 |
2026年7月30日 | 小型版「Inkling-Small」を公開 | 公式 |
2026年9月 | 評価額400億ドル以上での調達を交渉中との報道 | 報道 |
2026年10月15日 | Tinker 1周年。企業向け機能やフルファインチューニング(ベータ)を追加 | 公式 |
創業者Mira Muratiとは?経歴とTML設立の背景
Mira Muratiは、OpenAIでChatGPTなどの開発を率いたあと独立し、TMLを立ち上げた人物です。
Mira Muratiのプロフィール
Muratiは1988年にアルバニアのヴロラで生まれました。カナダのPearson College UWCを経て、米国のColby College(BA)とダートマス大学(機械工学のBEng)を卒業しています。
学生時代にGoldman Sachs東京などでインターンを経験し、2013〜2016年はテスラでModel Xのプロダクトマネージャーを務めました。その後、Leap Motion(現Ultraleap)でプロダクトとエンジニアリングを統括し、2018年にOpenAIへ入社しています。
OpenAIではChatGPT・DALL-E・Codex・Soraの開発を率い、2022年5月にCTOに就任しました。2023年11月のSam Altman解任騒動では、3日間だけ暫定CEOを務めています。2024年9月にOpenAIを去ると発表し、2025年2月にTMLを設立しました。
創業時のメンバーと離職の経緯
TMLは、OpenAI出身の研究者を中心に6人の共同創業者で始まりました。2026年10月時点で残っているのは、MuratiとJohn Schulmanの2人です。
名前 | 主な経歴 | 2026年10月時点の状況 |
|---|---|---|
Mira Murati | 元OpenAI CTO | CEOとして在籍 |
John Schulman | OpenAI共同創業者 | チーフサイエンティストとして在籍 |
Barret Zoph | 元OpenAI 研究VP | 2026年1月に解任され、OpenAIへ |
Luke Metz | OpenAI出身 | 2026年1月に退社し、OpenAIへ |
Lilian Weng | 元OpenAI 安全研究VP | 2026年7月末に退社し、OpenAIへ(本人は健康上の理由と説明) |
Andrew Tulloch | OpenAI・Meta出身 | 2025年10月にMeta Superintelligence Labsへ |
Zophの解任理由は、報道によって説明が食い違っています。Muratiは社内向けに「非倫理的な行為」と説明したと報じられた一方、本人は「他社と交渉していたことが知られて解任された」と説明したとも報じられています。TMLは詳しい理由を公表していません。
このほか、研究者のDevendra Chaplotが2026年3月にxAIへ移ったと報じられています。新CTOのSoumith Chintalaは、深層学習のフレームワークPyTorchの生みの親として知られる人物です。
アドバイザーには、元OpenAIチーフリサーチオフィサーのBob McGrewと、元OpenAI研究者のAlec Radfordが名を連ねると報じられています。投資家にはa16z、NVIDIA、AMD、Cisco、Jane Street、Accelなどが入っており、アルバニア政府も1,000万ドルを出資したと報じられました。
TMLの3つの柱:Tinker・Inkling・インタラクションモデル
TMLの製品は、2026年7月のInkling公開で3本柱になりました。いま誰でも使えるのはTinkerとInklingで、インタラクションモデルは研究プレビューのままです。
製品 | 何をするものか | 公開状況(2026年10月) | 料金 | 主な対象 |
|---|---|---|---|---|
Tinker | オープンウェイトモデルを自分のデータで追加学習するAPI | 一般提供(2025年12月にウェイトリスト撤廃) | 従量課金 | 研究者・AIエンジニア |
Inkling | 自社開発のオープンウェイトLLM(総975B/アクティブ41B) | 重みを公開(Apache 2.0) | 重みは無料。推論・学習の費用は別 | 開発者・企業 |
Inkling-Small | Inklingの小型版(総276B/アクティブ12B) | 重みを公開(Apache 2.0) | 同上 | 開発者・企業 |
インタラクションモデル(TML-Interaction-Small) | 聞きながら話す全二重のリアルタイムAI | 研究プレビュー(API・一般公開なし) | 未発表 | 現時点では一般利用不可 |
3つは別々の製品ではなく、つながっています。公式のInkling発表には「インタラクションモデルの仕組みで、バックグラウンドの推論モデルとして働くことが設計の大きな目標」と書かれています。会話はインタラクションモデルが受け持ち、深く考える作業はInklingが裏で受け持つ、という分担です。
なお、TML-Interaction-SmallとInkling-Smallはどちらも「総276B/アクティブ12B」ですが、同じベースモデルかどうかは公式に書かれていません。
フルデュプレックスAIとは?TML-Interaction-Smallが実現すること
フルデュプレックス(全二重)のAIは、人が話している最中も聞き続け、必要なら同時に話せるAIです。TML-Interaction-Smallは、音声だけでなく映像やテキストも含めてひとつのモデルで処理し、全二重でやりとりします。
従来のAIとの根本的な違い
従来の音声AIの多くは、ターン制で動いてきました。人が話し終わるのを待ち、AIが考え、AIが話す、という順番です。トランシーバーで「どうぞ」と言ってから相手が話す形に近い動き方です。
全二重は電話に近い形です。お互いが同時に聞いて話せるので、相づちを打つ、途中で割り込む、相手の様子を見て黙る、といった動きができます。
方式 | たとえ | AIの動き |
|---|---|---|
ターン制 | トランシーバー | 話し終わるのを待ってから処理し、答える |
全二重(フルデュプレックス) | 電話 | 聞きながら処理し、割り込みや相づちもできる |
ただし、2026年10月時点では全二重の音声AIはTMLだけのものではありません。OpenAIのGPT-Live(2026年7月)やGoogleのGemini 3.8 Live(2026年9月)も一般提供されています。TMLの違いは、映像も含めて同時に扱う点と、裏で推論モデルを動かす分担の設計にあります(いずれもTMLの発表による)。
TML-Interaction-Smallの技術仕様
2026年5月11日の公式ブログで公開された主な仕様です。
項目 | 内容 |
|---|---|
モデル名 | TML-Interaction-Small(研究プレビュー) |
パラメータ | 総276B(MoE)/アクティブ12B |
処理の単位 | 0.2秒(200ミリ秒)のマイクロターン |
入力 | 音声・映像(画像)・テキスト |
出力 | 音声・テキスト |
発表日 | 2026年5月11日 |
一般公開・API・料金 | 未発表(2026年10月25日時点) |
MoE(Mixture of Experts)は、たくさんの専門家(エキスパート)を持ちながら、1回の処理ではその一部だけを動かす作り方です。全体は276Bでも、1回に動くのは12B分なので、反応を速く保ちやすくなります。
3つの主要技術
1. マイクロターン(0.2秒ずつ聞いて話す)
0.2秒分の入力を処理し、0.2秒分を出力する、という動きを途切れなく繰り返します。入力と出力を「ターン」ではなく連続した流れとして扱うので、話し終わりを判定する仕組み(VAD)がいりません。沈黙や発話の重なりも、そのまま文脈として残ります。
2. エンコーダを使わない早期融合
音声は dMel という表現と軽い埋め込み層、画像は40×40のパッチを hMLP で処理し、音声の出力には flow head を使います。専用のエンコーダを別に用意せず、すべてをTransformer本体とゼロから一緒に学習させています。
3. インタラクションモデルとバックグラウンドモデルの分担
- インタラクションモデル: リアルタイムの会話を受け持つ
- バックグラウンドモデル: 深い推論・ツールの利用・ブラウジングを非同期で受け持ち、結果が出たら会話に織り込む
会話を止めずに調べものをする、という動きを狙った設計です。バックグラウンドでツールを使う考え方は、AIエージェントとは?仕組みと活用事例を解説で扱っている仕組みに近いものです。
TML独自の能力:TimeSpeak・CueSpeak
TMLは、時間に合わせて話す力を測る評価を自分で作りました。比較相手はGPT-realtime-2.0(minimal設定)です。
評価 | 測っていること | TML | GPT-realtime-2.0(minimal) |
|---|---|---|---|
TimeSpeak | 指定したタイミングで話し始められるか | 64.7 | 4.3 |
CueSpeak | 合図や状況に応じて話し始められるか | 81.7 | 2.9 |
RepCount-A | 映像の動作を数えながら反応できるか | 35.4 | 1.3 |
ProactiveVideoQA | 映像を見て自分から答えられるか | 33.5 | 25.0(黙っているだけの基準値も25.0) |
Charades | 映像の出来事に合わせて反応できるか | 32.4 | 0 |
公式は、思考を強めた設定を含むほかのモデルも「同程度かそれ以下」だったと書いています。ターン制のモデルが苦手な領域なので差が大きく出ますが、どれもTMLが作った評価である点は割り引いて読む必要があります。
ベンチマーク比較:0.40秒応答は実際どの程度速いのか
「0.40秒」は、FD-bench V1という評価でのターン交代の遅延です。どんな質問にも0.40秒で答えるという意味ではありません。また、TMLが全項目で勝っているわけでもありません。
TMLの公式ブログが公開した数値を、負けている項目も含めて載せます。比較相手は2026年5月時点のモデルです。
ベンチマーク | TML-Interaction-Small | GPT-realtime-2.0(minimal) | GPT-realtime-1.5 | Gemini-3.1-flash-live(minimal) | Qwen 3.5 Omni-plus-realtime | GPT-realtime-2.0(xhigh) | Gemini-3.1-flash-live(high) |
|---|---|---|---|---|---|---|---|
FD-bench V1 ターン交代の遅延(秒・低いほど良い) | 0.40 | 1.18 | 0.59 | 0.57 | 2.14 | 1.63 | 0.94 |
FD-bench V1.5 平均(音声) | 77.8 | 46.8 | 48.3 | 54.3 | 39.0 | 47.8 | 45.5 |
FD-bench V3 回答品質/pass@1(音声+ツール、%) | 82.8*/68.0* | 80.0/52.0 | 77.9/55.0 | 68.5/48.0 | 60.0/50.0 | 81.0/58.0 | 71.4/48.0 |
QIVD 正答率(%) | 54.0 | 57.5 | 41.2 | 54.7 | 59.0 | 58.2 | 56.1 |
Audio MultiChallenge APR(%) | 43.4 | 37.6 | 34.7 | 26.8 | — | 48.5 | 36.1 |
BigBench Audio(%) | 75.7/96.5* | 71.8 | 81.4 | 71.3 | 73.0 | 96.6 | 96.6 |
IFEval(VoiceBench・音声、%) | 82.1 | 81.7 | 68.1 | 67.6 | 80.3 | 83.2 | 82.8 |
IFEval(テキスト、%) | 89.7 | 89.6 | 87.5 | 85.8 | 83.4 | 95.2 | 90.0 |
HarmBench 拒否率(テキスト、%) | 99.0 | 99.5 | 100.0 | 99.0 | 99.5 | 100.0 | 98.0 |
* バックグラウンドのエージェントを有効にしたときの値
出典: Thinking Machines Lab 公式ブログ「Interaction Models」
数字の読み方
- TMLが強い領域: ターン交代の速さ、全二重のやりとりの質(FD-bench V1.5)、時間に合わせた発話
- TMLが上位でない領域: 映像の質問(QIVD)、難しい音声の指示(Audio MultiChallenge)、音声での推論(BigBench Audio)、指示への従いやすさ(IFEval)。ここでは思考を強めたGPT-realtime-2.0(xhigh)やQwenが上回ります
- 遅延の差: GPT-realtime-2.0(minimal)の1.18秒とは約3倍の差ですが、GPT-realtime-1.5(0.59秒)やGemini 3.1 Flash Live(0.57秒)との差は0.2秒ほどです
注意したい点
- 数値はすべてTMLの自社測定で、第三者の独立した検証はまだありません。全二重のツール利用を測る独立ベンチマーク「Full-Duplex-Bench-v3」(arXiv 2604.04847)にも、TMLのモデルは入っていません
- 比較相手は5月時点のモデルで、各社はすでに後継を出しています。GPT-LiveやGemini 3.8 Liveと同じ条件で比べた公開データは見つかっていません
一般的には、人同士の会話の切り替えは数百ミリ秒ほどとされます。0.40秒はその範囲に近い数字で、会話が「待たされている」と感じにくい水準といえます。OpenAI側の比較相手について詳しく知りたい方は、GPT-Realtime-2とはで仕様と料金を確認できます。
Inkling・Inkling-Small:TML初のオープンウェイトモデル
出典: Thinking Machines Lab - Introducing Inkling
Inklingは、TMLが2026年7月15日に公開した自社初のオープンウェイトLLMです。重みはApache 2.0ライセンスで公開されており、商用でも使えます。
項目 | Inkling | Inkling-Small |
|---|---|---|
公開日 | 2026年7月15日 | 2026年7月30日 |
パラメータ | 総975B/アクティブ41B(MoE) | 総276B/アクティブ12B(MoE) |
入力 | テキスト・画像・音声 | テキスト・画像・音声 |
ライセンス | Apache 2.0 | Apache 2.0 |
使える場所 | Hugging Face(重み)、Tinker、Together AI、Fireworks、Modal、Databricks、Basetenなど | Hugging Face(重み)、Tinkerなど |
Inklingは最大100万トークンの文脈に対応します(Tinker上では64K版と256K版で提供)。公式は、インタラクションモデルの裏で動く推論役になることを設計の目標に挙げています。
オープンウェイトの公開にあたって、TMLは「A Safe Path to Open Weights」(2026年7月31日)という文書を出しました。外部の4組織によるレッドチーム、悪用目的の追加学習への耐性の検証、段階的な公開を行ったと説明しています。一方で、オープンウェイトの影響には不確実性があることもTML自身が認めています。オープンウェイトをめぐる各社の立場は、Anthropicのオープンウェイトへの立場も参考になります。
モデルの性能や第三者APIの料金は、Thinking Machines InklingとはとInkling-Smallとはで詳しく扱っています。
Tinker(ファインチューニングAPI)の機能と料金
Tinkerは、オープンウェイトモデルを自分のデータで追加学習するためのAPIです。学習ループは利用者がPythonで書き、GPUの手配や分散処理はTMLが受け持ちます。
Tinkerとは何か
Tinkerは2025年10月1日に発表され、2025年12月12日にウェイトリストを撤廃して一般提供になりました。登録すれば誰でも使えます。
ただし、ChatGPTのような画面で使うアプリではありません。学習ループを自分のコードで書ける研究者・AIエンジニア向けの道具です。公式は「データと学習ループは利用者の管理下にある」と説明しています。
出典: Thinking Machines Lab - Announcing Tinker
Tinkerの主な機能
- 4つの基本関数:
sample(生成)、forward_backward(勾配の計算)、optim_step(重みの更新)、save_state(途中の保存)を組み合わせて学習ループを書く - 学習の手法: LoRA(少ないパラメータだけを調整する方法)が中心。フルファインチューニングはベータ。SFT、強化学習(RL)、RLHF、蒸留、独自の損失関数にも対応
- 推論: 保存したチェックポイントはどれでも推論に使える。ブラウザで試せるPlaygroundあり。OpenAI・Anthropic互換のサンプリングAPI(ベータ)
- 企業向けの機能(2026年10月追加): プロジェクト単位のアクセス管理、SSO、細かい権限管理(RBAC)、監査ログAPI、暗号化、プライベートVPC接続
- 運用: セッションの監視・中断、チェックポイントの系譜、学習・推論・保存ごとのコスト内訳
- Cookbook: 数学、コード、検索エージェント、画像分類などの学習レシピを公開
提供形態は、Web API・Python SDK(tinker)・コンソール・Playgroundです。
1周年の発表では、利用企業の事例も紹介されています。いずれもTMLが発表した数字です。
- Bridgewater: Text-to-SQLのモデルが、比較したフロンティアモデルより高い精度を出し、コストは15%
- Sundial: LaTeXのエラー修正で、ほとんどのフロンティアモデルを上回り、コストは比較相手の7%
- Glean: 独自の検索エージェントが2倍速くなり、トークンは25%減、品質は維持
追加学習とRAG(検索で情報を足す方法)のどちらを選ぶべきか迷う場合は、ファインチューニングとRAGの違いで判断の基準を整理しています。
対応モデル(2026年10月確認)
最初はQwenとLlamaのテキストモデル14種でしたが、いまは4B〜1Tパラメータのモデルを扱えます。ほとんどが画像入力にも対応しています。
シリーズ | 例 |
|---|---|
Inkling(TML) | Inkling、Inkling-Small |
Qwen | Qwen3.5-397B-A17B など |
NVIDIA Nemotron | Nemotron-3-Ultra-550B-A55B など |
Moonshot Kimi | Kimi-K2.6 など |
Zhipu GLM | GLM-5.3 |
DeepSeek | DeepSeek-V4.1-Flash |
OpenAI GPT-OSS | GPT-OSS-20B、GPT-OSS-120B |
2026年10月23日に、DeepSeek-V3.1、Qwen3.6-27B、Nemotron-3-Nano-30B-A3Bの提供が終わりました。これらで学習していた場合は、別のモデルへの移行が必要です。
Tinkerの料金(2026年10月・公式料金ページで確認)
Tinkerは従量課金です。使ったトークンの分だけ支払い、待っている時間には課金されません。単位はUSD/100万トークンです。
モデル(抜粋) | 文脈長 | Prefill(入力) | キャッシュ済みPrefill | Sample(出力) | Train(学習) |
|---|---|---|---|---|---|
Inkling ★ | 64K | $1.87 | $0.374 | $4.68 | $5.61 |
Inkling ★ | 256K | $1.87 | $0.374 | $4.68 | $11.23 |
Inkling-Small ★ | 64K | $0.58 | $0.116 | $1.44 | $1.73 |
Inkling-Small ★ | 256K | $0.58 | $0.116 | $1.44 | $3.47 |
Nemotron-3-Ultra-550B-A55B ★ | 64K | $1.80 | $0.36 | $6.225 | $5.478 |
Kimi-K2.6 | 32K | $2.205 | $0.441 | $5.49 | $4.84 |
GLM-5.3 | 256K | $3.78 | $0.756 | $12.15 | $14.58 |
Qwen3.5-397B-A17B | 64K | $1.65 | $0.33 | $7.50 | $6.60 |
DeepSeek-V4.1-Flash | 256K | $0.60 | $0.12 | $3.60 | $4.98 |
GPT-OSS-120B | 32K | $0.33 | $0.066 | $0.84 | $0.737 |
GPT-OSS-20B | 32K | $0.18 | $0.036 | $0.45 | $0.396 |
出典: Tinker 公式ドキュメント(Models & Pricing)
- ★印は期間限定の50%オフ。終了日は公表されておらず、通常価格はちょうど2倍です。予算を組むときは、通常価格でも試算しておくと安全です
- 料金表全体の幅は、Prefill $0.184〜$3.78、Sample $0.45〜$12.15、Train $0.396〜$15.40です
- チェックポイントの保存は$0.10/GB・月
- 2026年10月の改定で、Inkling系の256K版のPrefillとSampleが64K版と同じ額に下がりました
- 無料枠や固定の月額プランは、公式の料金ページに記載がありません。企業向け機能のプラン・価格も書かれていません
サーバーレス推論(ベータ・ウェイトリスト制)
モデル | Prefill | キャッシュ済み | Sample |
|---|---|---|---|
Inkling-Small | $0.30 | $0.06 | $1.20 |
Inkling | $1.00 | $0.17 | $4.05 |
公式は、サーバーレス推論を本番の大量利用には勧めていません。本格的な本番向けの推論サービスは開発中で、こちらもウェイトリスト制です。
業務でTinkerやInklingを使う場合
Tinkerで学習したモデルやInklingを社内の業務に使うときは、学習とトークンの費用に加えて、既存システムとつなぐ部分の開発と運用の費用がかかります。組み込み方ごとの費用の目安は、AI開発の費用相場【2026年10月】AI受託開発の改修・PoC・本開発の価格と見積の内訳にまとめています。
資金調達・評価額・パートナーシップの現状
正式に発表された調達は、2025年7月のシード(評価額120億ドル)が最後です。2026年9月には「評価額400億ドル以上で交渉中」と報じられましたが、10月25日時点で完了は確認できていません。
資金調達の経緯
時期 | 内容 | 評価額 | 確度 |
|---|---|---|---|
2025年7月 | a16z主導のシードで約20億ドルを調達 | 120億ドル | 報道(広く確認) |
2025年秋〜冬 | 評価額500億ドルでの調達を打診したが成立せず | — | 報道 |
2026年3月 | NVIDIAが額非公表の大型出資(戦略提携の一部) | 非公表 | 公式 |
2026年9月 | Accelが10億ドル規模の調達を主導する交渉中 | 400億ドル以上 | 報道(交渉中) |
2026年9月の調達については、報道によって規模が違います。TechCrunchはThe Informationを引用して「Accel主導で10億ドル規模」と伝えました。The Informationは調達全体が50〜60億ドル規模で、NVIDIAが約25億ドルを出す方向で協議しているとも報じています。同じ報道では、年換算の売上が1億ドルを超えたとされていますが、公式の発表ではありません。
主要パートナーシップ
NVIDIA(2026年3月10日): 長期の戦略提携です。次世代GPUのVera Rubinを1ギガワット以上使う計画で、展開は2027年初めの予定とされています。NVIDIA公式ブログでも発表されました。
Google Cloud(2026年4月22日): Google CloudのAI Hypercomputerの利用を広げる発表です。NVIDIA GB300 NVL72を積んだA4X Max VMを最初期に使う顧客の1社で、初期テストでは学習・推論が前の世代のGPUより約2倍速かったとされています。金額は公表されていません(「数十億ドル規模」との匿名情報の報道はあります)。独占契約ではありません。出典はGoogle Cloud公式プレスリリースです。
他社サービスとの比較
リアルタイム音声AIとして比べると、TMLのインタラクションモデルは「まだ使えない」点が最大の違いです。追加学習の基盤として比べると、Tinkerは「学習ループを自分で書ける」点が特徴です。
会話AIとしての比較(リアルタイム音声領域)
性能の数値は同じ条件で比べたデータがないため、ここでは公開状況と料金で比べます。各社の情報は2026年10月時点のものです。
比較項目 | TML-Interaction-Small | OpenAI GPT-Live | Google Gemini 3.8 Live | Microsoft MAI-Realtime | OpenAI GPT-realtime-2 |
|---|---|---|---|---|---|
公開状況 | 研究プレビュー(一般利用不可) | 2026年7月からChatGPTで提供 | 2026年9月からGemini API・アプリで提供 | 先行アクセスで見つかった段階(公式発表なし) | API一般提供 |
料金 | 未発表 | ChatGPTのプランに含まれる(miniは無料ユーザーの既定) | API: 音声入力$3.00・音声出力$12.00/100万トークン。無料枠あり | 未公開 | 従量課金 |
映像の入力 | あり(音声と同時に処理) | — | — | 未公開 | — |
裏での推論・ツール利用 | バックグラウンドモデルが担当 | — | Extended Thinkingあり | 未公開 | ツール呼び出しに対応 |
日本語 | 未発表 | — | — | 未公開 | — |
ベンチの独立検証 | なし | — | — | — | 独立ベンチ「Full-Duplex-Bench-v3」に含まれる |
「—」は本記事で確認できていない項目です。導入を検討する場合は各社の公式ドキュメントで最新の対応状況を確かめてください。
今すぐ全二重の音声AIを試したいなら、GPT-LiveかGemini 3.8 Liveが現実的です。それぞれの詳細はGPT-Liveとは、Gemini 3.8 Liveとは、MAI-Realtimeとはで確認できます。
ファインチューニングの手段としての比較(Tinker vs ほかの方法)
比較項目 | Tinker(TML) | OpenAIのファインチューニング | 自前のGPU(Hugging Faceのライブラリなど) |
|---|---|---|---|
学習できるモデル | オープンウェイト(Inkling、Qwen、Kimi、GPT-OSSなど。4B〜1T) | OpenAIのモデル(クローズド) | オープンウェイト全般 |
学習ループの自由度 | 高い(自分のコードで書く。RLや独自損失も可) | 低め(データを渡して学習を依頼する形) | 最も高い |
GPU・インフラの管理 | TMLが受け持つ | OpenAIが受け持つ | 自分で用意・運用する |
互換API | OpenAI・Anthropic互換(ベータ) | OpenAI API | 自分で用意する |
料金の考え方 | トークン単位の従量課金 | トークン単位の従量課金 | GPUの購入・レンタル費 |
向くチーム | 研究者・MLエンジニアのいるチーム | 手早くGPTを用途に合わせたいチーム | 大きな計算資源と運用体制があるチーム |
TinkerはAPIで手軽に使えるサービスと、すべてを自前でやる方法の中間にあたります。学習の中身は自由に組みたいが、GPUの運用はしたくない、というチームに合います。
TMLの研究成果:LLM推論の非決定性解消
出典: Thinking Machines Lab ブログ - Defeating Nondeterminism in LLM Inference
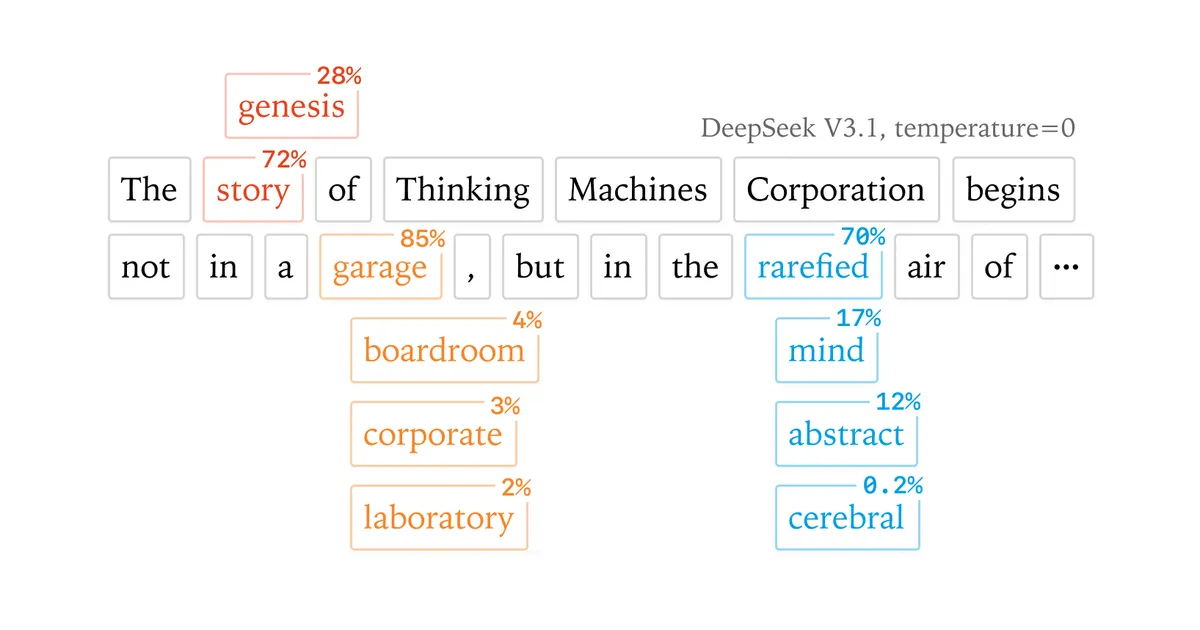
TMLは製品を出す前から研究ブログで注目を集めていました。代表的なのが、2025年9月の「Defeating Nondeterminism in LLM Inference」です。
Temperatureを0にしても、同じプロンプトから違う出力が出ることがあります。TMLはこの原因を、GPUの計算がバッチの大きさによって結果を少し変えてしまう点にあると分析しました。ブログでは、同じプロンプトを1,000回生成させると80通りの出力が出た例を示し、バッチの大きさに左右されない計算方法(バッチ不変カーネル)を公開しています。
この研究はインタラクションモデルにもつながっています。インタラクションモデルの推論では、バッチ不変カーネルを使っても処理の上乗せは5%未満に抑えたと公式ブログに書かれています。
プライバシー・セキュリティの注意点
業務データを扱うなら、Tinkerのデータ方針と、まだ確認できていない項目を分けて押さえておく必要があります。
Tinkerのデータ方針(公式)
- 「データは利用者のもの。利用者のコンテンツでモデルを学習しない」と公式ページに明記されています
- 学習データと学習ループは利用者の管理下に置かれます
- 2026年10月から、SSO・RBAC・監査ログAPI・暗号化・プライベートVPC接続といった企業向けの機能が加わりました
プライバシーポリシー(2025年8月18日付の版)で確認できる点
- 集める情報は、利用者が入力した情報、自動で集める情報(端末・位置・Cookie)、公開情報の3種類
- CCPAでいう個人情報の「販売」「共有」はしていないと明記
- 「完全なセキュリティは保証できない」と書かれている
- データは米国やほかの国へ移される可能性がある
- 保持期間に固定の定めはなく、業務上・法的な必要に応じて決めるとされている
確認できていない点(2026年10月時点)
- SOC 2などの第三者認証を取っているかどうか
- データを保存する地域(リージョン)
- 日本の個人情報保護法への対応についての言及
利用前には、最新の利用規約とプライバシーポリシーを確かめてください。個人情報や機密情報を学習データに入れる場合は、社内の基準に照らして事前に評価しておくと安心です。
インタラクションモデルの安全対策と注意点
公式ブログによると、拒否の応答を音声向けに調整し、自然でありながらはっきり断るように学習させています。自動のレッドチームで複数ターンの音声会話を作り、テキストのモデルに近い拒否の振る舞いを保ったと説明しています(HarmBenchの拒否率は99.0%)。
一方で、カメラとマイクの入力を常に流し続ける設計なので、一般公開されれば、録画・録音の保存、周りの人の映り込み、同意の取り方が論点になります。TMLはこの点の方針をまだ公表していません。
できること・現時点でできないこと
2026年10月時点で、TMLの製品で実際にできることは「オープンウェイトモデルの追加学習と推論」です。リアルタイムの全二重会話は、まだ外部の人が使える段階ではありません。
現時点でできること
カテゴリ | 内容 |
|---|---|
追加学習 | Tinkerでオープンウェイトモデル(Inkling、Qwen、Kimi、GPT-OSSなど)をLoRAで追加学習。フルファインチューニングはベータ |
強化学習・蒸留 | RL、RLHF、蒸留、独自の損失関数での学習 |
推論 | 学習したチェックポイントでの推論、Playground、OpenAI・Anthropic互換API(ベータ) |
モデルの入手 | Inkling・Inkling-Smallの重みをHugging Faceから無料でダウンロード |
他社基盤での利用 | Together AI、Fireworks、Modal、Databricks、BasetenなどでInklingを使う |
現時点でできないこと・制約
制約 | 内容 |
|---|---|
インタラクションモデルの利用 | 研究プレビューのみ。一般公開・API・SDK・料金はすべて未発表 |
一般向けアプリ | ChatGPTのような、誰でも画面から使える会話アプリはない |
クローズドモデルの学習 | TinkerではGPT・Claude・Geminiのようなクローズドなモデルは学習できない |
本番向けの推論 | サーバーレス推論はベータで、大量利用は非推奨。本格的な推論サービスは開発中 |
日本語対応 | 公式サイト・ドキュメントは英語。インタラクションモデルが対応する言語は未発表 |
長時間の会話 | インタラクションモデルは、連続する音声・映像で文脈がすぐ膨らむため、長時間のセッションに課題がある(公式) |
回線 | 低遅延のストリーミングには安定した回線が必要で、回線が悪いと品質が落ちる(公式) |
公式ブログ(2026年5月)は「数か月のうちに限定の研究プレビューを開き、年内に広く公開する」としていました。しかし10月25日時点では、広い公開や限定プレビュー開始の公式発表は見つかっていません。
こんな人・企業に向いている
TMLの製品で今すぐ価値を出せるのは、オープンウェイトモデルを自分たちで調整したいチームです。音声AIを今すぐ業務で使いたい人には、まだ向きません。
いま使える・使えないの早見表
やりたいこと | TMLで今できるか | 代わりの選択肢 |
|---|---|---|
オープンウェイトモデルを自社データで学習 | ○ Tinker | 自前GPU、ほかの学習サービス |
高性能なオープンウェイトLLMを手元で動かす | ○ Inkling・Inkling-Small | ほかのオープンウェイトモデル |
全二重の音声AIを今すぐ試す | × | GPT-Live、Gemini 3.8 Live |
音声AIをAPIで自社サービスに組み込む | × | GPT-realtime-2、Gemini 3.8 LiveのAPI |
日本語の会話AIをすぐ使う | × | ChatGPT、Gemini、Claude など |
Tinkerがおすすめな人
- AI研究者・大学院生: GPUを用意せずに、強化学習などの実験を回したい
- MLエンジニアのいる企業: オープンウェイトモデルを社内データで調整し、自社製品に組み込みたい
- 大きなMoEモデルを試したいチーム: InklingやQwen3.5-397Bなど、自前では動かしにくい規模のモデルを学習したい
- OpenAI・Anthropic形式のコードを持つチーム: 互換APIで推論部分の書き換えを小さくしたい(ベータ)
Inklingがおすすめな人
- 重みを手元に置いて、自社の環境でLLMを動かしたい企業
- Apache 2.0の商用利用しやすいライセンスを重視する開発者
- テキストに加えて画像・音声の入力を扱うアプリを作りたい人
インタラクションモデルを待つ価値がある人(一般公開された場合)
- 映像を見ながら話すサポートや遠隔の作業支援を作りたい企業
- 語学学習や家庭教師など、相づちや割り込みが大事な会話サービスを作る人
- 時間に合わせて話す機能(タイマー、運動の回数の読み上げなど)が必要な人
おすすめしない人
- 今すぐリアルタイム音声AIを使いたい人: インタラクションモデルは使えません。GPT-LiveやGemini 3.8 Liveを選ぶほうが早いです
- プログラミングをせずにAIを使いたい人: Tinkerはコードを書く前提の道具です
- 日本語のサポートが必要な人: 公式の情報・サポートは英語のみです
- 第三者認証の取得が導入の条件になっている企業: SOC 2などの取得状況が確認できていません
- 予算を固定したい人: 従量課金で、期間限定割引の終了日も未定です
今後の注目点(2026年末〜2027年)
- インタラクションモデルの公開: 「年内に広く公開」という5月時点の予定どおりになるか。API・料金・対応言語も発表されるか
- 大型のインタラクションモデル: 公式は、より大きなモデルを年内に予定するとしていました。ただし、今の大きな事前学習モデルはこの用途で提供するには遅すぎる、とも書いています
- 資金調達の完了: 評価額400億ドル以上の交渉がまとまるか。調達額は報道で10億ドルから50〜60億ドルまで幅があります
- 計算基盤の拡大: NVIDIA Vera Rubinの展開は2027年初めの予定。大きなモデルの学習がそこから本格化する見込みです
人材の流出も引き続き注目点です。創業メンバー6人のうち4人が離れたことは、報道でもたびたび取り上げられています。
よくある質問(FAQ)
Q. TMLのインタラクションモデルは日本語で話せますか?
A. 2026年10月時点で、公式は対応言語を明らかにしていません。公式ブログのデモや評価は英語が中心です。日本語で使いたい場合は、一般公開時の発表を待つ必要があります。
Q. Tinkerは個人でも登録できますか?
A. 2025年12月にウェイトリストがなくなり、一般提供になっています。企業でなくても登録できますが、Pythonで学習ループを書けることが前提です。支払い方法の詳細は公式で確認してください。
Q. TMLの株は買えますか?
A. 買えません。TMLは非上場の公益法人型の株式会社(Public Benefit Corporation)で、株主はベンチャーキャピタルや事業会社などに限られています。
Q. 1980年代のスーパーコンピューター企業「Thinking Machines Corporation」と関係はありますか?
A. 同じ名前のスーパーコンピューター企業が1980年代に米国にありましたが、TMLとのつながりは公式には説明されていません。別の会社として考えるのが無難です。
Q. GPT-LiveとTMLのインタラクションモデルは、どちらが優れていますか?
A. 同じ条件で比べた公開データがないため、判断できません。TMLのベンチマークは2026年5月時点のGPT-realtime-2.0などが相手で、GPT-Liveは入っていません。現実には、使えるかどうか(GPT-Liveは提供中、TMLは研究プレビュー)が大きな差です。
Q. Inklingを使うのにTinkerは必須ですか?
A. 必須ではありません。重みはHugging Faceから無料で入手でき、Together AIやFireworksなどのAPIでも使えます。Tinkerが必要になるのは、Inklingを自分のデータで追加学習したいときです。
まとめ
Thinking Machines Labは、元OpenAI CTOのMira Muratiが2025年2月に設立したAI企業です。2026年10月時点の要点は次のとおりです。
- Tinker: オープンウェイトモデルを追加学習するAPI。一般提供中で、従量課金。Inklingなど★印のモデルは期間限定で50%オフ。2026年10月に企業向け機能とフルファインチューニング(ベータ)が加わった
- Inkling・Inkling-Small: 2026年7月に公開した自社のオープンウェイトLLM。Apache 2.0で重みは無料
- インタラクションモデル: 0.40秒のターン交代を示した全二重のリアルタイムAI。ただし研究プレビューのままで、API・料金・日本語対応は未発表
- ベンチマーク: 遅延と全二重のやりとりでは強いが、推論や指示への従いやすさでは他社が上の項目もある。すべて自社測定で、比較相手は5月時点のモデル
- 会社: 正式な調達はシード(評価額120億ドル)が最後。400億ドル以上での交渉が報じられているが未完了。創業メンバーで残るのはMuratiとSchulmanの2人
全二重の音声AIは、GPT-LiveやGemini 3.8 Liveの登場で、もうTMLだけのものではなくなりました。いまTMLを使うなら、TinkerとInklingでオープンウェイトモデルを自分たち用に追加学習する用途が中心になります。インタラクションモデルは、一般公開の発表を待ってから評価するのが現実的です。
ほかの生成AIツールと比べて検討したい方は、生成AIツールおすすめ比較も参考にしてください。
依頼範囲と費用の目安を30分で整理します
この記事の著者

AI革命
編集部
AI革命株式会社の編集部です。最新のAI技術動向から実践的な導入事例まで、企業のデジタル変革に役立つ情報をお届けしています。豊富な経験と専門知識を活かし、読者の皆様にとって価値のあるコンテンツを制作しています。
最新記事
Sakana AI App(仮)とは?初のモバイルアプリのテスター募集(11/15まで)と応募の注意点
2026/11/09
新Siriは有料化される?Tim Cook氏が示唆したiCloud+課金・無料で使える範囲・iOS 27での提供時期【2026年11月最新】
2026/10/06
B2B発注ポータル(BtoB受発注サイト)の開発|取引先専用の発注サイトで決める価格・権限・受注後の業務
2026/10/10
PHP2Shell脆弱性(CVE-2026-109618)とは?PHP RCEの修正版と対策・悪用状況
2026/10/22
Anthropic目論見書(S-1)の中身|2025年純損失420億ドル・営業損失81億ドル・支払い義務5180億→8954億ドル・リスク要因・上場時期【2026年11月】
2026/10/01
Anthropicが法人顧客に情報閲覧を通知|見られた情報・対象外の情報・管理者が今やること
2026/11/09

