
Sarashina3とは?SB Intuitions開発の国産LLMの6モデル・性能・料金・無料ベータ・tsuzumi比較を整理【2026年最新】
この記事のポイント
Sarashina3は、SB Intuitionsがフルスクラッチで開発した国産LLMシリーズで、2026年10月13日から無料ベータでチャットとAPI(6モデル)を試せます。mini/nano/guard/embedding/rerank/translateの役割、30兆トークン学習の性能、無料ベータとCloud PF Type Aの料金・データの扱いの違い、Sarashina2・tsuzumi 2との比較をまとめました。
Sarashina3(さらしな3)は、ソフトバンク子会社のSB Intuitionsがフルスクラッチで開発した国産LLM(大規模言語モデル)シリーズです。2026年10月27日時点ではmini・nano・guard・embedding・rerank・translateの6モデルがあり、10月13日に始まった無償ベータ「Sarashinaサービス」なら、GoogleアカウントでログインするだけでチャットとAPIを無料で試せます。
2026年6月30日の提供開始時は、ソフトバンクの法人向けクラウド「Cloud PF Type A」で使う有償サービスだけでした。その後、7月に翻訳モデルのtranslateが加わり、10月に無償ベータが公開されています。ただし無償ベータと法人向けの有償サービスとでは、入力したデータを学習に使うかどうかが違います。業務で使う前に、この違いは必ず確かめてください。
内容は、SB Intuitionsの公式ブログ・APIドキュメント・利用規約と、ソフトバンクの公式発表をもとにしています。主な読者として、社内でのLLM導入やRAG(社内文書を検索して答えるしくみ)の構築、データを国内に置く要件への対応を検討している情報システム・DX推進の担当者を想定しています。国産LLMを手元で試してみたい開発者にも役立つ内容です。 生成AIそのものの基本から知りたい方は、生成AIとは何かの解説記事もあわせてご覧ください。
Sarashina3とは:基本情報と海外製LLMとの違い

Sarashina3は、文章の生成から安全性の判定、文書検索(RAG)、翻訳までを、用途別の6モデルで受け持つ国産LLMシリーズです。チャットモデルが1つあるだけの製品ではなく、業務システムに組み込む部品をひとそろい用意しているところに特徴があります。
項目 | 内容(2026年10月27日時点) |
|---|---|
名称 | Sarashina3(さらしな3)シリーズ |
開発元 | SB Intuitions株式会社(ソフトバンク子会社) |
種別 | フルスクラッチで開発した国産LLM(第3世代) |
モデル構成 | mini / nano / guard / embedding / rerank / translate の6モデル |
学習データ | 日本語・英語を中心に約30兆(30T)トークン |
最大入力 | mini・nano 128kトークン、guard 64kトークン、embedding・rerank 8,000トークン、translate 5,000文字 |
公開されていない情報 | パラメータ数、アーキテクチャ、モデルの重み、ライセンス |
提供経路① | Sarashinaサービス(無償ベータ):2026年10月13日開始、チャット+API(6モデル) |
提供経路② | Cloud PF Type A 生成AIサービス(法人向け有償):2026年6月30日開始(東日本)、5モデル |
出典: SB Intuitions TECH BLOG(2026年6月30日)、Sarashina API ドキュメント、SB Intuitions プレスリリース(2026年10月13日)
「フルスクラッチ開発」とは、海外の既存モデルを土台にして調整するのではなく、事前学習の段階から自社で作ったという意味です。日本語向けに作り込んだ設計と、データを国内で扱える提供体制の2点が、海外製の汎用LLMとの大きな違いです。
前世代のSarashina2は、モデルの重みをHugging Faceで公開するオープン路線でした。Sarashina3は重みを公開せず、APIとクラウドで提供する形に変わっています。そのため、Sarashina3を自社のサーバーやPCで動かすことはできません。手元で動かせる国産モデルが必要な場合は、重みが公開されている前世代のSarashina2.2系か、LLM-jp-4などが候補になります。
Sarashina3の6モデル構成:mini/nano/guard/embedding/rerank/translateの役割
出典: Sarashina 公式サイト
Sarashina3の6モデルは、生成・軽量処理・安全判定・ベクトル化・並べ替え・翻訳という作業ごとに分かれています。組み合わせれば、社内文書を使う回答システムを1つのシリーズでまとめて組めます。
6モデル早見表
モデル(APIのモデルID) | 種類 | 主な役割 | 向いている用途 | 最大入力 | 無償ベータの上限(1分あたり) | Cloud PF Type A |
|---|---|---|---|---|---|---|
mini(sarashina3-mini) | チャット(標準) | 対話・文章生成、ツール呼び出し、指示追従、数学・コーディング | 問い合わせ対応、複数の手順がある業務の自動化 | 128kトークン | 6回 | 共有型/専有型 |
nano(sarashina3-nano) | チャット(軽量) | 速く、大量にさばく | 要約・情報抽出・分類・タグ付け | 128kトークン | 60回 | 共有型/専有型 |
guard(sarashina3-guard) | 安全性の判定 | 入力・出力テキストの有害性を12分類で判定(文章は生成しない) | 入力プロンプトとAIの回答のチェック | 64kトークン | 6回 | 共有型 |
embedding(sarashina3-embedding) | 埋め込み | テキストを1536次元のベクトルに変換(次元は減らせる) | RAGの候補検索、類似文書の検索 | 8,000トークン(1回に1テキスト) | 60回 | 共有型 |
rerank(sarashina3-rerank) | 並べ替え | 質問と文書の関連度を点数化(指示を付けられる) | RAGの検索結果を並べ直す | 8,000トークン(候補1〜20件) | 60回 | 共有型 |
translate(sarashina3-translate) | 翻訳 | 日本語→英語、英語→日本語 | 社内文書・メールの翻訳 | 5,000文字 | 6回 | 掲載なし |
出典: Sarashina API ドキュメント・レート制限、ソフトバンク 生成AIサービス(Sarashina API)、AI Watch(2026年6月30日)。上限の値は変わることがあると公式に注記されています。
mini:主力の標準モデル
miniは性能と速さのつり合いを取った標準モデルで、対話や文章生成のほか、外部のツールを呼び出す使い方(エージェント)に対応しています。公式ブログによると、複数のツールを並行して呼んだり、何段階かに分けて呼んだりする処理も学習させています。
注意点は、miniが長く考えてから答える推論(reasoning)型ではないことです。考える過程を挟まずにすぐ答えるInstructモデルとして作られています。公式ブログ自身も「エージェントとしての能力は、推論モデルが広まった後に期待される水準にまだ届いていない」と書いています。エージェントの考え方はAIエージェントとは何かの解説にまとめています。
nano:定型処理を速く大量にこなす軽量モデル
nanoは、要約・抽出・分類のように答え方がほぼ決まっている作業を大量に流すための軽量モデルです。無償ベータの上限はminiの10倍にあたる1分60回で、たくさんのデータを順に処理する用途に合っています。凝った文章を書かせる場面より、件数の多い作業を短時間で片づける場面に向いています。
guard:入力と出力をチェックする安全判定モデル
guardは、会話の最後の発言が「安全」か「有害」かを判定し、有害なら性的な表現・個人情報の漏えい・違法行為の助長など12分類のどれに当たるかを返すモデルです。文章は生成しません。利用者の入力と、AIが返す回答の両方をチェックできるので、生成AIを業務に組み込むときの安全装置として使えます。
embedding:RAGの検索を支えるベクトル化モデル
embeddingは文章を数値の並び(ベクトル)に変え、意味の近い文書を探せるようにするモデルです。標準は1536次元で、次元を減らしても精度を保ちやすい作りになっています。そのため、ベクトルを保存するデータベースの容量や検索時間を節約できます。APIでは「検索される文書」「検索に使う質問文」などの用途(task_type)の指定が必須で、1回のリクエストで送れるテキストは1件です。
rerank:検索結果を質問に合う順に並べ直す
rerankは、embeddingで集めた候補(最大20件)に質問との関連度の点数を付け、並べ直すモデルです。一般検索・質問応答・ニュース検索などの指示を選べるほか、日本語で自由に指示を書くこともできます。embeddingと組み合わせると、RAGで使う資料を選ぶ精度が上がります。RAGのしくみはRAGの基本の解説をご覧ください。
translate:日英・英日に絞った翻訳モデル
translateは2026年7月14日に公表された、6番目のモデルです。対応するのは日本語と英語の相互翻訳だけで、APIでsource_langとtarget_langにjaかenを指定して使います。1回に送れるのは5,000文字までです。なお、2026年10月27日時点でソフトバンクのCloud PF Type Aのページにtranslateは載っておらず、使えるのは無償ベータのAPIだけです。
RAGを本格的に運用するなら、embeddingで候補を集め、rerankで絞り込み、miniで回答を作り、guardで安全性を確認する、という4モデルの連携が基本の構成になります。英語の資料も扱うなら、translateを加えて英語の文書を日本語に直してから回答させる組み方もあります。
Sarashina3でできること:3つの技術的な強み
Sarashina3の強みは、大量の学習データ、日本語を少ないトークン数で表せること、日本語の書きぶりの作り込みの3点にまとめられます。ここでは公式ブログの説明を、専門用語をなるべく使わずに整理します。
1. 約30兆トークンの高品質データで事前学習
mini・nanoは、日本語・英語を中心に約30兆(30T)トークンのデータで事前学習しています。量を増やすだけでなく、独自の基準でデータをふるいにかけ、足りない種類のデータは合成し、学習の段階ごとにデータの配合を変える「カリキュラム学習」も取り入れています。トークンとはAIが文章を扱うときの単位で、日本語ではおおむね1文字〜数文字が1トークンになります。
2. 同じ日本語を少ないトークン数で表せる
2026年8月7日の公式ブログでは、日本語版Wikipedia全体(約19億文字)をトークンに分けた結果が公開されています。
モデル | 日本語版Wikipedia全体のトークン数 |
|---|---|
Sarashina3 | 約9.5億トークン |
Gemini 3.5 | 約12億トークン |
GPT-5(o200k_base) | 約14億トークン |
出典: SB Intuitions TECH BLOG「トークナイズとトークン効率」(2026年8月7日)
「東京メトロ」や「山手線」のような固有名詞も1トークンで表せます。同じ文章を少ないトークン数で表せれば、トークン単位の従量課金でも、一度に読ませられる文章の長さでも有利になりやすくなります。ただし、Sarashina3の有償プランの単価は公開されていないため、金額で比べることはまだできません。API料金を抑える考え方は生成AIのAPI利用料を削減する方法で解説しています。
3. 多段階の強化学習と、日本語の書きぶりの人手評価
事前学習のあとには、何段階かに分けた強化学習を行っています。能力を1つずつ鍛える段階と、複数の能力をまとめて鍛える段階を組み合わせたものです。さらに、モデル自身が生成した結果から学び直すOPSD(on-policy self-distillation、自己蒸留)という手法も使っています。
あわせて、社内のチームが出力を「自然さ・丁寧さ・簡潔さ・実用性」の4つの観点で評価し、その結果を学習に反映しています。点数を上げることだけでなく、仕事で読んで違和感のない日本語に近づけることも目標にしています。
Sarashina3の日本語性能:ベンチマークで示された実力
出典: SB Intuitions TECH BLOG「Sarashina3 mini / Sarashina3 nano」
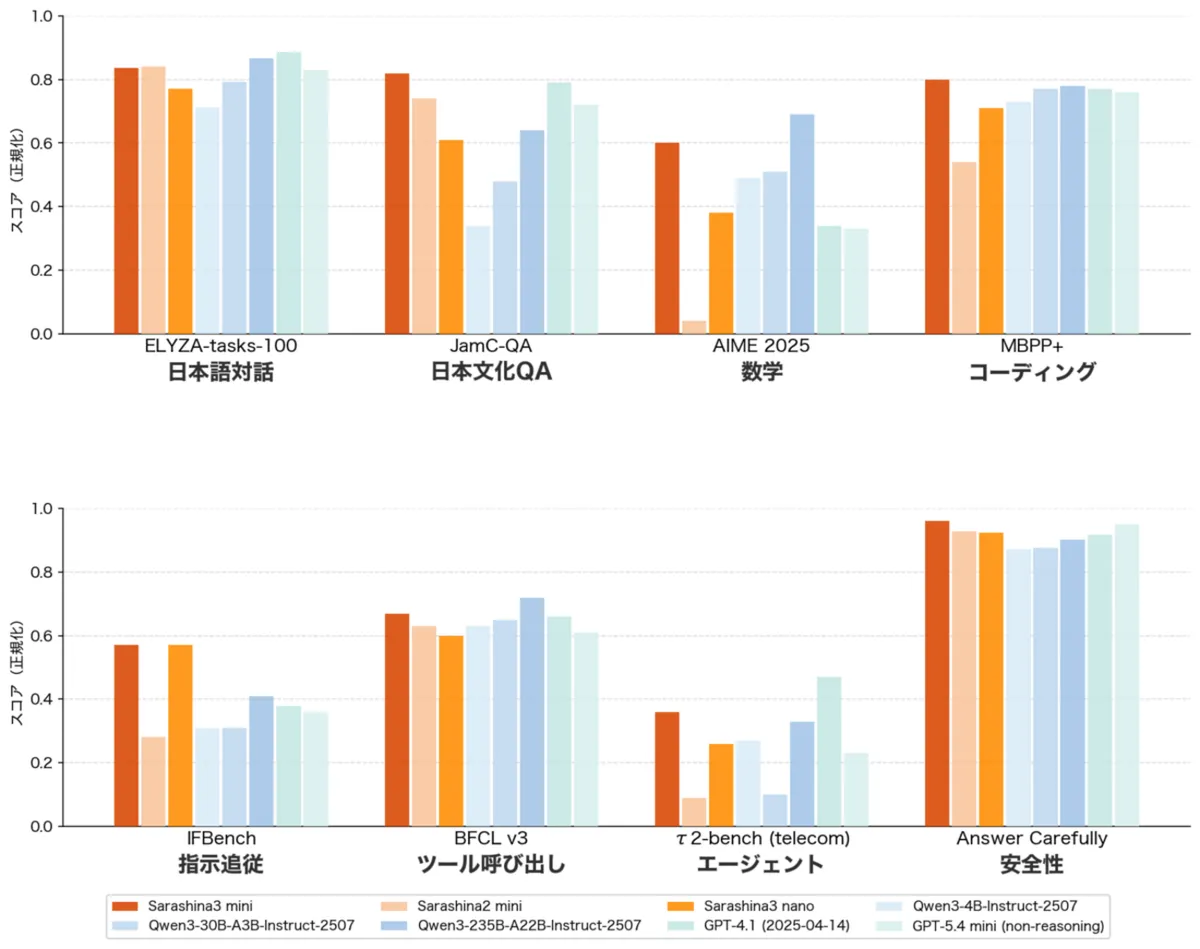
mini・nanoは、公式のベンチマークで前世代を大きく上回り、海外の比較モデルともおおむね同じ水準にあります。日本語の知識を問うJamC-QAでは、比較したモデルを上回りました。ただし、結果はすべてSB Intuitionsが自社で測ったものです。mini・nanoのスコアは0〜1に換算したグラフでしか示されておらず、元の点数は本文に載っていません。
mini/nanoの評価に使われた主なベンチマーク
ベンチマーク | 測る能力 | 公式ブログで示された結果(要約) |
|---|---|---|
ELYZA-tasks-100 | 日本語の対話・作業をこなす力 | 比較モデルとおおむね同じ水準 |
JamC-QA | 日本の文化・知識に関する質問応答 | 比較したモデルを上回る |
AIME 2025 | 数学(難問) | Sarashina2 miniから大きく向上 |
MBPP+ | コーディング | Sarashina2 miniから大きく向上 |
IFBench | 指示どおりに答える力 | Sarashina2 miniから大きく向上 |
BFCL v3 | ツール(関数)呼び出し | GPT-4.1と同じ水準 |
τ²-bench Telecom | エージェントとしての顧客対応 | Qwen3-235B-A22Bと同じかそれ以上 |
Answer Carefully | 安全性 | 比較モデルより高い |
比較したモデルは、Qwen3-4B・30B-A3B・235B-A22B(いずれもInstruct-2507)、GPT-4.1、GPT-5.4 mini(推論なし)、前世代のSarashina2 miniです。nanoは、日本語性能などでQwen3-4B-Instruct-2507を上回ったと報告されています。
embedding:Sarashina2 embeddingより少ない次元で同じ水準
embeddingは、日本語の埋め込み性能を測るJMTEB(v1.4.0)の数値が公開されています。
モデル | 次元数 | JMTEB平均 |
|---|---|---|
Sarashina2 embedding(前世代) | 2560 | 78.69 |
Sarashina3 embedding | 1536 | 78.22 |
Sarashina3 embedding(256次元に縮小) | 256 | 75.72 |
sarashina-embedding-v2-1b | 1792 | 76.38 |
ruri-v3-310m | 768 | 75.85 |
plamo-embedding-1b | 2048 | 74.85 |
出典: SB Intuitions TECH BLOG(2026年7月2日)
平均点だけを見ると、前世代のSarashina2 embedding(78.69)をわずかに下回っています。一方で次元数は2560から1536に、約40%減りました。「次元を減らしても、ほぼ同じ精度を保った」と受け取るのが正確です。256次元まで減らしても、公開モデルのruri-v3-310mと同じくらいの平均点が出ます。分野別の内訳は、分類79.15、クラスタリング51.56、文の類似度83.57、検索79.3、並べ替え88.4です。
rerank:公開モデルとほぼ同じ水準で、最高値ではない
モデル | JMTEB 5タスクの平均 |
|---|---|
ruri-v3-reranker-310m | 93.56 |
Sarashina3 rerank | 93.08 |
japanese-bge-reranker-v2-m3-v1 | 88.97 |
bge-reranker-v2-m3 | 88.51 |
出典: SB Intuitions TECH BLOG(2026年7月3日)
平均点は、公開モデルのruri-v3-reranker-310mをわずかに下回りました。5つのタスクのうち、商品検索のESCIだけは最も高い点数です。公式ブログの著者も「公開ベンチマークでは差が小さいので参考程度に。自社のデータで評価を」と書いています。
guard:海外の安全判定モデルより高いF1
モデル | F1(SB Intuitionsの日本語テストセット) |
|---|---|
Sarashina3 guard | 68.1(入力71.2 / 出力65.0) |
gpt-oss-safeguard-120b(medium) | 65.9 |
Qwen3Guard-Gen-8B | 64.4 |
Llama-Guard-3-8B | 50.7 |
出典: SB Intuitions TECH BLOG(2026年7月1日)
処理時間は1件あたり3.83ミリ秒です。より小さいQwen3Guard-Gen-0.6B(1.46ミリ秒)のほうが速いものの、判定の精度は日本語に合わせて作ったguardが高い結果になっています。ただし、テストセットもSB Intuitionsが作ったものです。
translate:英→日はGoogle翻訳に勝ち越し、日→英は負け越し
社内の5人がGoogle Cloud Translation(Advanced)の訳と1件ずつ比べた結果、英語→日本語は236勝213敗21分で勝ち越し、日本語→英語は199勝214敗77分で負け越しました。自動評価の指標では、BLEUとchrFはGoogleが上回り、COMETとGEMBA-MQMはほぼ同じでした(公式ブログ 2026年7月14日)。英語の資料を日本語で読む用途のほうが向いているといえます。
ここで挙げたベンチマークは、いずれもSB Intuitionsが自社で測定・公表した値です。第三者による検証ではないので、導入を決める前に自社のデータで試してください。
Sarashina3の料金・提供形態:無料ベータとCloud PF Type A

出典: Oracle Cloud Infrastructure 公式サイト
Sarashina3を使う経路は2つあります。SB Intuitionsの無償ベータ「Sarashinaサービス」は無料で、ソフトバンクの法人向け「Cloud PF Type A 生成AIサービス」は有償の見積もり制です。 2つの経路では、使えるモデルの数とデータの扱いも違います。
無償ベータとCloud PF Type Aの違い
項目 | Sarashinaサービス(無償ベータ) | Cloud PF Type A 生成AIサービス(法人向け有償) |
|---|---|---|
提供元 | SB Intuitions | ソフトバンク |
開始日 | 2026年10月13日 | 2026年6月30日(東日本リージョン) |
料金 | 無料(ベータの終了時期は未定) | 共有型=100万トークン単位の従量課金、専有型=月額固定。いずれも金額は非公開で見積もり |
使えるモデル | 6モデル(translateを含む) | 5モデル(translateの掲載なし)。専有型はmini・nanoのみ |
使い方 | ブラウザのチャット(対話・Web検索・文章作成・日英翻訳)とAPI | Playground、API・SDK、Oracle Database・Object Storageとの連携 |
利用できる人 | 日本国内に住む個人、日本国内に本店がある法人 | 法人契約 |
入力データの学習利用 | 入力・出力を学習やサービス開発に使うことがある。学習を止める設定(オプトアウト)は有償プランのみ | 入力・生成結果をモデルの再学習に使わない。データとログは国内のデータセンターに保管し、海外へ移さない |
利用の上限 | 1分あたりの回数制限あり(mini 6回、nano 60回など) | 契約の条件による |
向いている用途 | 個人・開発者の試用、PoC前の技術検証(機密データは不可) | 本番運用、機密データ、データを国内に置く要件がある業務 |
出典: SB Intuitions プレスリリース(2026年10月13日)、Sarashina 利用規約、ソフトバンク 生成AIサービス(Sarashina API)
Cloud PF Type Aの共有型と専有型
形態 | しくみ | 課金方式 | 主な用途 | 対応モデル |
|---|---|---|---|---|
共有型(On-Demand) | 複数の利用者でGPUを共有(論理的に分離) | 100万トークン単位の従量課金 | PoC・小規模なプロジェクト | mini/nano/guard/embedding/rerank |
専有型(Dedicated) | 利用者専用のGPU | 月額固定 | 本番システム・大規模な利用 | mini/nano |
共有型は初期費用を抑えやすく、まず試したい段階に向いています。専有型は専用のGPUを確保するため、費用を見通しやすく、安定して動かしたい本番システムに向いています。ソフトバンクによると、長期契約や大規模な利用には割引があります。
料金で「分かっていること/分かっていないこと」
- 分かっていること: 無償ベータは無料。Cloud PF Type Aは、共有型が100万トークン単位の従量課金、専有型が月額固定
- 公開されていないこと: Cloud PF Type Aの円建ての単価と月額、モデルごとの価格差、無償ベータの有償プランの金額と内容、ベータが終わる時期と有償への切り替え条件
正確な費用を出すには、ソフトバンクに見積もりを依頼する必要があります。公開されていない価格は、推測で書いていません。提供基盤のしくみはCloud PF Type Aの解説記事で詳しく説明しています。
Sarashina3の使い方と提供環境:ソブリン性が最大の訴求点
出典: ソフトバンク 公式サイト
手軽に試すなら無償ベータ、本番で使うならCloud PF Type A、と分けて考えるのが基本です。 法人向けの経路では、データを国内で管理する「ソブリン性(データ主権)」がいちばんの売りです。
無償ベータの始め方(要点)
- sarashina.aiを開き、Googleアカウントでログインする(事前の申し込みは不要)
- ブラウザのチャット画面で、対話・Web検索・文章作成・日英翻訳を試す
- APIを使う場合は、ダッシュボード(chat.sarashina.ai/dashboard/api-keys)でAPIキーを発行する
- ベースURL
https://api.sarashina.ai/v1に、Authorization: Bearer <APIキー>を付けてリクエストを送る
エンドポイントは、mini・nano・guardが/v1/chat/completions、embeddingが/v1/embeddings、rerankが/v1/rerank、translateが/v1/translateです。APIキーはサーバー側だけで使い、ブラウザやアプリの中には書き込まないでください。ログイン画面やコード例を含む詳しい手順は、Sarashina無料ベータ版の始め方にまとめています。
APIを使うときにつまずきやすい点
- 「OpenAI互換」とは公式に書かれていない: 公開されている検証記事によると、OpenAIのSDKで接続先を差し替えればチャットと埋め込みは呼べます。ただし
max_tokens(max_completion_tokensを使う)、logprobs、複数テキストをまとめた入力、task_typeの省略はエラー(400)になり、モデル一覧(GET /v1/models)は404になると報告されています - 上限を超えるとHTTP 429が返る: 回数は1分ごとに区切って数え、まとめて多く送ることはできません。公式ドキュメントでは、429のレスポンスに待ち時間(
Retry-After)を付けると書かれています。ただ、公開直後の検証では付いていなかったという報告もあるため、プログラム側にも待ってから送り直す処理を入れておくと安心です - miniは1分6回まで: 1分に6回なので、数人が同時に使う社内ツールの本番運用には足りません。本番で使うなら、Cloud PF Type Aを前提に考えるのが現実的です
- translateは機能が少ない: 検証記事によると、少しずつ結果を返すストリーミング、用語集、文体の指定には対応していません。「見送らせていただく」をpostpone(延期)と訳すなど、遠回しな断り表現の誤訳も報告されています
Cloud PF Type Aでのソブリン性
Cloud PF Type Aは、米Oracleのクラウド技術「Oracle Alloy」を使い、ソフトバンクが日本国内のデータセンターで運用するクラウドです。データとログは国内に保管されて海外へ移されず、設計上、ソフトバンクとOracleも利用者のデータにアクセスできないとされています。個人情報や機密情報を扱う金融・医療・自治体などにとっては、海外のSaaS型LLMでは満たしにくい要件に対応できる点が利点です。
2026年9月30日には、Cloud PF Type Aの西日本リージョンが提供を始めました。ただし、Sarashinaについては「順次提供」とされており、2026年10月27日時点で、西日本で使い始められる日と対象モデルは公式に示されていません(ソフトバンク 2026年9月30日発表)。また、2026年12月からは、IPAの「暗号鍵管理ガイドライン」に沿った鍵管理サービス(KMS)を提供する予定です。
自社の業務システムに組み込む場合
Sarashina3を社内の文書検索や問い合わせ対応のシステムに組み込むなら、モデルの利用料に加えて、文書の取り込み・権限管理・画面・運用監視などの開発費用がかかります。新しいモデルを業務システムに組み込むときの進め方と費用の目安は、AI開発の費用相場(AI受託開発の改修・PoC・本開発の価格と見積の内訳)で整理しています。
Sarashina3のセキュリティとデータの扱い
無償ベータでは入力と出力が学習に使われることがあり、無料のままでは止められない点がいちばん大事です。 社内文書・顧客情報・公開前の情報は、無償ベータに入れないでください。
無償ベータの利用規約で押さえる点
規約の項目 | 内容(2026年10月27日時点の利用規約) |
|---|---|
学習への利用(第9条4項・第11条2項) | 入力・出力を、モデルの学習や新しいサービスの開発に使うことがある |
学習の停止(第11条3項) | 有償プランだけで選べる。対象になるのは設定した後の入力だけで、それ以前の分はさかのぼって除外されない |
入力してはいけない情報(第10条) | 個人を特定できる情報 |
禁止されている使い方(第10条) | 出力を医療・法律・金融の助言として使うこと、競合サービスの開発、出力の自動収集、複数アカウントで制限を逃れること、プロンプトインジェクション攻撃 |
知的財産(第9条3項) | 入力・出力の知的財産は、原則として利用者に帰属する |
商用利用 | 規約に明記されていない。業務で使う場合は規約を確認し、必要なら問い合わせる |
規約の変更・停止(第6条・第15条) | 規約の変更は14日前に通知される。事前の通知なしにサービスが止まることもある |
年齢(第3条) | 18歳未満は保護者の同意が必要 |
出典: Sarashina 利用規約
一方、Cloud PF Type Aの生成AIサービスは、入力と生成結果を再学習に使わないと明記しています。インターネットを通らない閉じた経路で接続するPrivate Endpointや、IAMによる権限管理にも対応しています。
guardが判定する12分類
コード | 分類 | コード | 分類 |
|---|---|---|---|
T1 | 性的な表現 | T7 | 組織・政府の情報漏えい |
T2 | 暴力的な描写 | T8 | 違法行為の助長 |
T3 | 固定観念・差別 | T9 | 非倫理的・危険な行為の助長 |
T4 | 有害な表現 | T10 | 悪意ある情報拡散の助長 |
T5 | AIへの過度な依存 | T11 | 専門分野での重大なリスク |
T6 | 個人情報の漏えい | T12 | 虚偽・誤解を招く情報の助長 |
guardを使えば、社内の情報や個人情報が回答に含まれていないかを自動でチェックできます。ただし、公式ブログでも誤検知や見逃しはありうると書かれています。重要な用途では、guardだけに任せず人による確認も組み合わせてください。
Sarashina2・tsuzumi 2・PLaMo 3.0 Primeとの違い

出典: NTT R&D Website
Sarashina3の特徴は、生成・RAG・安全判定・翻訳を6つのモデルでそろえ、無料で試す経路と国内で本番運用する経路の両方を持っていることです。 手元で動かしたいならSarashina2系、軽いモデルを自社環境で動かしたいならtsuzumi 2、長い文書をまとめて読ませたいならPLaMo 3.0 Primeが候補になります。
項目 | Sarashina3(SB Intuitions) | Sarashina2系(前世代) | tsuzumi 2(NTT) | PLaMo 3.0 Prime(PFN) |
|---|---|---|---|---|
提供開始 | 2026年6月 | 2024〜2025年 | 2025年10月 | 2026年6月(正式リリース) |
規模・仕様 | 学習データ約30兆トークン、パラメータ数は非公表 | 8x70B(MoE)、2.2系の0.5B〜3Bなど | 300億(30B)パラメータ、GPU1枚で動く | 256Kトークンの長いコンテキスト |
モデルの重み | 非公開 | Hugging Faceで公開(ライセンスはモデルごとに異なる) | 公開の配布物は確認できず | 公開の配布物は確認できず |
提供形態 | 無償ベータ(チャット+API)、Cloud PF Type A | 公開モデルを自社環境で動かす | 自社環境・NTTグループの環境、2026年5月からMicrosoft Foundryで従量課金(評価・検証が主な目的) | クラウドAPI |
無料で試す方法 | 無償ベータ | 重みをダウンロードする(ライセンスを確認) | 確認できず | 無料のAPIプランあり(条件は公式で確認) |
料金の公開 | 有償の単価は非公開(見積もり) | ライセンスによる | 一律の単価表は確認できず | 公式で確認 |
主な強み | RAG・安全判定・翻訳まで1つのシリーズで組める | 手元で動かせる、オフラインでも使える | 軽く、推論コストが低い | 長い文書をまとめて読ませられる |
前世代Sarashina2との違い
Sarashina2系は、総パラメータ数が大きいMoEモデルの8x70Bや、小さなSarashina2.2-0.5B〜3Bなど、モデルの重みを公開する路線でした。Sarashina2.2系にはMITライセンスで商用利用しやすいものもあり、8x70Bは非商用ライセンスです(使う前にHugging Faceで最新のライセンスを確認してください)。
Sarashina3は、重みを公開せず、用途別の6モデルをAPIとクラウドで提供する製品群に変わりました。自社のサーバーで動かしたいならSarashina2.2系、性能とRAG・安全判定の部品がそろっていることを重視するならSarashina3、と選び分けられます。
なお、デジタル庁の行政向け生成AI基盤「源内」で2026年3月に選ばれた国産LLM7件に入ったのは、報道によるとSarashina3ではなく前世代のSarashina2 miniです。源内のくわしい内容はガバメントAI「源内」の解説をご覧ください。
NTT「tsuzumi 2」との違い
tsuzumi 2は300億パラメータで、GPU1枚で動くほど軽く、推論にかかる費用を抑えやすいことが強みです。源内にも選ばれています。2026年5月20日からはMicrosoft Foundry(Azure Marketplace)で従量課金でも使えるようになりましたが、NTTデータによると、これは主に評価・検証向けです。商用や機密を扱う用途では、NTTデータのプライベート環境を使う前提になっています(NTTデータ発表)。
自社の環境で軽いモデルを動かしたいならtsuzumi 2、無料で試してから、RAGや安全判定の部品とまとめてクラウドで運用したいならSarashina3、という選び方が目安になります。
PFN「PLaMo 3.0 Prime」との違い
PLaMo 3.0 Primeは、256Kトークンという長いコンテキストが特徴で、長い文書をまとめて読ませる用途に強みがあります。推論するモデルとしないモデルの2系統を用意している点も、推論型のないSarashina3 mini・nanoとの違いです。長く考えさせる国産モデルを探しているなら、ELYZA-Thinking-1.0も候補になります。
国産LLM全体を並べて比べたい場合は、国産LLM 7選の徹底比較もあわせて読むと、自社の要件に合うモデルを絞り込みやすくなります。
Sarashina3がおすすめの企業・おすすめしない企業
Sarashina3は「まず無料で日本語の品質を確かめ、本番は国内のクラウドで動かしたい企業」に向いています。一方、無料のまま機密データで本番運用したい場合や、自社のサーバーで動かしたい場合には向きません。
用途別のおすすめ経路
やりたいこと | おすすめの経路 | 理由 |
|---|---|---|
個人で日本語のチャットAIを試したい | 無償ベータ(チャット) | 無料で、Googleアカウントだけで始められる |
開発者がAPIの動きを確かめたい | 無償ベータ(API) | 6モデルすべてを無料で呼べる |
社内文書を使ったRAGのPoC | 公開資料やサンプルなら無償ベータ。社内文書ならCloud PF Type A | 無償ベータは入力が学習に使われることがある |
機密データを扱う本番運用 | Cloud PF Type A(共有型→専有型) | 再学習に使わず、データは国内で保管される |
自社サーバーやオフラインで動かしたい | Sarashina2.2系など、重みが公開されたモデル | Sarashina3は重みが公開されていない |
長く考える推論が必要 | 推論型のモデル(PLaMo 3.0 Prime、ELYZA-Thinkingなど) | Sarashina3 mini・nanoは推論型ではない |
こんな企業・人におすすめ
- 金融・医療・自治体など、データを国外に出せない組織: Cloud PF Type Aはデータを国内で保管し、再学習にも使わない
- 社内文書を使うRAGを本格的に作りたい企業: embedding・rerank・mini・guardを同じシリーズでそろえられる
- 安全性やコンプライアンスを重視する企業: guardで入力と出力のチェックを仕組みにできる
- 日本語の固有名詞が多い文章を大量に扱う企業: トークン数が少なく、nanoで大量処理もできる
- 国産LLMを無料で試してから導入を決めたい開発者・担当者: 無償ベータで6モデルを比べられる
おすすめしない人・慎重に検討したいケース
- 無料のまま社内データで本番運用したい人: 無償ベータは入力が学習に使われることがあり、miniは1分6回までしか使えない
- すぐに正確な費用を出したい場合: 有償プランの単価が公開されておらず、見積もりが必要
- 長く考える推論型の最新モデルが必要な人: mini・nanoは推論型ではない
- 自社サーバーやオフラインで動かしたい人: Sarashina3は重みが公開されていない
- 西日本リージョンでの本番運用をすぐ始めたい場合: 西日本でSarashinaが使える開始日は公表されていない
- 日本語→英語の翻訳品質を最優先する人: 公式の比較でも、日→英はGoogle翻訳に負け越している
よくある質問(FAQ)
Q. Sarashina3は無料で使えますか?
使えます。2026年10月13日に始まった無償ベータ「Sarashinaサービス」では、チャットとAPI(6モデル)が無料です。ただし、ベータがいつ終わるか、その後どんな有償プランになるかはまだ発表されていません。法人向けのCloud PF Type Aは有償で、料金は見積もり制です。
Q. Sarashina3は会社の仕事で使っても大丈夫ですか?
無償ベータの規約には、商用利用ができるかどうかがはっきり書かれていません。さらに、入力が学習に使われることがあり、個人を特定できる情報は入力が禁止されています。公開してよい資料で試すまでにとどめ、社内データを扱うならCloud PF Type Aを検討するのが安全です。
Q. パラメータ数は公開されていますか?Hugging Faceからダウンロードできますか?
どちらもできません。2026年10月27日時点で、mini・nanoのパラメータ数、アーキテクチャ、重み、ライセンスは公開されていません。公開されている仕様は、最大入力の長さ(mini・nano 128kトークンなど)とembeddingの次元数です。Hugging FaceのSB Intuitionsのページで公開されているのは、Sarashina2.2系などの前世代モデルです。
Q. OpenAIのSDKやLangChainからそのまま呼べますか?
公式は「OpenAI互換」とは書いていません。検証記事によると、接続先のURLを差し替えればチャットと埋め込みは動きますが、一部のパラメータはエラーになります。既存のコードを使い回すときは、パラメータ名と1回に送る件数を合わせて調整する必要があります。
Q. Sarashina3はデジタル庁の「源内」に採用されていますか?
報道によると、2026年3月に源内で選ばれたのは前世代のSarashina2 miniで、Sarashina3ではありません。行政での採用を判断材料にする場合は、どの世代のモデルが選ばれたのかを確認してください。
Q. ChatGPTやGeminiと比べてどう使い分ければよいですか?
海外のLLMは、推論型のモデルや画像・音声に対応したモデルの選択肢が多いのが強みです。Sarashina3は、日本語を少ないトークン数で表せることと、法人向けの経路でデータを国内に置けることが強みです。データを国内に置く必要があるかどうかと、推論型のモデルが必要かどうかで決めると迷いにくくなります。
まとめ:Sarashina3は無料で試せて、国内で本番運用できる国産LLM
Sarashina3は、SB Intuitionsがフルスクラッチで開発した第3世代の国産LLMです。mini・nano・guard・embedding・rerank・translateの6モデルで、生成・大量処理・安全判定・文書検索・翻訳を1つのシリーズにまとめています。
- 約30兆トークンで事前学習。日本語版Wikipediaを約9.5億トークンで表せ、GPT-5(約14億)より少ない
- ベンチマークはJamC-QAで比較モデルを上回り、guardはF1 68.1で海外の安全判定モデルより高い。一方、embeddingとrerankは比較対象とほぼ同じ水準で、最高値ではない
- 2026年10月13日から、無償ベータでチャットとAPI(6モデル)を無料で試せる。ただし入力が学習に使われることがあり、miniは1分6回まで
- 本番運用はCloud PF Type A(5モデル)。再学習に使わず、データは国内で保管される。単価は非公開で見積もりが必要
- 重みは公開されておらず、推論型でもない。手元で動かしたいならSarashina2.2系などが候補になる
まずは無償ベータで、公開してよい資料を使って日本語の品質と応答の速さを確かめてください。そのうえで、社内データを扱う段階に進むならCloud PF Type Aの見積もりを取る、という順番が失敗しにくい進め方です。ほかの国産LLMとも比べたい場合は、国産LLMの徹底比較、NTT tsuzumi 2の解説、PLaMo 3.0 Primeの解説もあわせて確認し、自社の要件に合うモデルを選んでください。
依頼範囲と費用の目安を30分で整理します
この記事の著者

AI革命
編集部
AI革命株式会社の編集部です。最新のAI技術動向から実践的な導入事例まで、企業のデジタル変革に役立つ情報をお届けしています。豊富な経験と専門知識を活かし、読者の皆様にとって価値のあるコンテンツを制作しています。
最新記事
Siri AIの回数制限は何回?1日の上限・リセット時刻・iCloud+で最大20倍になる条件【iOS 27.3ベータ】
2026/11/17
Apple HomeViewとは?11月13日発売・299ドル・日本発売は未定|Siri AI搭載スマートホームハブの機能と評判
2026/10/14
SynthID Detectorとは?GoogleのAI生成判定サイトの使い方・OpenAI/NVIDIA製への対応・判定の限界
2026/10/10
ChatGPTの電子透かし(textGrain)とは?EU限定の仕組み・日本への影響・検出と回避の限界【2026年11月】
2026/10/12
MAI-Realtimeとは?Microsoft初の全二重音声モデル|MAI-Voice-2との違い・日本語対応・GPT-Live/Gemini Live比較【2026年11月最新】
2026/10/07
GPT-4o APIは2027年1月14日に廃止|4o mini・GPT-4.1も対象、移行先GPT-6 Lunaの料金と手順【2026年11月】
2026/10/15

