NVIDIA Nemotron 3.5 Boltとは?必要スペック・性能・使い方・Qwen3.6との違いを整理
この記事のポイント
NVIDIA Nemotron 3.5 Boltは、2bit量子化でモデル本体を24GBに収め、RTX SparkやDGX Sparkの上でAIエージェントを動かすためのオープンウェイトモデルです。実行に必要なメモリ(目安32GB以上)、Macで動くか、ベンチマーク、Ollamaでの使い方、OpenClawとの組み合わせ、Qwen3.6やGemma 4との違いをまとめました。
NVIDIA Nemotron 3.5 Boltは、NVIDIAが2026年10月15日(米国時間)に公開したオープンウェイトのAIモデルです。テキストに加えて画像も読め、2bit量子化でモデル本体を約24GBまで小さくしてあります。RTX Spark搭載PCやDGX Sparkの上で、Web調査・文章作成・コードのデバッグといったエージェント作業をクラウドに送らずに動かすことを狙っています。
ただし、24GBはモデルファイルの大きさです。実際に動かすときは作業用のメモリも要るため、公式の手順では32GB以上のメモリを積んだNVIDIA GPUを前提にしています。
この記事でわかること
- Nemotron 3.5 Boltの仕組み(74B-A9B・2bit量子化とは何か)と、2つのモデルの違い
- できること・強み・弱み(NVIDIAの公式ベンチマークと、NVIDIA以外による評価)
- 料金とライセンス(OpenMDW-1.1・商用利用)
- 自分のPCで動くかどうかの判定表(RTX Spark・DGX Spark・RTX 5090・RTX 4090・Mac)
- Ollama・LM Studio・llama.cppでの使い方と、OpenClaw・Claude Codeをローカルで動かすコマンド
- Nemotron 3.5 Lightning、Qwen3.6、Gemma 4との違い
こんな方に向けた記事です
- ローカルLLMやAIエージェントを自分のPCで動かしたい開発者・技術者
- RTX Spark搭載PCやDGX Sparkの購入・活用を考えている方
- 機密データを社外に出さずにAIを業務で使う方法を探している情報システム担当者
Nemotron 3.5 Boltの要点
ポイント | 内容 |
|---|---|
位置づけ | 「速さより賢さ」を取ったローカル向けモデル。同じくらいのメモリで動くオープンモデルの中では賢い部類に入る |
動く環境 | NVIDIA GPU(Ada Lovelace/Blackwell世代)とWindows/Linuxが前提。公式手順は32GB以上(コンテキスト64K)、48GB以上(256K)。Macは現時点で非対応 |
費用 | モデルは無料(OpenMDW-1.1、商用利用可)。NVIDIAが提供するAPIは確認できず、かかるのは機材代 |
向く人 | RTX Spark・DGX Spark・32GB以上のRTX GPUを持ち、画像を読ませるエージェントや機密データの処理をローカルで回したい人 |
向かない人 | Mac利用者、24GB以下のGPUしかない人、コーディングの精度や速度を最優先したい人 |
ローカルで動くAIエージェントの全体像はAIエージェントとはで整理しています。
NVIDIA Nemotron 3.5 Boltとは
Nemotron 3.5 Boltは、NVIDIAのオープンモデル群「Nemotron」の最新世代(3.5)のうち、PC・デスクトップで動かす用途に絞ったモデルです。同時に発表されたデータセンター向けの大型モデル「Nemotron 3.5 Super VL(120B-A12B)」を圧縮して作られています。
項目 | 内容 |
|---|---|
開発元 | NVIDIA |
正式名 | Nemotron 3.5 Bolt 74B-A9B 24GB |
公開日 | 2026年10月15日(米国時間) |
種類 | 視覚言語モデル(VLM)。テキストと画像(対応ランタイムでは動画も)を読み、テキストを出力 |
パラメータ | 総数74B(740億)、1トークンあたりに働くのは9B |
モデルの大きさ | 約24GB(Ollama版は25GB) |
コンテキスト長 | 最大256K(262,144)トークン。実際に使える長さはメモリ次第 |
ライセンス | OpenMDW-1.1(モデルカードに商用・非商用で利用可と記載) |
入手先 | Hugging Face、Ollama、LM Studio、llama.cpp、Unsloth、vLLM など |
主な対象機 | RTX Spark搭載PC、DGX Spark、DGX Station、RTX PRO ワークステーション、GeForce RTX PC |
出典: NVIDIA公式ブログ、Hugging Face モデルカード
「74B-A9B」と「2bit量子化」の意味
名前の「74B-A9B」は、全体で740億個のパラメータを持ちながら、1つの単語(トークン)を出すたびに働くのは90億個だけという意味です。
Boltは「MoE(Mixture of Experts)」という構造を採っています。得意分野の違う小さなネットワーク(エキスパート)をたくさん持ち、入力ごとに必要なものだけを呼び出す仕組みです。知識の量は大きなモデル並みに持ちつつ、計算量は小さなモデルに近く抑えられます。中身はMamba-2とTransformerを組み合わせた構成で、画像の読み取りには「C-RADIO v4-H」という視覚エンコーダーを使っています。
もう一つの特徴が2bit量子化です。通常、モデルの重みは16bitなどの数値で保存されますが、Boltはエキスパート部分の重みを約2bit(IQ2_XXS形式、1要素あたり2.0625bit)まで圧縮しています。精度が落ちやすい部分(Attention、埋め込み層など)は8bit、Mamba層はNVFP4と、部分ごとにビット数を変えています。
圧縮すると普通は性能が落ちます。そこでNVIDIAは、「Star Elastic」と呼ぶ手法で24GB未満に収まる構成を探し、圧縮で弱った画像の読み取り能力を追加学習で戻し、最後に強化学習でエージェント作業(推論・ツール実行)を鍛え直しています。量子化も、圧縮を前提にした蒸留(QAD)で行っています。
さらに、1.13Bパラメータの小さな「下書きモデル(LiLiCorr)」が次の7トークン分を先に予想し、本体がそれをまとめて確かめることで生成を速めています(投機的デコード)。下書きは平均4〜5トークンが採用されると公表されています。
出典: NVIDIA Research「Nemotron 3.5 Bolt 24GB」
Boltは2種類ある(74B-A9Bと E4B)
「Bolt」の名前が付くモデルは2つ発表されています。2026年10月20日時点で公開されているのは74B-A9Bだけです。
モデル | 得意なこと | 対応する機材(公式ブログ) | 提供時期 |
|---|---|---|---|
Bolt 74B-A9B 24GB | 賢さと速さのバランス。調べもの・コードのデバッグなど、何段階も考えるエージェント作業 | GeForce RTX PC、DGX Spark、DGX Station、RTX PRO | 2026年10月15日公開 |
Bolt E4B 4GB | メモリ1GBあたりの賢さ重視。音声アシスタント、会話キャラクター、アプリに組み込むUIなど、速く返す会話用途 | GeForce RTX、Jetson、RTX Spark、DGX Spark | 2026年10月23日公開予定 |
E4Bのベンチマークや詳しい仕様は、公開時点で改めて確認が必要です。この記事で「Bolt」と書く場合は74B-A9Bを指します。
Nemotron 3.5 Boltでできること
出典: NVIDIA Blog 公式
Nemotron 3.5 Boltは、自分のPCの中で動く「画像も読めるAIエージェントの頭脳」として使えます。NVIDIAは想定用途として、Web調査、文章作成、コードのデバッグといった日常的なエージェント作業を挙げています。
できること | 具体例 | 補足 |
|---|---|---|
文章の生成・要約・調査 | 資料の要約、レポートの下書き、Webを検索しながらの調べもの | 検索やブラウザ操作は、組み合わせるエージェントツール側の機能 |
画像の読み取り | スクリーンショット、グラフ、回路図、書類の画像を読んで説明・判断 | 入力はJPEG/PNG |
動画の読み取り | MP4動画(最大2分)の内容を要約・質問応答 | llama.cppなど対応ランタイムで利用。Ollama版はテキストと画像のみ |
ツール呼び出し | 関数やAPIを呼び出す、JSONで結果を返す | OpenAI互換APIの形式に対応 |
エージェント作業 | ターミナル操作、ファイル編集、Webブラウジング | OpenClaw・Claude Code・OpenCodeなどと組み合わせて使う |
長い資料の処理 | 最大256Kトークンの入力 | 長くするほどメモリを使う |
推論モードの切り替え | 難しい問題は考えてから答え、簡単な質問は即答 |
|
対応言語は、英語とプログラミング言語が主要で、日本語・スペイン語・フランス語・ドイツ語・イタリア語もサポート対象としてモデルカードに記載されています。日本語は「主要言語」の扱いではありません。
Nemotron 3.5 Boltの強み
強みは、同じくらいのメモリで動くモデルの中で、エージェント作業の成績が高いことです。NVIDIAは「PinchBench(エージェント作業の評価)で同クラス1位、BrowseComp(Web調査の評価)で2位のオープンモデル」としています。
公式ベンチマーク(Bolt・2bit版)
ベンチマーク | 測っているもの | スコア |
|---|---|---|
GPQA Diamond | 大学院レベルの科学知識 | 86.43 |
BrowseComp | Webを調べて答えを探す力 | 66.75 |
AA-LCR | 長い文書の読解 | 64.06 |
Terminal-Bench 2.1 | ターミナル操作でタスクを完了する力 | 50.98 |
WebArena(視覚) | 画面を見ながらWebを操作する力 | 50.86 |
MCP-Atlas | MCPツールの使いこなし | 52.20 |
HLE(ツールなし) | 最難関レベルの総合問題 | 25.30 |
GDPVal-AA-V2 | 実務タスクの出来 | 28.47 |
PinchBench | エージェント作業 | 87.82 |
モデルカードでは、比較相手のQwen3.6-35B-A3B(16bitの非圧縮版)を多くの項目で上回っています。逆にPinchBenchはQwen3.6が88.07でわずかに上でした。2bitに圧縮したBoltが、圧縮していない同クラスのモデルと並ぶか上回っている点が、このモデルの一番の売りです。
これらはNVIDIA自身が測った数値です。NVIDIA以外の評価では、AIモデル評価サイトのArtificial Analysisが総合指標「Intelligence Index」でBoltに21を付け、同じ規模のモデル67件中4位(このクラスの中央値は8)としています。
そのほかの強み
- データを外に出さずに使える: 公式ブログも「作業をクラウドに送らずに」動かせる点を打ち出しています。社外秘の資料や顧客データを扱う作業と相性がよいモデルです
- 画像が読めるローカルモデル: 画面のスクリーンショットや図表を見ながら作業できるため、ブラウザ操作や書類チェックのエージェントに使いやすい
- OpenClawやClaude Codeとすぐつなげられる: Ollamaの公式ページに、OpenClaw・Claude Code・OpenCode・Hermesをこのモデルで起動するコマンドが用意されています
- 長いコンテキスト: メモリに余裕があれば最大256Kトークンまで扱えます
- 入手経路が多い: Hugging Face、Ollama、LM Studio、llama.cpp、vLLM、Docker Model Runnerなどで配布・対応されています
Nemotron 3.5 Boltの弱み・注意点
弱みは、速さ・コーディングの安定性・動かせる機材の幅の3点です。導入前に次の点を確認しておくと失敗を避けられます。
速度はQwen3.6・Gemma 4より遅い
NVIDIA自身が公開した速度比較で、BoltはQwen3.6やGemma 4より遅い結果になっています。測定はRTX Spark搭載のSurface Laptop Ultra(128GB)、Windows 11、llama.cppです。
モデル(量子化・高速化手法) | コード生成の速度(トークン/秒・高いほど速い) | エージェント作業の所要時間(秒・短いほど速い) |
|---|---|---|
Nemotron 3.5 Bolt(IQ2_XXS+LiLiCorr) | 83.99 | 600.80 |
Qwen3.6 35B-A3B(Q4_K_M+MTP) | 96.63 | 453.97 |
Gemma 4 26B-A4B(Q4_K_M+MTP) | 100.56 | 480.68 |
Qwen3.8 27B(Q4_K_M+DFlash) | 28.26 | 1043.28 |
出典: NVIDIA Research
「Qwen3.6やGemma 4より賢いが、速さでは負ける」と見るのが妥当です。ただし毎秒80トークン超は、人が読むには十分な速さです。参考値として、NVIDIAの開発者フォーラムではDGX Spark 1台で毎秒約140トークン出たというユーザー報告もあります(報告は1件で、条件によって変わります)。
出力が長くなりやすい
Artificial Analysisの評価では、テストの間に出力したトークン数が約2.3億と、同じ条件のモデルの中央値(約1億)の2倍を超えました。推論モードがONだと考える過程も出力に含まれます。思考トークンと回答は同じ max_tokens の枠を使うため、上限が小さいと回答の途中で切れることがあります。
コーディングは安定しない場面がある
AIツール企業MindStudioが独自に試した結果では、画像を使った推論(回路図の読み取りなど)は高い評価でした。一方、Docker Composeアプリに仕込まれたバグを見つけられずに誤った処理を「正しい」と判断したり、HTML Canvasのアニメーションが崩れたりと、コーディングでは失敗が出ています。翻訳では、話者の少ない言語で事実と違う内容を作ったり、同じ文を繰り返したりする例もありました。
日本語性能はまだ第三者の検証がない
日本語はサポート対象ですが、日本語に絞った第三者のベンチマークは2026年10月20日時点で見当たりません。日本語の文章を業務で使うなら、自社の実際のタスクで出来を確かめてから判断してください。
Macでは使えない・24GBのGPUでは足りない
Ollamaの公式ページには「Apple Silicon/Metalは現在非対応」と明記されています。また「24GB」はモデルファイルの大きさで、24GBのGPUにそのまま載るという意味ではありません。公式手順で最も小さい構成でも「32GB以上のRTX GPU」が条件です。
Nemotron 3.5 Boltの料金とライセンス
モデル自体は無料です。重みはHugging Faceなどで配布されており、利用料はかかりません。費用はほぼ動かす機材の代金と電気代です。
項目 | 内容 |
|---|---|
モデルの利用料 | 無料(オープンウェイト) |
ライセンス | OpenMDW-1.1 |
商用利用 | 可(モデルカードに「商用・非商用で利用可」と記載) |
NVIDIAが提供するAPI | 2026年10月20日時点で確認できず。NVIDIAの公式ブログでNIM(NVIDIAの推論サービス)に触れているのはSuper VLのみ |
主な費用 | 機材代。RTX Spark搭載ノートPCは米国の予約価格で2,599.99ドル〜と報じられている(日本価格は未発表) |
OpenMDW-1.1は、Linux Foundationが2026年5月に公開したライセンスで、モデルの重み・データ・コード・文書をまとめて扱えます。報道によると、利用料は不要で、用途や地域の制限もなく、改変したものを公開する義務もありません。再配布するときはライセンスと著作権表示を残す必要があります。2026年8月にOSI(オープンソースの定義を管理する団体)へ承認を申請しており、10月20日時点で承認は確認できていません。
業務で使う場合は、ライセンスについて次のことを確かめておきましょう。
- ライセンスの細かい条件は、配布ページに添付されたライセンス本文で確認する
- 第三者が変換・再配布したモデルは、ライセンス表記が本家と食い違う例が過去のNemotronでもあった。商用利用では本家の
nvidia/リポジトリの表記を基準にする
RTX Spark搭載PCの機種や価格はNVIDIA RTX Sparkとはで詳しく整理しています。
Nemotron 3.5 Boltを動かすのに必要なスペック
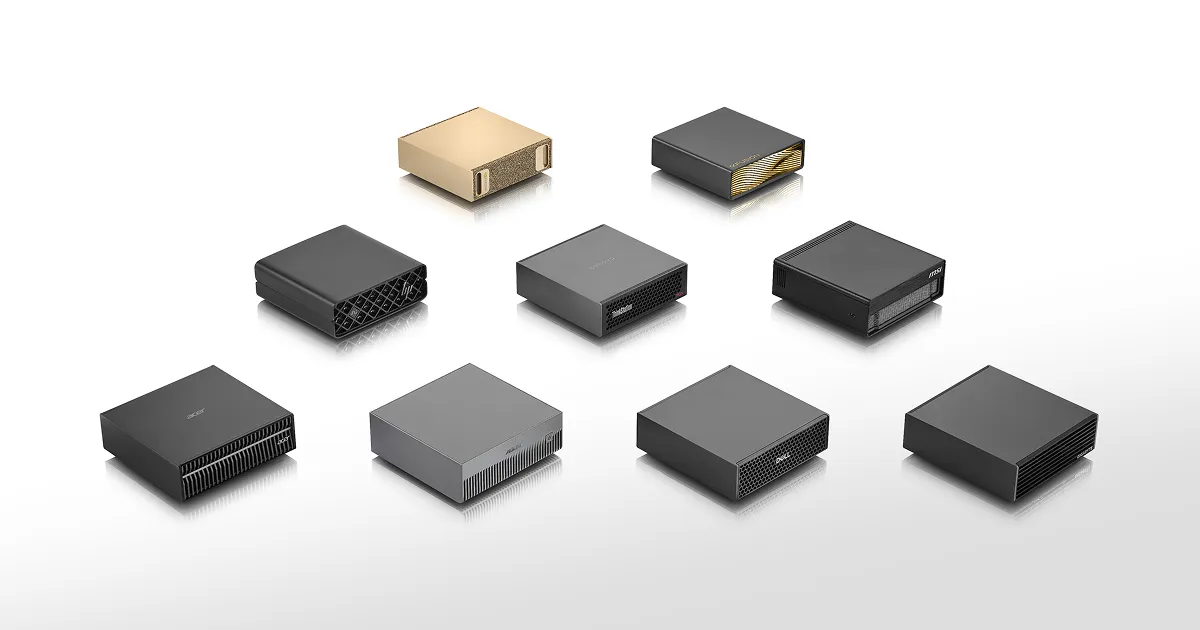
目安は「NVIDIA GPUで32GB以上のメモリ」です。モデル本体の約24GBに加えて、会話の記憶にあたるKVキャッシュや下書きモデルの分がいるためです。公式の手順(Hugging FaceのGGUF版のレシピ)は2通り用意されています。
公式レシピ | 想定する機材 | 使えるコンテキスト長 |
|---|---|---|
32GBレシピ | RTX Spark(128GB)、または48GB以上のRTX GPU | 262,144トークン(256K) |
28GBレシピ | RTX Spark(64GB)、または32GB以上のRTX GPU | 65,536トークン(64K) |
GGUF版が対応するのはAda Lovelace世代(RTX 40シリーズなど)とBlackwell世代(RTX 50シリーズなど)のGPUで、OSはWindowsとLinuxです。vLLMで動かす場合は、A100(Ampere)やH100(Hopper)などのデータセンター向けGPUも対象になります。
自分のPCで動くかの判定表
手元の環境 | 判定 | 理由 |
|---|---|---|
RTX Spark搭載PC(128GB) | ◎ 動く | 32GBレシピの対象。256Kまで使える。NVIDIAの速度測定もこの機材 |
RTX Spark搭載PC(64GB) | ○ 動く | 28GBレシピの対象。コンテキストは64Kまで |
DGX Spark | ◎ 動く | 公式ブログで対応を明記。メモリは128GB |
48GB以上のRTX GPU(RTX PROなど) | ◎ 動く | 32GBレシピの対象 |
32GBのRTX GPU(RTX 5090など) | ○ 条件付き | 28GBレシピの条件「32GB以上のRTX GPU」に当てはまる。コンテキストは64K、余裕は少ない |
24GBのRTX GPU(RTX 4090など) | △ 未確認 | 公式レシピの対象外。単体GPUで約30GBを使ったというNVIDIA以外の測定もあり、そのままでは厳しい |
RTX 30シリーズ(Ampere) | △ 未確認 | GGUF版の対応世代(Ada/Blackwell)の対象外 |
Mac(Apple Silicon) | × 非推奨 | Ollamaは非対応と明記。Unslothは「CUDAなしでllama.cppをビルドすれば動く」と案内しているが、実用的な速度かは未確認 |
AMD・Intel GPU | △ 未確認 | 公式の情報なし |
Macで手軽にローカルモデルを試したい場合は、Apple Siliconで動かす手段がそろった別のモデルを選ぶほうが確実です。候補としてはGemma 4やQwen3.8があります。
このツールを自社のシステムや業務にどう組み込むか、ご提案します
初回相談は無料・30分(オンライン)。要件が決まっていなくても大丈夫です。改修100万円〜・PoC300万円〜(税別)
Nemotron 3.5 Boltの使い方
出典: Ollama 公式サイト
一番手軽なのはOllamaです。コマンド1行でダウンロードから会話まで進みます。細かく速度を詰めたい場合は、NVIDIAが公式に配布しているGGUF版をllama.cppで動かします。
Ollamaで動かす
Ollamaをインストールしたら、次のコマンドを実行します。初回は約25GBのダウンロードが入ります。
ollama run nemotron-3.5-bolt画像も読ませられます。Ollama版の入力はテキストと画像で、動画は読めません。
OpenClaw・Claude Codeをローカルモデルで動かす
Ollamaの公式ページには、エージェントツールをBoltで起動するコマンドが載っています。
# OpenClaw をBoltで動かす
ollama launch openclaw --model nemotron-3.5-bolt

# Claude Code をBoltで動かす
ollama launch claude --model nemotron-3.5-bolt

# OpenCode / Hermes も同様
ollama launch opencode --model nemotron-3.5-bolt
ollama launch hermes --model nemotron-3.5-boltクラウドのAPI料金をかけずにOpenClawを常時動かしたい人にとって、ここが一番実用的な使い道です。ただし、クラウドの最上位モデルと比べるとコーディングの精度は落ちるため、重要なコードはテストやレビューを通してから使ってください。
LM Studio・llama.cpp・vLLMで動かす
方法 | 向いている人 | ポイント |
|---|---|---|
LM Studio | 画面で操作したい人 | 公式ブログで対応ツールとして挙げられている。モデル検索から入手 |
llama.cpp | 速度や設定を細かく詰めたい人 | 公式GGUF(IQ2_XXS、約22GB)と下書きモデルLiLiCorr(約1GB)を組み合わせると速くなる。動画入力もこちらで使える。手順はUnslothのガイドが詳しい |
vLLM | サーバーで複数人から使いたい人 | OpenAI互換APIとして公開できる。ツール呼び出しには |
Docker Model Runner | Docker環境にそろえたい人 |
|
設定のコツ
- サンプリング: モデルカードの推奨は temperature 1.0、top_p 0.95
- 推論モードのON/OFF: OpenAI互換APIでは、リクエストの
chat_template_kwargsで切り替えます。簡単な質問や速さを優先したいときはOFFにすると、待ち時間と出力の長さを抑えられます
{
  "model": "nemotron-3.5-bolt",
  "messages": [{"role": "user", "content": "この画像の表を要約して"}],
  "temperature": 1.0,
  "top_p": 0.95,
  "chat_template_kwargs": {"enable_thinking": false}
}- max_tokensは大きめに: 推論モードON時は、考える過程と回答が同じ上限を分け合います。回答が途中で切れる場合は上限を上げてください
- コンテキスト長は必要な分だけ: 256Kをそのまま指定するとメモリを大きく使います。64GB以下の機材では64K程度から始めると安定します
Nemotron 3.5 Boltと他のモデルの違い
選び方の目安は、賢さ重視ならBolt、速さ重視ならQwen3.6・Gemma 4やNemotron 3.5 Lightning、企業のサーバーで大規模に動かすならSuper VLです。
Nemotron 3.5ファミリー内の違い
モデル | 規模 | 主な対象 | 入力 | 向いている用途 | 提供状況(10月20日時点) |
|---|---|---|---|---|---|
Bolt 74B-A9B 24GB | 総74B/有効9B | RTX Spark、DGX Spark、32GB以上のRTX GPU | テキスト・画像・動画 | 画像を読みながら進めるローカルのエージェント作業 | 公開中 |
Bolt E4B 4GB | 小型(詳細は未公表) | GeForce RTX、Jetson、RTX/DGX Spark | 未確認 | 音声アシスタント、会話キャラクター | 10月23日予定 |
Nemotron 3.5 Lightning 30B-A3B | 総30B/有効3B | 軽さを優先したい環境(Boltより小型) | テキストのみ | 軽さと速さ重視のテキスト処理 | 公開中 |
Nemotron 3.5 Super VL | 総120B/有効12B | データセンター・企業サーバー | テキスト・画像 | 企業向けの大規模なエージェント処理(NIMでの提供に言及あり) | 公開中 |
Artificial AnalysisのIntelligence Indexでは、Super VLが26.5、Boltが21、Lightningが13です。Boltは「Super VLの賢さを、PCに載る大きさまで縮めたモデル」と考えるとわかりやすいでしょう。
Nemotronの前の世代のマルチモーダルモデルはNemotron 3 Nano Omni、音声対話に特化したモデルはNemotron VoiceChatで解説しています。
Qwen3.6・Gemma 4・Qwen3.8との比較
比較ポイント | Nemotron 3.5 Bolt | Qwen3.6 35B-A3B | Gemma 4 26B-A4B | Qwen3.8 27B |
|---|---|---|---|---|
開発元 | NVIDIA | Alibaba(Qwen) | Alibaba(Qwen) | |
賢さ(エージェント作業) | 同クラスで上位(NVIDIA測定) | Boltに近い。PinchBenchはわずかに上 | NVIDIAの精度比較の対象外 | NVIDIAの精度比較の対象外 |
速度(RTX Spark、コード生成) | 約84トークン/秒 | 約97トークン/秒 | 約101トークン/秒 | 約28トークン/秒 |
エージェント作業の所要時間 | 約601秒 | 約454秒 | 約481秒 | 約1043秒 |
量子化(測定時) | 2bit(IQ2_XXS) | 4bit(Q4_K_M) | 4bit(Q4_K_M) | 4bit(Q4_K_M) |
Macでの利用 | 非対応(Ollama公式) | Macで動かす手段あり | Macで動かす手段あり | Macで動かす手段あり |
速度と所要時間はNVIDIA Researchの同一条件での測定値です。賢さの比較もNVIDIAの自社測定なので、自分の作業で試して確かめるのが確実です。
用途別のおすすめ
やりたいこと | おすすめ |
|---|---|
画面や図表を読みながら、Web調査やブラウザ操作をローカルで自動化したい | Nemotron 3.5 Bolt |
OpenClawをAPI料金なしで、なるべく賢いモデルで動かしたい(NVIDIA GPUあり) | Nemotron 3.5 Bolt |
とにかく速く返してほしい、軽い作業が中心 | Qwen3.6、Gemma 4、Nemotron 3.5 Lightning |
Macで動かしたい | Gemma 4、Qwenシリーズ |
コーディングの精度を最優先したい | クラウドのClaude・GPT系モデル |
社内サーバーで多人数に提供したい | Nemotron 3.5 Super VL、またはvLLMで動かすBolt |
業務で使うときのセキュリティと注意点
ローカルで動くことは安全面の大きな利点です。ただし、データが社外に出ないことと、エージェントが安全に動くことは別の話です。業務で使うときは、特に次のことに気をつけてください。
- 権限はモデルではなくエージェントツール側で決まる: OpenClawやClaude Codeと組み合わせると、モデルの判断でファイル編集・コマンド実行・ブラウザ操作が行われます。作業フォルダを限定し、サンドボックスの中で動かし、危険な操作の前には確認を挟む設定にしてください。OpenClawを組織で管理する仕組みとしては、NVIDIAのNemoClawがあります
- 入力する画像・動画の権利を確認する: モデルカードは、入力する画像・動画について利用者が権利や許可を持っていることを求めています。また、出力は画像に写った人物や健康情報、知的財産をぼかしたり保護したりしません
- 安全のための仕組みを外さない: モデルカードは、用途に合った代わりの対策なしに安全ガードレールを回避しないよう求めています
- モデルの入手元を確認する: 量子化版は第三者からも配布されています。業務ではNVIDIA公式(
nvidia/リポジトリ)か、Ollamaなど信頼できる配布元から入手してください
ローカルモデルで作った試作やツールを業務で使い続けるには、社内の実データや既存システムとの安全なつなぎ方、権限管理、障害時の対応、保守を誰が担うかといった体制も決めておく必要があります。その段階の進め方はAIで作ったアプリを開発会社へ引き継ぐにはで整理しています。
NVIDIAがオープンモデルと安全性をどう両立させようとしているかは、Open Secure AI Allianceの記事も参考になります。
Nemotron 3.5 Boltはこんな人におすすめ
おすすめな人
- RTX Spark搭載PC、DGX Spark、32GB以上のメモリを積んだRTX GPUをすでに持っている、または購入予定の人
- 社外秘の資料や顧客データを、クラウドに送らずAIで処理したい企業・チーム
- スクリーンショットや図表を読ませながら作業するローカルエージェントを作りたい開発者
- OpenClawやClaude Codeを、API料金を気にせずローカルモデルで動かしてみたい人
- 商用利用できるオープンモデルを、自社製品やサービスに組み込みたい人
おすすめしない人
- Macで使いたい人(現時点でOllamaは非対応)
- 24GB以下のGPUしか持っていない人
- コーディングの精度を最優先する人(クラウドのClaudeやGPT系のほうが安定)
- 日本語の高品質な文章生成が主な目的の人(日本語の第三者評価がまだない)
- 応答の速さを最優先する人(Qwen3.6、Gemma 4、Nemotron 3.5 Lightningのほうが速い)
- ハードウェアを新しく買わずに手軽に試したい人(機材代が数十万円単位になる)
よくある質問
Q. インターネットにつながっていなくても使えますか?
モデルを一度ダウンロードしてしまえば、推論そのものはPCの中だけで完結します。ただし、Web調査やブラウザ操作のように外部の情報を取りに行く作業には、ネット接続が必要です。完全にオフラインの環境で使う場合は、文書の要約や画像の読み取りなど、手元のデータだけで済む作業に絞ることになります。
Q. Nemotron 3 Nano・Super・Ultraとはどういう関係ですか?
2025年12月に公開されたNemotron 3世代(Nano/Super/Ultra)の後継にあたるのが、今回のNemotron 3.5世代です。3.5世代では、データセンター向けのSuper VL、PC向けのBolt、軽量なLightningという分け方になりました。Boltは3.5世代のSuper VLを元に作られています。
Q. 動画はどのくらいの長さ・画質まで読めますか?
モデルカードでは、MP4形式で最大2分までです。Unslothのガイドによると、1080pなら1秒に1コマ・最大128コマ、720pなら1秒に2コマ・最大256コマに間引いて読み込みます。llama.cppで使う場合は、動画の処理にffmpegが必要です。
Q. 学習データはいつ時点までのものですか?
モデルカードによると、事前学習のデータは2026年2月24日まで、事後学習のデータは2026年5月までです。それ以降の出来事や新しい製品・料金については知らないため、最新の情報が必要な作業ではWeb検索と組み合わせてください。
Q. Bolt E4Bは何が違い、いつ使えるようになりますか?
E4Bはモデル本体が約4GBの小型版で、Jetsonなどの組み込み機器も対象にした会話向けモデルです。公開は2026年10月23日の予定とされています。74B-A9Bほどの考える力は求めず、音声アシスタントのように素早く返す用途を想定しています。
まとめ
- Nemotron 3.5 Boltは、NVIDIAが2026年10月15日に公開した、画像も読めるローカル向けのオープンウェイトモデル。総74B・有効9BのMoE構造と2bit量子化で、モデル本体を約24GBに収めている
- 同じくらいのメモリで動くモデルの中ではエージェント作業の成績が高い。一方、速度はQwen3.6・Gemma 4より遅く、コーディングでは失敗も報告されている
- モデルは無料でOpenMDW-1.1ライセンス(商用利用可)。かかる費用は主に機材代
- 動かすにはNVIDIA GPUで32GB以上のメモリが目安(256Kコンテキストなら48GB以上)。Macは現時点で非対応
- Ollamaなら
ollama run nemotron-3.5-boltで始められ、ollama launch openclawでOpenClawのローカルモデルとしても使える - 業務ではデータを外に出さない利点を活かしつつ、エージェントツール側の権限管理とライセンス確認を忘れずに
ローカルAIを含む生成AIの全体像は生成AIとは、Boltと組み合わせるエージェントツールはOpenClawとはで詳しく解説しています。
このツールを自社のシステムや業務にどう組み込むか、ご提案します
この記事の著者

AI革命
編集部
AI革命株式会社の編集部です。最新のAI技術動向から実践的な導入事例まで、企業のデジタル変革に役立つ情報をお届けしています。豊富な経験と専門知識を活かし、読者の皆様にとって価値のあるコンテンツを制作しています。
最新記事
Grok 4.5とは?API料金$2/$6・V9基盤・「Opus級性能」の実態とGrok 4.6/4.7との違い【2026年10月】
2026/07/09
OpenAI Daybreakとは?GPT-5.6-Cyber・Blue/Red・Codex Security・Patch the Planetを解説【2026年10月最新】
2026/05/15
Microsoft 365 Copilot エージェントとは?Word/Excel/PowerPointの自律実行機能・料金・制限を解説
2026/04/29
OpenAI Codex Labs とは|Accenture・PwC・Cognizant・CGI・Infosys・TCS・Capgemini 7大コンサル提携エンタープライズ導入ガイド【2026年10月】
2026/04/27
DeepSeek DeepInferとは?できること・動作環境・公開範囲・自社で使うべきかを整理【2026年10月】
2026/10/20
Windsurf 2.0 とは?Devin Desktop統合・Agent Command Center・料金・使い方を徹底解説【2026年10月最新】
2026/04/20