NVIDIA Nemotron 3 Nano Omniとは?30B MoEマルチモーダルAIの性能・料金・使い方を徹底解説
この記事のポイント
NVIDIA Nemotron 3 Nano Omniは、テキスト・画像・動画・音声を1モデルで読み取れるオープンウェイトの推論モデルです。「9倍スループット」の測定条件、「25GB」で動く版、無料APIとローカル実行、英語専用という制約、Qwen3-OmniやNemotron 3.5系との選び分けを公式情報で整理します。
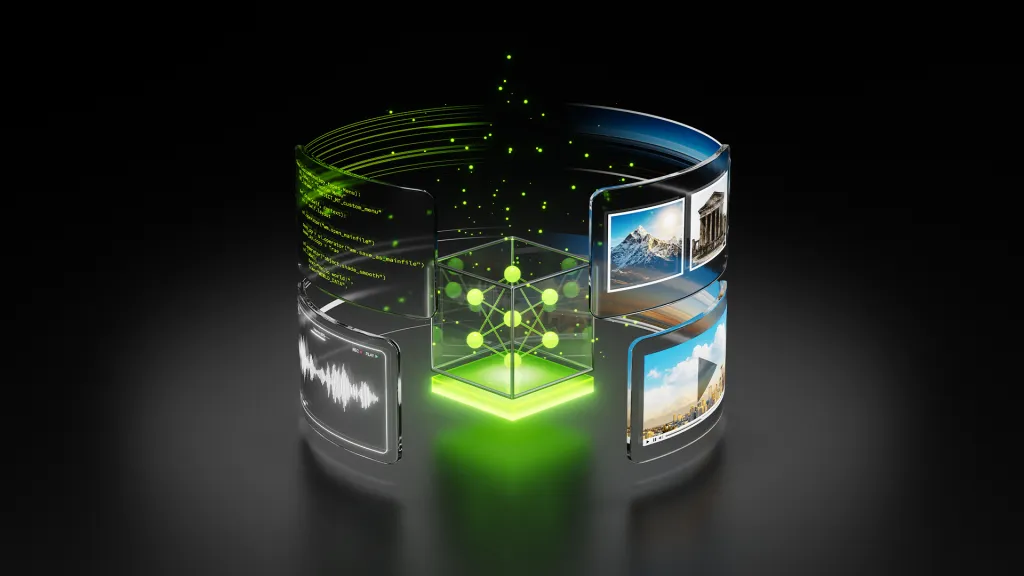
Nemotron 3 Nano Omniは、NVIDIAが2026年4月28日に公開した、テキスト・画像・動画・音声を1つのモデルで入力でき、テキストで答えるオープンウェイトのマルチモーダル推論モデルです。総パラメータ約30B・アクティブ約3BのMoE構造で、NVIDIAの論文では単一のB200 GPU上でQwen3-Omniの最大9倍の量をさばけたと報告されています(長尺動画の場合。複数文書では7.5倍)。
2026年10月時点では、Nemotron 3.5 LightningやNemotron 3.5 Super VLなど後続モデルも出ています。ただ、音声入力まで1モデルで扱えるNemotronは今もNano Omniだけです。
この記事でわかることは次のとおりです。
- Nano Omniで何ができるか(4種類の入力と、ベンチマークで見た得意分野)
- 「9倍スループット」が何を測った数字なのか、そのまま受け取ってはいけない理由
- 「25GB RAM」で動くのはどの版か、手持ちのGPUごとにどの版を選ぶか
- 料金(OpenRouter無料版・有料API・セルフホスト)と試し方
- 英語専用などの制約、Qwen3-OmniやNemotron 3.5系との選び分け
AIエージェントを作る開発者、MLエンジニア、マルチモーダルAIの導入を検討している企業の担当者に向けた解説です。生成AI全体の基礎は生成AIとはで整理しています。
Nemotron 3 Nano Omniとは
出典: NVIDIA 公式ブログ
Nemotron 3 Nano Omniは、AIエージェントの「目と耳」を受け持つためにNVIDIAが作ったマルチモーダルモデルです。正式名は Nemotron-3-Nano-Omni-30B-A3B-Reasoning で、Hugging FaceにはBF16・FP8・NVFP4の3つの版が公開されています。
これまでは、文章は言語モデル、画像は視覚モデル、音声は音声認識モデルと、入力の種類ごとに別のモデルをつなぐ構成が一般的でした。Nano Omniはこれを1モデルにまとめます。論文によれば、Nemotronのマルチモーダル系列で音声入力に対応したのはこのモデルが初めてです。前世代のNemotron Nano V2 VLは画像・動画・テキストのみでした。
NVIDIAの開発者ブログでは、Nano Omniは大きなエージェント構成の中で画面・文書・音声・動画を読み取る役を担い、計画や実行はNemotron 3 Super/Ultraなど別のモデルが受け持つ使い方が想定されています。エージェントの全体像はAIエージェントとはで解説しています。
項目 | 内容 |
|---|---|
正式モデル名 | Nemotron-3-Nano-Omni-30B-A3B-Reasoning |
開発元 | NVIDIA |
公開日 | 2026年4月28日(論文 arXiv 2604.24954) |
パラメータ | 総約30B/アクティブ約3B(MoE)※エンコーダ込みでは約31〜33Bと表記される |
アーキテクチャ | Mamba2+TransformerのハイブリッドMoE(言語部分はNemotron 3 Nano 30B-A3B) |
入力 | テキスト・画像・動画・音声 |
出力 | テキストのみ(JSON出力・ツール呼び出し・思考過程・文字起こしのタイムスタンプ) |
対応言語 | 英語のみ(モデルカード記載) |
コンテキスト長 | 最大256K(モデルカード) |
ライセンス | NVIDIA Open Model Agreement(商用利用可) |
提供形態 | オープンウェイト(Hugging Face)、NVIDIA NIM、OpenRouter、各社推論API、AWS SageMaker JumpStart、ローカル実行 |
パラメータ数が30B・31B・33Bと資料によって違うのは、画像・音声のエンコーダを含めるかどうかの数え方の差です。この記事では「総約30B・アクティブ約3B」と表記します。
「Nano」なのに30Bある理由とMoE構造
名前は「Nano」でも総パラメータは約30Bあります。これはMoE(Mixture-of-Experts)という設計のためです。
MoEのモデルは、処理のたびに全パラメータを動かすわけではありません。言語部分のNemotron 3 Nanoでは、128のエキスパート(専門の小さな回路)から上位6つを選んで計算します。そのため、1トークンあたりに実際に使うのは約3B分です。30B級の知識量を持ちながら、計算量は3B級に近いと考えるとわかりやすいでしょう。
ただし、メモリには全パラメータを載せる必要があります。「3Bだから軽い」のは計算量の話で、必要なVRAMは30B級として見積もります。
できること(4種類の入力をまとめて処理する機能)
Nano Omniが特に強いのは、画面操作・長い文書や図表の読み取り・音声と動画の理解の3分野です。NVIDIAは公式ブログで、文書理解と動画・音声理解の6つのリーダーボードで首位を取ったとしています。
対応する入力・出力の仕様
入力 | 対応形式 | 制限・注意 |
|---|---|---|
テキスト | 文字列 | 英語のみが公式の対応言語 |
画像 | JPEG・PNG | モデルカードに解像度上限の記載なし(論文では最大1,840×1,840相当まで動的に処理) |
動画 | MP4 | 最大2分。1080pなら最大1FPS・128フレーム、720pなら2FPS・256フレームまで |
音声 | WAV・MP3(8kHz以上) | 最大1時間 |
直接は不可 | ページを画像に変換して渡す | |
出力 | テキスト | 画像・音声・動画は生成しない |
動画については、推論サーバーの既定設定だとフレーム抽出が約32枚と控えめです。モデルカードでは、vLLMの起動時に --media-io-kwargs でフレーム数を増やす方法が案内されています。
主要機能とベンチマーク
数値はHugging FaceモデルカードのBF16版のものです(前世代はNemotron Nano V2 VL)。
分野 | ベンチマーク | Nano Omni | 前世代 |
|---|---|---|---|
画面操作(computer use) | OSWorld | 47.4 | 11.1 |
OCR(英語) | OCRBenchV2 | 67.04 | 54.8 |
図表の読み取り | CharXiv Reasoning | 63.6 | 41.3 |
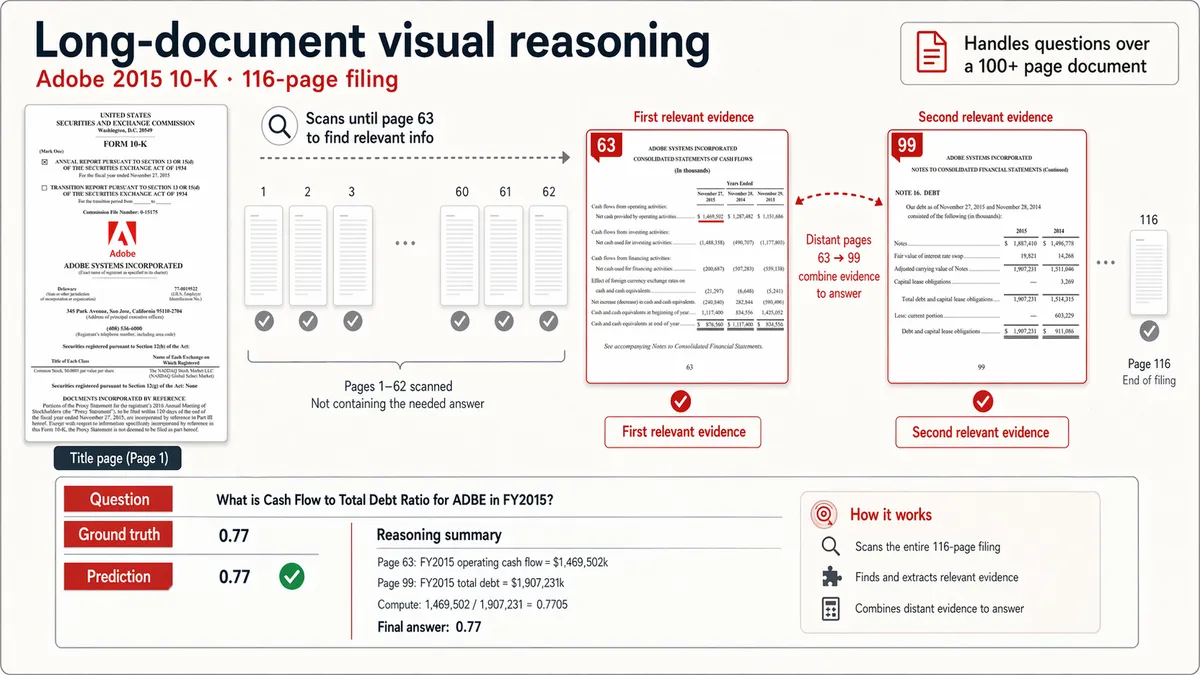
長い文書 | MMLongBench-Doc | 57.5 | 38 |
数学×画像 | MathVista mini | 82.8 | 75.5 |
画像の空間理解 | CVBench2D | 83.95 | 78.3 |
動画理解 | Video-MME | 72.2 | — |
映像+音声 | WorldSense | 55.4 | — |
映像+音声 | DailyOmni | 74.52 | — |
音声対話 | VoiceBench | 89.39 | — |
1. 画面操作エージェント
OSWorldは、パソコンの画面を見て操作手順を決める力を測るベンチマークです。前世代の11.1から47.4へ大きく伸びました。ブラウザや業務アプリを操作するエージェントに組み込む用途が想定されています。
2. 長い文書・図表・OCR
MMLongBench-DocやCharXiv Reasoningの伸びが大きく、英語の財務レポート、論文、仕様書のように、図表と文章が混ざった長い資料の読み取りに向きます。
3. 動画と音声をまとめて理解
動画の映像と音声を同時に読み取り、「この会議で誰が何を決めたか」「この映像のどこで異常音が鳴ったか」といった質問に答えられます。音声の文字起こしでは単語ごとのタイムスタンプも出せます。
4. 推論(thinking)とツール呼び出し
既定で思考モードが有効で、enable_thinking で切り替えます。モデルカードの推奨値は、思考ありで temperature 0.6・top_p 0.95、思考なしで temperature 0.2 です。ツール呼び出しとJSON出力は、どの入力の種類でも使えます。
5. 長いコンテキスト
モデルカード上の最大は256Kトークンです。vLLMの起動例では --max-model-len 131072 が使われており、AWSの解説で「131K」とあるのはこの設定値に由来すると考えられます。SGLangの資料には「最大1M」という記載もあり、資料によって数字が違うため、ここでは公式カードの256Kを採っています。
Mamba×MoE×マルチモーダルのアーキテクチャ
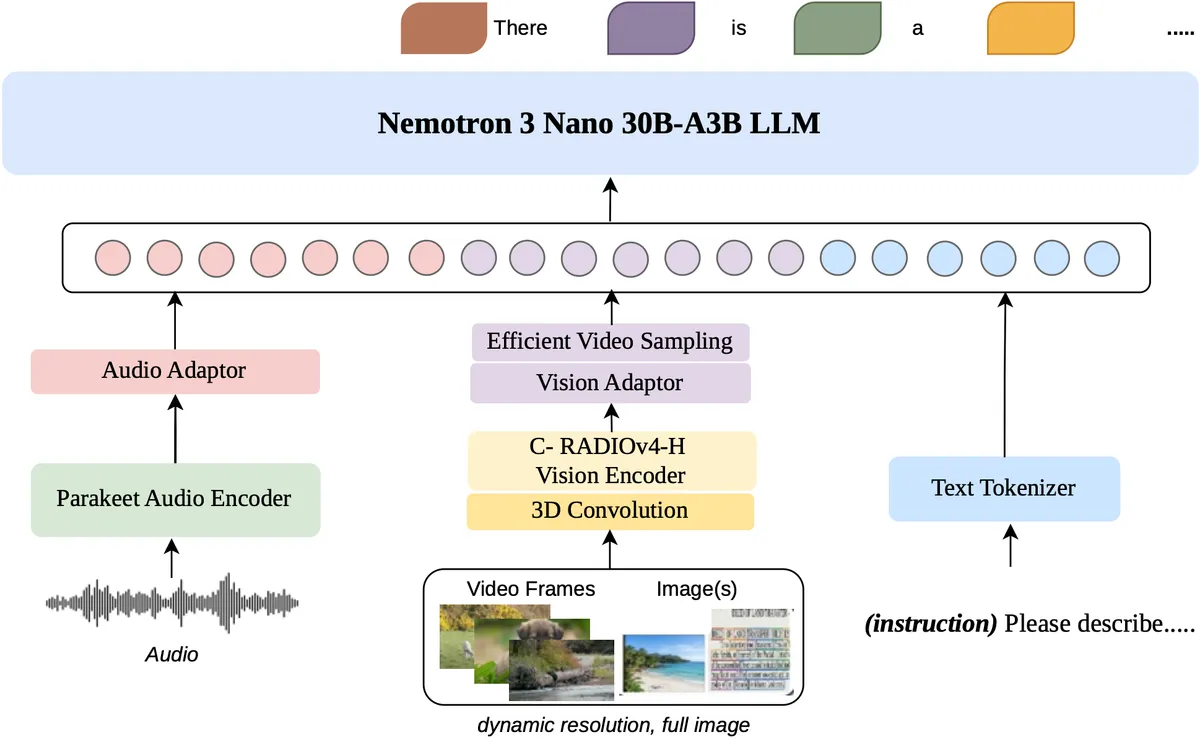
Nano Omniは、言語部分・画像エンコーダ・音声エンコーダの3つで構成されています。速さの理由は主に、言語部分のハイブリッド構造と、動画のトークンを減らす2つの工夫にあります。
言語バックボーン:Nemotron 3 Nano 30B-A3B
中核はテキスト用のNemotron 3 Nano 30B-A3Bです。Nemotron 3 Nano系の公表値では、次の3種類の層を組み合わせています(Omniのモデルカード自体には層数の記載がないため、言語部分の構成として紹介します)。
- Mamba層(23層): 長い入力を少ないメモリで順に処理する層。長い文書や動画のトークン列で役立ちます
- MoE層(23層、128エキスパートから上位6つを選択): 入力に応じて一部の回路だけを動かし、計算量を抑えます
- Attention層(6層): 離れた位置の情報を正確に参照する、Transformer型の層
すべてをAttention層にすると、入力が長くなるほどメモリと計算が急に増えます。Attentionを最小限にしてMambaに任せる割合を増やしたことが、長い動画や文書での速さにつながっています。NVIDIAの開発者ブログは、このハイブリッド設計でメモリと計算の効率が最大4倍になると説明しています(比較対象の明記はありません)。
視覚エンコーダ:C-RADIOv4-H
画像はC-RADIOv4-Hで処理します。動画には次の2つの工夫があります。
- Conv3D: 連続するフレームをまとめて1つのトークン群にし、トークン数を減らします
- EVS(Efficient Video Sampling): 変化の少ないフレームのトークンを間引きます
論文では、512フレームの動画を同時1件で処理したとき、この2つで最初の1トークンが出るまでの時間がBF16で7,969ミリ秒から5,313ミリ秒へ約33%短くなったと報告されています。
音声エンコーダ:Parakeet系
音声はNVIDIAの音声認識モデルParakeet系のエンコーダで処理し、言語部分に渡します。音声だけで返答を返す機能はなく、出力はあくまでテキストです。音声で返したい場合は、Nemotron VoiceChatのような音声対話モデルや音声合成と組み合わせます。
「9倍スループット」の実態と測定条件
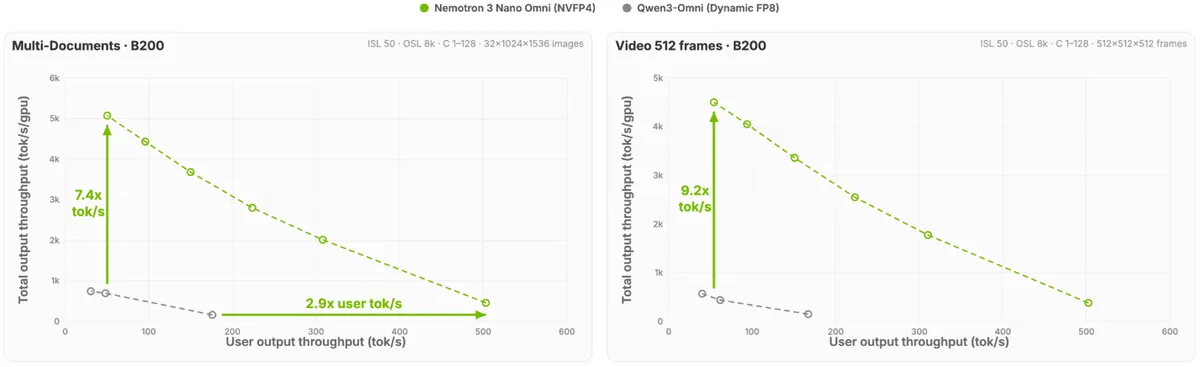
「9倍」は、GPU1枚で同時にさばける量が9倍という意味です。1人のユーザーから見た応答の速さが9倍になるわけでも、精度が9倍になるわけでもありません。
測定条件(論文 §4.8)
項目 | 内容 |
|---|---|
GPU | NVIDIA B200 1枚(データセンター向けの最新世代) |
量子化 | Nano Omni=NVFP4、Qwen3-Omni=dynamic FP8(条件はそろっていない) |
比べ方 | 1ユーザーあたりの出力速度を50 tok/sにそろえたとき、GPU1枚でどれだけ多く出力できるか |
推論エンジン | vLLM nightly(2026年4月19日時点)、EVS 50% |
結果
指標 | 結果 | 補足 |
|---|---|---|
長尺動画(512×512・512フレーム) | Qwen3-Omniの9倍 | 開発者ブログの表記は約9.2倍 |
複数文書(1024×1536の画像32枚) | Qwen3-Omniの7.5倍 | 開発者ブログの表記は約7.4倍 |
前世代Nano V2 VLとの比較 | 3倍 | 同じNVFP4どうし |
複数文書・最大同時実行時 | 毎秒5,000出力トークン | — |
同時1件の出力速度 | 500 tok/s超(Qwen3-Omniは175〜210、Nano V2 VLは250) | 1ユーザーの体感差は約2.4〜2.9倍 |
最初の1トークンまで(複数文書) | 約1.3秒(Qwen3-Omniは2.5秒超) | — |
NVFP4とBF16の差(画像1枚) | 毎秒18,200 vs 2,400トークン(約7.5倍) | 150 tok/s/ユーザー時 |
論文は9倍・7.5倍、開発者ブログは約9.2倍・約7.4倍と、出典によって数字が少しずれています。引用するときは、どちらの数字かを出典と一緒に示すと誤解を招きません。
「9倍」を読むときの注意点
- 精度の比較ではない: 精度が同程度のモデルどうしで、さばける量を比べたものです
- 量子化の条件が違う: Nano OmniはNVFP4(4bit)、Qwen3-OmniはFP8(8bit)で測っています。同じ精度形式なら差は縮む可能性があります
- B200での値: NVFP4はBlackwell世代のGPU向けの形式です。RTX 40系やA100などでは同じ倍率になりません
- 体感速度とは別: 1ユーザーから見た出力速度の差は、同時1件で約2.4〜2.9倍です。「9倍」は多数のリクエストを同時に処理する、サーバー運用の場面で意味を持つ数字です
動画処理の外部評価としては、NVIDIAの開発者ブログが、Coactive社のMediaPerfで「すべての動画タスクでスループット最高、動画タギングで最安」だったと紹介しています。
DGX Sparkでの実機検証(Classmethod)
Classmethod(DevelopersIO)は2026年4月29日の記事で、NVFP4版(約21GB)をDGX Spark上のvLLM 0.20系で動かし、種類ごとの応答時間を公開しています。
入力 | 応答時間(NVFP4) |
|---|---|
画像(保護具の着用チェック) | 約2.04秒 |
英語音声(16秒) | 約0.85秒 |
動画(15秒) | 約0.64秒 |
同じ記事では、保護具チェックの画像課題でGemma 4 31Bが約9.78秒かかったと報告されています。計測条件の細部は元記事で確認してください。Gemma 4そのものの特徴はGemma 4とはで解説しています。
料金と利用方法(無料APIからセルフホストまで)
出典: NVIDIA API Catalog(build.nvidia.com)
モデル自体はオープンウェイトで、ダウンロードは無料です。費用がかかるのは、APIの利用料か、自前で動かすGPUの費用です。
利用方法の比較
方法 | 費用(2026年10月時点) | 向いている用途 | 注意点 |
|---|---|---|---|
OpenRouter 無料版 | 入力$0/出力$0 | 動作確認・評価 | レート制限と提供元のデータの扱いは公式で要確認 |
有料API(DeepInfra、Baseten、Fireworks AI、Together AI、fal.ai、FriendliAI、Clarifaiなど) | 各社の料金表で確認 | 本番の大量処理 | 単価は各社で異なり、変更もある |
NVIDIA NIM(build.nvidia.com) | 試用可。条件は公式で確認 | NVIDIA環境での検証 | 本番利用の条件は要確認 |
AWS SageMaker JumpStart | インスタンス料金 | AWS内で完結させたい場合 | GPUインスタンスの時間課金 |
セルフホスト | GPU・機材の費用 | 機密データ、オンプレミス運用 | 版の選び方と既知の不具合に注意 |
1. 無料APIで試す(OpenRouter)
OpenRouterでは nvidia/nemotron-3-nano-omni-30b-a3b-reasoning:free が入力・出力とも$0で提供されています。コンテキストは256K、最大出力は約66Kトークンです。第三者の価格トラッカー(llmprice.com)では、2026年10月20日時点でも掲載が続き、8月26日以降は価格の変更がありません。
無料版を使う前に、レート制限とデータの扱いは確かめておきましょう。
- レート制限: 「1日200リクエスト」とする第三者の記載がありますが、OpenRouter公式では確認できていません
- データの扱い: 無料のルートでは、入力したプロンプトを提供元が学習などに使う可能性があります。業務データや個人情報を入れる前に、OpenRouterの設定と提供元の方針を確認してください。EU域内だけで処理するルーティングには非対応です
OpenRouterはOpenAI互換のAPIなので、次のように呼び出せます。
from openai import OpenAI

client = OpenAI(
    base_url="https://openrouter.ai/api/v1",
    api_key="YOUR_OPENROUTER_API_KEY",
)

res = client.chat.completions.create(
    model="nvidia/nemotron-3-nano-omni-30b-a3b-reasoning:free",
    messages=[{
        "role": "user",
        "content": [
            {"type": "text", "text": "Summarize the key numbers in this chart."},
            {"type": "image_url", "image_url": {"url": "https://example.com/chart.png"}},
        ],
    }],
)
print(res.choices[0].message.content)
プロンプトは英語で書くのが前提です。
2. 有料APIを使う
NVIDIAの開発者ブログでは、DeepInfra、Baseten、Fireworks AI、Together AI、fal.ai、FriendliAI、Clarifaiなどが提供元として挙がっています。各社の単価は変わることがあるため、ここでは金額を書いていません。契約前に各社の料金ページで、入力・出力の単価と、画像・音声・動画の入力の課金方法を確認してください。
3. ローカル実行・セルフホスト
機密性の高い映像・音声・文書を外部に出したくない場合は、自前のGPUで動かします。版ごとのサイズと必要な機材は次のとおりです。
版 | 重みのサイズ | モデルカードの最低GPU | メモリの目安 |
|---|---|---|---|
BF16 | 約62GB | H100 80GB×1(推奨はB200/H200) | 60GB超 |
FP8 | 約33GB | L40S 48GB×1(推奨はRTX Pro 6000/B200) | — |
NVFP4 | 約21GB | RTX 5090 32GB×1、DGX Spark、Jetson Thor | — |
GGUF 4bit(Unsloth UD-Q4_K_XL) | — | — | 約25GB(RAM/VRAM) |
GGUF 8bit(Unsloth) | — | — | 約36GB |
「25GB RAM」の正体は、Unslothのドキュメントにある4bit GGUF版の目安です。NVIDIA公式の最低要件ではありません。NVIDIA公式の最小構成は、NVFP4版をRTX 5090(32GB)1枚で動かす形です。
量子化による精度の低下は小さく抑えられています。FP8版とNVFP4版は画像・音声のエンコーダをBF16のまま残しており、音声認識以外の9つのベンチマーク平均(思考なし)はBF16が65.80、FP8が65.40、NVFP4が65.43でした(モデルカード)。差は約0.4ポイントです。
GGUF版を使うときは、本体に加えて mmproj-BF16.gguf が必要です(画像入力に必須)。2bitのUD-Q2_K_XLもありますが、一部のテンソルは低ビット化できないため、量子化版どうしのサイズ差は思ったより小さくなります。
手持ちのGPU別の選び方
手持ちの環境 | おすすめの版 | 理由 |
|---|---|---|
RTX 5090、DGX Spark、Jetson Thor(Blackwell世代) | NVFP4 | 公式の最小構成。速度と精度のバランスが良い |
RTX 4090(24GB)など Blackwell より前の24GBクラス | GGUF 2bit、またはCPUへの一部オフロード | NVFP4はBlackwell向けで、4bit GGUFは約25GBの目安なので24GBではぎりぎり足りない可能性 |
L40S 48GB、RTX Pro 6000 | FP8 | モデルカードの最低構成 |
H100/H200/B200 | BF16またはFP8 | 精度を最大にしたい本番運用向け |
Mac・CPU中心の環境 | GGUF(llama.cpp) | 約25GB以上の統合メモリ・RAMが目安 |
GPUがない/まず試したい | OpenRouter無料版 | 機材なしで評価できる |
ローカル実行の機材選びはNVIDIA RTX Sparkとはも参考になります。
vLLMで動かす場合の最小手順
NVIDIAのDGX Sparkプレイブックとモデルカードでは、vLLM 0.20.0以上が必要とされています。音声入力を使うには vllm[audio] を追加でインストールします。
pip install "vllm[audio]>=0.20.0"
vllm serve nvidia/Nemotron-3-Nano-Omni-30B-A3B-Reasoning-NVFP4 \
  --max-model-len 131072
起動すると、ポート8000でOpenAI互換のAPIが立ち上がります。思考モードを切るときは、リクエストに chat_template_kwargs で enable_thinking: false を渡すのが一般的です。細かい起動オプションは環境で変わるため、最新のモデルカードで確認してください。
セルフホスト時に起きやすい不具合
症状・環境 | 対処(モデルカード・Unsloth) |
|---|---|
CUDA 13.2で出力が文字化けする | CUDA 13.0系を使う。vLLM公式コンテナは |
RTX Pro+FlashInferで不具合 |
|
DGX Sparkでメモリ不足 |
|
音声入力でエラー |
|
SGLangでFP8/NVFP4を使いたい | モデルカードはBF16のみ(他は対応予定)、SGLangのクックブックは3つとも掲載。最新のクックブックで確認 |
Ollamaは使える?
Ollama公式のXアカウントは「Ollama 0.22で利用可能」と告知しており、NVIDIAの開発者ブログも対応ランタイムにOllamaを挙げています。一方、Unslothのドキュメントには「Ollamaではマルチモーダル版のGGUFは動かない」という記載が残っています。対応の告知はあるものの、画像・音声までOllamaで使えるかは2026年10月時点で確認できていません。マルチモーダルを確実に使いたいなら、vLLMかllama.cppを選ぶのが無難です。Ollamaの基本はOllamaとはで解説しています。
用途別のおすすめ利用構成
用途 | おすすめの構成 | ポイント |
|---|---|---|
まず動作確認・評価 | OpenRouter無料版 | 機密データは入れない |
英語の文書・動画の大量処理 | 有料API(DeepInfra、Basetenなど) | 単価は各社で確認 |
社内の映像・音声を外に出さずに処理 | RTX 5090/DGX SparkでNVFP4をセルフホスト | NVIDIAはNemoClawと組み合わせた、データをローカルから出さない動画エージェントを例示している |
AWS内で完結させたい | SageMaker JumpStart | インスタンス料金のみ |
工場・ロボットなどエッジでの処理 | Jetson Thor | Jetson AI Labに手順あり |
精度を最大にしたい | BF16(H100以上) | 量子化による約0.4ポイントの低下も避けたい場合 |
ファインチューニング
NVIDIAのNeMo Megatron Bridgeで、Hugging Face形式との相互変換、フルSFT、LoRAができます。Unslothでも音声・画像・テキストを使った学習が可能ですが、動画入力での学習には対応していません。学習データの一部と学習用のコードも公開されています。
できないこと・注意すべき制約
出典: NVIDIA 技術ブログ
いちばん大きな制約は英語専用であることです。日本の業務でそのまま使うには、言語と出力の制約を前提に設計する必要があります。
制約 | 内容 |
|---|---|
英語のみ | モデルカードの対応言語は英語だけ。日本語で質問すると英語で返ることが多いと報告されている(Classmethodの検証) |
出力はテキストのみ | 画像・音声・動画は生成しない。音声で返したいなら別のモデルと組み合わせる |
動画は最大2分 | 長い動画は分割して渡す |
音声は最大1時間 | それ以上は分割が必要 |
PDFは直接読めない | ページごとに画像へ変換する |
思考モードが既定でオン | 単純な作業では遅くなり、トークンも増える。 |
既知の不具合 | CUDA 13.2での文字化けなど。修正状況は未確認 |
Ollamaでのマルチモーダル | 画像・音声が使えるかは未確認 |
学習データ | Qwen3-VLやgpt-oss-120bなど他社モデルで作った合成データを含むと公式に開示 |
日本語対応の現実
英語の画面・文書・音声を扱う業務なら、Nano Omniは強い選択肢です。日本語の資料や会話が中心なら、そのまま使うのはおすすめしません。
現実的な組み合わせは次のとおりです。
- 日本語のテキスト処理が要る: 日本語を含む6言語に対応したNemotron 3.5 Lightningや、多言語対応のQwen系・Gemma系と組み合わせる
- 英語UIの画面操作、英語の会議音声や動画の要約: Nano Omniで読み取り、日本語化は別のモデルに任せる
- 日本語音声の理解・応答まで1モデルで済ませたい: 日本語の音声入出力に対応したQwen3-OmniやQwen 3.5-Omniを検討する
社内システムに組み込む場合は、どのモデルにどの処理を任せるか、データをどこで処理するかで開発の規模と費用が大きく変わります。新しいモデルを業務システムに組み込むときの進め方と費用の目安は、AI開発の費用相場【2026年10月】AI受託開発の改修・PoC・本開発の価格と見積の内訳にまとめています。
ライセンスと安全面の注意
ライセンスは、Hugging FaceのモデルカードとAWSの記事では「NVIDIA Open Model Agreement」、NVIDIAの開発者ブログでは「NVIDIA Nemotron Open Model License」と書かれています。どちらも商用利用は可能です。ただし、Apache 2.0のように条件がほぼない形ではありません。後に出たNemotron 3 Ultraや3.5系はOpenMDW-1.1に移っていますが、Nano Omniが移行したという告知は確認できていません。商用利用の前に最新の条文を確認してください。
モデルカードには、運用上の注意として次の点が書かれています。
- 入力する画像・動画について、利用者が権利や許諾を持っている必要がある
- 業界や用途ごとの要件を満たすかは、開発者側で確認する
- バイアス・説明性・安全性・プライバシーの補足情報(Model Card++)がある
- 学習データはCSAMのスキャンと安全フィルタを通しており、EUのテキスト・データマイニング拒否(オプトアウト)を尊重している
映像や音声には、顔・声・会話内容といった個人情報が含まれやすい点にも注意が必要です。ローカル実行ならデータを外に出さずに済みますが、無料APIなどクラウド経由で処理するなら、提供元のデータの扱いを先に確認してください。
Qwen3-Omniとの比較
NVIDIAが論文で比べている相手は、AlibabaのQwen3-Omni(30B-A3B)です。さばける量とGPUメモリの効率ならNano Omni、日本語と音声での返答、ライセンスの自由度ならQwen3-Omniが有利です。
比較項目 | Nemotron 3 Nano Omni | Qwen3-Omni(30B-A3B) |
|---|---|---|
スループット(B200 1枚) | 長尺動画で9倍、複数文書で7.5倍(論文。NVFP4対FP8) | 基準 |
ライセンス | NVIDIA Open Model Agreement(商用可) | Apache-2.0 |
言語 | 英語のみ | テキスト119言語、音声入力19言語、音声出力10言語(日本語を含む) |
出力 | テキストのみ | テキスト+音声(Instruct版。Thinking版はテキストのみ) |
コンテキスト長 | 最大256K | 公式モデルページに明記なし |
メモリの目安 | NVFP4で重み約21GB、4bit GGUFで約25GB | BF16で15秒の動画に約79GB、120秒の動画に約145GB(Instruct、理論上の最小値) |
小型GPUでの動かしやすさ | RTX 5090 1枚から | BF16のままでは80GB級が必要 |
Qwen3-Omniは日本語の音声で質問し、音声で答えを返すところまで1モデルでこなせます。日本語の音声対話を作るならQwen3-Omniが有力で、英語の文書・動画を大量に読み取る処理基盤ならNano Omniが有力です。Qwen系の最新版はQwen 3.5-Omniとはで解説しています。
NVIDIAのNemotronシリーズでの位置づけ
2026年10月時点で、Nemotronには後続モデルが続々と出ています。その中で、テキスト・画像・動画・音声の4つを1モデルで入力できるのはNano Omniだけです。後継にあたる「Nemotron 3.5 Omni」は確認できていません。
モデル | 公開 | 規模 | 入力 | 特徴 |
|---|---|---|---|---|
Nemotron 3 Nano Omni | 2026年4月28日 | 30B-A3B | テキスト・画像・動画・音声 | 音声まで扱える唯一のNemotron。英語のみ |
Nemotron Nano V2 VL(前世代) | — | — | テキスト・画像・動画 | 音声なし |
Nemotron 3 Ultra | 2026年6月4日 | 550B-A55B | テキスト | 1Mコンテキスト。計画・実行役の大型モデル |
2026年8月11日 | 30B-A3B | テキスト | 1Mコンテキスト、日本語を含む6言語 | |
Nemotron 3.5 Super VL | 2026年10月15日 | 120B-A12B | テキスト・画像・文書・動画 | 画像・文書の精度重視。音声の記載なし |
2026年10月15日〜 | 74B-A9Bほか | — | 小型・エッジ向けの系列 |
選び分けの目安は次のとおりです。
- 音声を含めて1モデルで読み取りたい: Nano Omni
- 画像・文書の精度を最優先したい: Nemotron 3.5 Super VL。NVIDIAの開発者ブログでは、CharXivでSuper VLが80.8%、Nano Omniが63%
- テキストだけを速く、日本語でも扱いたい: Nemotron 3.5 Lightning
- エージェント全体の計画や実行を任せたい: Nemotron 3 Ultraなどの大型モデルを中心に置き、Nano Omniを読み取り役として組み合わせる
採用企業として、NVIDIAの公式ブログはAible、Applied Scientific Intelligence、Eka Care、Foxconn、H Company、Palantir、Pylerを挙げています。Dell Technologies、Docusign、Infosys、Oracleなども評価中としています。
こんな人におすすめ / おすすめしない人
こんな人・用途におすすめ
- 英語の文書・図表・画面を大量に読み取る処理を作りたい人(英文レポート、論文、海外製の業務アプリの画面操作など)
- 動画と音声をまとめて解析したい人(英語の会議録画の要約、監視映像と音のチェックなど)
- 映像・音声を社外に出さずに処理したい企業(RTX 5090 1枚から自社内で動かせる)
- AIエージェントの「目と耳」になる軽いモデルを探している開発者
- GPU1枚あたりの処理量を増やして、推論のコストを下げたいチーム
- まず無料で試したい人(OpenRouter無料版)
おすすめしない人・向かない用途
- 日本語の対話や日本語の文書処理が中心の人(英語専用。Nemotron 3.5 LightningやQwen系を検討)
- 音声で返答するアシスタントを1モデルで作りたい人(出力はテキストのみ。Qwen3-Omniなどが候補)
- 画像・文書の読み取り精度を最優先する人(Nemotron 3.5 Super VLの方が高い)
- 2分を超える動画を分割せずに処理したい人
- Ollamaだけで画像・音声まで手軽に動かしたい人(2026年10月時点で動作を確認できていない)
- Blackwellより前の24GB以下のGPUしかない人(4bit GGUFでもぎりぎり。2bit版かAPI利用を検討)
- Apache 2.0並みに条件の少ないライセンスが必要な人
よくある質問(FAQ)
Q. 日本語でも使えますか?
公式の対応言語は英語だけです。日本語で入力しても英語で返ることが多いと報告されています。日本語が必要な業務では、日本語対応のモデルと役割を分けるのが現実的です。
Q. ChatGPTやClaudeと何が違いますか?
ChatGPTやClaudeは重みが公開されていないクローズドなモデルで、クラウド経由で使います。Nano Omniは重みが公開されており、自社のGPUで動かせます。機密データを外に出さずに処理できるのが大きな違いです。一方、日本語の会話や汎用的な文章作成では、ChatGPTやClaudeの方が向いています。
Q. 25GBのメモリが必要ですか?
25GBは、Unslothの4bit GGUF版を動かすときの目安です。NVIDIA公式のNVFP4版は重みが約21GBで、最小構成はRTX 5090(32GB)1枚とされています。長い動画や文書を扱うと、コンテキストの分だけメモリが増える点にも注意してください。
Q. 「9倍速い」なら、手元のPCでも9倍速くなりますか?
なりません。9倍はB200 1枚で、多数のリクエストを同時に処理したときの総処理量の比較です(Nano OmniはNVFP4、Qwen3-OmniはFP8)。1件ずつ処理するときの出力速度の差は約2.4〜2.9倍で、GPUの世代が違えばさらに変わります。
Q. 思考モードはオフにできますか?
できます。既定はオンで、enable_thinking をfalseにすると切れます。画像の分類や文字起こしのような単純な作業では、オフにした方が速く、トークンも少なくなります。モデルカードの推奨は、思考なしで temperature 0.2 です。
Q. Nemotron 3.5が出た今、Nano Omniを選ぶ理由はありますか?
音声を含む4種類の入力を1モデルで扱いたいなら、2026年10月時点ではNano Omniが唯一の選択肢です。画像・文書だけなら3.5 Super VL、テキストだけなら3.5 Lightningの方が新しく、用途によっては精度も上です。
Q. 前世代「Nemotron Nano V2 VL」やテキスト版「Nemotron 3 Nano」とは別物ですか?
別のモデルです。Nano V2 VLは画像・動画・テキストを扱う前世代で、音声には非対応です。Nemotron-3-Nano-30B-A3B(名前にOmniがないもの)はテキスト専用で、Nano Omniの言語部分のもとになっています。
まとめ
NVIDIA Nemotron 3 Nano Omniは、テキスト・画像・動画・音声を1モデルで読み取れる、総約30B・アクティブ約3Bのオープンウェイトモデルです。2026年10月時点でも、音声まで扱えるNemotronはこのモデルだけです。
強みは、GPU1枚あたりの処理量とローカルで動かせる軽さです。B200上ではQwen3-Omniの最大9倍の量をさばけたと報告されており(NVFP4対FP8、1ユーザー50 tok/sの条件)、NVFP4版ならRTX 5090 1枚、4bit GGUF版なら約25GBのメモリが目安です。画面操作、長い英文資料の読み取り、動画と音声の理解で前世代から大きく伸びています。
弱点は、英語専用であることとテキストしか出力しないことです。日本語の業務では、Nemotron 3.5 LightningやQwen系と役割を分けて組み合わせる前提で考えてください。
まずはOpenRouterの無料版で、英語の資料や動画を使って評価するのが手軽です。業務データを扱う段階になったら、データの扱いを確認したうえで、有料APIかセルフホストに切り替えましょう。
関連記事
依頼範囲と費用の目安を30分で整理します
この記事の著者
AI革命
編集部
AI革命株式会社の編集部です。最新のAI技術動向から実践的な導入事例まで、企業のデジタル変革に役立つ情報をお届けしています。豊富な経験と専門知識を活かし、読者の皆様にとって価値のあるコンテンツを制作しています。
最新記事
Alexa+(アレクサプラス)とは?日本で提供開始|申し込み方法・料金(プライム無料/月額3,000円)・対応Echo・できること
2026/10/30
Mistral Large 4がオープンウェイト公開|ライセンス・API料金$0.70・必要GPU・GLM-5.3比較【2026年10月】
2026/10/30
Devin vs Claude Code 比較|料金・機能・使い分けの違いを徹底解説【2026年最新】
2026/04/12
DeepgramがDaily買収へ|Pipecatはどうなる?決まったこと・未定のこと・利用者別の対応
2026/10/30
OpenClawとは?できること・料金・使い方とClaude Codeとの違い【2026年最新】
2026/03/26
LINE公式アカウントの外部連携で予約・顧客管理とつなぐには|拡張ツールで足りる場合とMessaging APIで作る範囲・会員IDの紐付け
2026/10/15