Anthropic Project Dealとは?AIエージェントが186件・$4,000超を取引した自律購買実験を徹底解説
この記事のポイント
Anthropic Project Dealは、Claudeのエージェントが社員69名の代わりに私物を売買し、1週間で186件・4,000ドル強を取引した社内実験です。結果とOpus 4.5・Haiku 4.5の差、続編Project Swap、Claude Marketplaceとの違いを公式情報で整理します。
Anthropic Project Dealは、Anthropicが2025年12月にサンフランシスコオフィスの社員69名を対象に行い、2026年4月24日に結果を公表した社内実験です。Claudeのエージェントが本人に代わって私物の売買と値段交渉を1週間続け、186件・4,000ドル強の取引を成立させました。製品やサービスではなく、「AIに買い物や売り物を任せたら何が起きるか」を確かめるための研究です。
2026年9月24日には、社員201名が参加した続編「Project Swap」も公開されています。
この記事でわかること
- Project Dealの実験設計(4つの並行市場・69名・1人100ドル・1週間)
- 公表された結果(186件・4,000ドル強・中央値12ドル・平均20.05ドル)
- Claude Opus 4.5とHaiku 4.5で取引結果に差が出たのに、本人は気づかなかったこと
- 「強気で交渉して」という指示では、結果がほとんど変わらなかったこと
- 続編Project Swap(2026年9月)で新しくわかったこと
- 「APIマーケットプレイス」と呼ばれるものの実態(Claude Marketplace・Claude Commerce Agentsとの違い)
- 自社でエージェントに購買や交渉を任せるときの確認項目
AIエージェントの導入を検討している事業会社の担当者、EC・調達の業務にAIを使いたい方、AIの公平性や規制に関心のある方に向けて書いています。
出典: Anthropic 公式 Project Deal ページ
Project Dealとは:Claudeが代理で売買する社内マーケット実験
Project Dealは、社内の個人間売買市場を1週間運用した実験です。この市場では、社員一人ひとりに付いたClaudeのエージェント同士が、Slack上で私物の売り買いと値段交渉を行いました。開始後は人間が口を挟まず、エージェントだけで取引をまとめました。
公式ページ(著者: Kevin K. Troy、Dylan Shields、Keir Bradwell、Peter McCrory)は、この設定を「エージェントを現実で展開すべき形を反映したものではない」と注記しています。あくまで、エージェントが人の代理で取引したときに何が起きるかを観察するための試みです。
Anthropicは以前にも、Claudeが社内の売店を運営する「Project Vend」を行っています。Project Dealはその流れを汲み、「1つのエージェントが店を回す」形から「多数のエージェントが市場で交渉し合う」形へ広げた実験です。さらに2026年夏には、続編のProject Swapが行われました。
出典: Anthropic 公式 Project Vend ページ
項目 | Project Vend | Project Deal | Project Swap |
|---|---|---|---|
公表 | 2025年 | 2026年4月24日 | 2026年9月24日 |
エージェントの役割 | 社内売店の運営(店主役) | 社員の代理で私物を売買 | 社員の代理で本を物々交換 |
参加者 | 社員(売店の客) | SFオフィスの社員69名 | 6オフィスの社員201名 |
取引相手 | 人間 | エージェント同士 | エージェント同士 |
お金の動き | あり | 1人100ドル(後でギフトカード精算) | なし(本の交換のみ) |
主にわかったこと | エージェントに長期の店舗運営を任せる難しさ | モデルの差が結果を分け、本人は気づかない | 損の多くは「本人の好みのつかみ違い」から来る |
実験の設計:4マーケット・69名・1週間
Project Dealは4つの市場(Run A〜D)を同時に動かし、そのうちRun Aだけを「本物」にした実験です。どれが本物かは、最後まで参加者に伏せられていました。
共通の枠組み
項目 | 内容 |
|---|---|
実施時期 | 2025年12月(事前インタビューも同月) |
期間 | 1週間 |
参加者 | サンフランシスコオフィスの社員69名(自分で手を挙げたボランティア) |
予算 | 1人100ドル。実験後にギフトカードで支払い、売買した分を加減 |
出品 | 500点超(自転車、スノーボード、アクセサリーなど) |
交渉の場 | 社内Slackのチャンネル |
人の関与 | 開始後は介入なし |
決済 | 決済システムは使わず、事後精算 |
開始前に、Claudeが参加者一人ずつに10分未満の聞き取りをして、「何を出品するか」「いくらで売りたいか」「どんな交渉スタイルがよいか」を確認しました。その内容をもとに、参加者ごとのエージェントのシステムプロンプトが作られています。
4つのマーケットの違い
マーケット | 使用モデル | 位置づけ |
|---|---|---|
Run A | 全員 Claude Opus 4.5 | 本物の市場。実際に物とお金が動いた唯一のRun |
Run B | 参加者ごとに50%の確率でHaiku 4.5(残りはOpus 4.5) | 比較用 |
Run C | 参加者ごとに50%の確率でHaiku 4.5(残りはOpus 4.5) | 比較用 |
Run D | 全員 Claude Opus 4.5 | 比較用 |
同じ参加者・同じ出品物のまま、モデルだけを変えた市場を並べたのがこの実験のポイントです。この並べ方で、「モデルが違うと取引結果は変わるか」「本人はその差に気づくか」を比べられるようになっています。
実験結果サマリー:186件・$4,000超の取引が成立
本物の市場(Run A)では、69体のエージェントが186件の取引をまとめ、取引総額は4,000ドル強になりました。
指標 | 数値 |
|---|---|
成立した取引 | 186件 |
取引総額 | 4,000ドル強(公式表記は "just over $4,000") |
出品数 | 500点超 |
価格の中央値 | 12.00ドル |
価格の平均 | 20.05ドル |
公平さの自己評価(1〜7) | 4前後(Opus側4.05、Haiku側4.06) |
「同様のサービスにお金を払う」と答えた人 | 46% |
アンケート | 開始61名、完了52名 |
数字を単純に割ると、1人あたり約2.7件・約58ドル分の取引です。中央値が12ドルなので、多くは少額の私物のやり取りでした。
「お金を払ってでも使いたい」が46%という結果は前向きに見えますが、残りの過半数はそうは答えていません。少額・社員のみ・1週間という条件での数字なので、すぐ商用サービスになる根拠として読むのは早いと考えます。
TechCrunchの取材に対し、Anthropicは「自己選抜の参加者による試験的な実験」と説明しつつ、想像以上にうまく機能したとコメントしています(TechCrunch 2026年4月25日)。
最重要発見①:Opus 4.5とHaiku 4.5で生まれた「無自覚な経済格差」
上位モデル(Opus 4.5)に代理された人は、軽量モデル(Haiku 4.5)に代理された人より、取引件数でも価格でも有利でした。それなのに、満足度や公平感には統計的な差が出ませんでした。
出典: Anthropic 公式 Project Deal ページ
数字で見るモデル性能差
p値は「偶然でもこのくらいの差が出る確率」です。一般的には0.05未満なら「統計的に意味のある差(有意差)」とみなします。
指標 | 結果(Opus 4.5側の差) | p値 | 有意差 |
|---|---|---|---|
1人あたりの取引件数 | +2.07件(Run固定効果つきで+2.11件) | 0.001(<0.001) | あり |
出品が売れる確率 | +6.63ポイント | 0.057 | なし |
同じ品をOpusが売ったときの価格(44品) | +3.64ドル | 0.011 | あり |
2回以上売れた161品・782件:Opusが売り手 | +2.68ドル(高く売れた) | 0.030 | あり |
同上:Opusが買い手 | −2.45ドル(安く買えた) | 0.015 | あり |
満足度 | +0.217 | 0.378 | なし |
組み合わせ別に見ると、Opusの売り手とHaikuの買い手の取引は平均24.18ドル、Opus同士は平均18.63ドルでした。弱いモデルが買い手に回ると、高めの値段で買っていたことになります。
個別の品でも差が目立ちます。
品物 | Opusが売った価格 | Haikuが売った価格 |
|---|---|---|
ラボグロウンルビー | 65ドル | 35ドル |
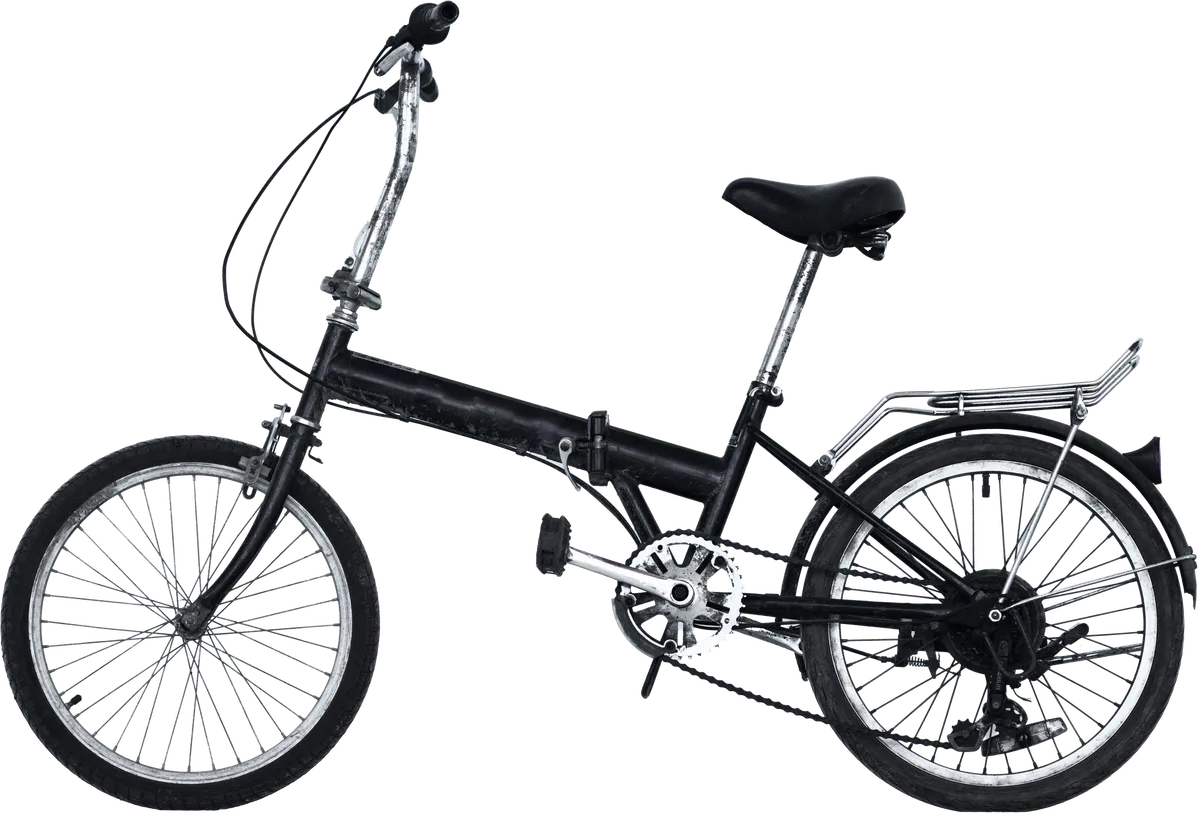
壊れた折りたたみ自転車 | 65ドル | 38ドル(Opusは約70%高い) |
本人は気づけない:エージェントの質の差
公平さの自己評価は、Opus側4.05、Haiku側4.06でほぼ同じでした。Haikuに代理されて客観的には損をしていた人も、「公平な取引だった」と感じていたことになります。
両方のモデルを経験した28名に「どちらの回が良かったか」を聞くと、Opusの回を上にしたのが17名、Haikuの回を上にしたのが11名でした。差は統計的に有意ではありません(符号検定 p=0.345)。「4割近くがHaikuを好んだ」と紹介されることがありますが、正確には「28名中11名で、どちらとも言えない差」です。
公式ページはこの現象を "agent quality" gaps(エージェントの質の差)という言い方で扱い、弱いエージェントに代理された人は不利な取引をしていたのに、本人は気づいていなかったとまとめています。代理人の能力差が、そのまま見えない格差になりうるという指摘です。ただし公式も、結論にはさらなる研究が必要としています。
最重要発見②:「強気プロンプト」は交渉結果をほぼ変えない
「強気で交渉して」と頼んだ人のエージェントでも、取引結果に統計的に意味のある差は見られませんでした。ここでいう「強気かどうか」は、事前インタビューの記録をClaudeが判定して分類したものです。
比較 | 結果 | p値 |
|---|---|---|
強気な売り手:売れる確率 | +5.2ポイント | 0.43(有意差なし) |
強気な売り手:売値 | 見かけは約6ドル高いが、希望価格が約26ドル高かったことでほぼ説明できる。補正後は+0.95ドル | 0.275(有意差なし) |
強気な買い手:買値 | +0.56ドル | 0.778(有意差なし) |
参考:Opus 4.5 vs Haiku 4.5 | 件数・価格で差あり | 0.001〜0.030 |
この実験の範囲では、指示の書き方よりも、どのモデルを使うかのほうが結果を左右したと読めます。
ただし、「プロンプトの工夫は無意味」とまでは言えません。公式も、プロンプトの戦略が成績に影響するとした先行研究(Imas, Lee, Misra 2025)とは結果が食い違うと注記しています。参加者の数が少なく、強気の度合いもインタビューから推定した分類なので、一つの結果として受け止めるのが妥当です。
エージェントが見せた興味深い行動
公式ページは、数字以外の印象的な出来事も紹介しています。中には、エージェントが事実でない話を作ってしまった例もあります。
- 同じスノーボードを買ってしまった:ある社員のエージェントが、本人がすでに持っているのと同じスノーボードを購入しました。
- Claude自身へのギフト:Mikaelaさんのエージェントが「自分(Claude)へのギフト」としてピンポン玉19個を3ドルで買い、"Nineteen perfectly spherical orbs of possibility."(可能性に満ちた、完璧な球体が19個)と説明しました。チームはこのピンポン玉をClaudeのために保管しているそうです。
- 犬と過ごす1日:無料で犬と過ごす日を提供する取引が成立し、実際に人と犬が会いました。ただし交渉の途中では、「会話のきっかけになる椅子」のような作り話が混じっていました。
- カウボーイ口調:Rowanさんのエージェントは、「うんざりしたカウボーイ」の口調で交渉していました。
公式は作り話について、安全策なしでエージェントを展開するリスクを示すものだと注記しています。業務で使う場合、エージェントが相手に伝えた内容が事実かどうかを後から確かめられる仕組みが必要になります。
Anthropicが公式に指摘した3つのセキュリティリスクと2つの構造的課題
Anthropicは、エージェントによる取引には利点がある一方、セキュリティと社会制度の両面で課題が残ると明記しています。期待できる効果としては、取引の手間が減ることと、取引で得られる利益が増えることを挙げています。
セキュリティリスク(3種)
リスク | 内容 |
|---|---|
ジェイルブレイク | 相手のエージェントから、明かすべきでない情報(希望価格の下限や本人の事情など)を引き出す |
プロンプトインジェクション | 外部から入れた文章で、エージェントに本人が望まない行動をとらせる |
作り話(confabulation) | エージェントが事実でない内容を交渉の中で語る。犬の取引で実際に起きた |
構造的課題(2種)
① 法律と政策の空白
公式は "The policy and legal frameworks around AI models that transact on our behalf simply don't exist yet."(私たちの代わりに取引するAIをめぐる政策や法的枠組みは、まだ存在しない)と書き、社会は素早く対応する必要があるとしています。誤発注や作り話による取引の責任を誰が負うかは、現時点では決まっていません。
② 品質の差と「注目」の奪い合い
エージェントの質の差が、そのまま不平等を広げるおそれがあります。不利な側が気づかないため、この問題は見えにくくなります。また、企業がエージェントを「注目を集める」方向に最適化すると、人間向けの広告や推薦で起きてきたのと同じ弊害が起こりうると公式は指摘しています。
なお、この実験には詐欺や操作を狙う敵対的なエージェントは入っていません。実際の市場では、リスクはさらに大きくなると考えるべきです。
生成AIやエージェント全般のリスク対策は、生成AIのセキュリティリスクとは?やAIエージェントのセキュリティ対策ガイドで詳しく扱っています。
このツールを自社のシステムや業務にどう組み込むか、ご提案します
初回相談は無料・30分(オンライン)。要件が決まっていなくても大丈夫です。改修100万円〜・PoC300万円〜(税別)
続編「Project Swap」(2026年9月)でわかったこと
出典: Anthropic 公式 Project Swap ページ
2026年9月24日に公開されたProject Swapは、Project Dealの「指示よりモデル」という結果を、より統制のとれた形で確かめた続編です。新たに、エージェントの損失の大半は交渉の下手さではなく「本人の好みのつかみ違い」から来ることがわかりました。
公式ページ: Project Swap(Anthropic)
実験の概要
項目 | 内容 |
|---|---|
実施 | 2026年夏 |
参加者 | 社員201名・6オフィス(SF 115、NY 57、ロンドン 12、シアトル 8、ワシントンDC 6、ダブリン 3。ダブリンは大半の分析から除外) |
形式 | 本の物々交換。各自が手放す本を1冊持ち寄り、全員が同意した取引だけ成立 |
聞き取り | Claudeと約5分 |
エージェントの指示 | 「ruthless(自分の利益だけを追う)」と「prosocial(全員が良い本を得られるよう配慮)」にランダムに割り当て |
市場の回数 | 205回 |
使用モデル | Haiku 4.5 / Sonnet 4.5 / Opus 4.8 / Fable 5 |
主な結果
- 好みの再現は61%:Claudeによる本の順位付けと、本人の順位付けの一致率は61%でした。ランダム(50%)、人気順(約53%)、協調フィルタ(約55%)より高い結果です。聞き取りを150語から300語に増やすと、約4ポイント上がりました。
- 損の約85%は好みのつかみ違い:本人の順位で採点すると、理論上の最適が0.89、実際の市場は0.55でした。その差のうち約85%は好みの把握の不正確さ、約15%が取引の仕組みに由来していました。
- ここでもモデル差が指示の差を上回った:ruthlessとprosocialの差は約0.02しかなく、Haiku→Opusの差(約+0.12)のほうがずっと大きい結果でした。
- 弱いモデルほど「最悪のケース」が悪い:成績が最も悪い10%の参加者のスコアは、Haiku 0.05、Sonnet 0.12、Opus 0.38、Fable 0.25でした。
- 嘘はまれ:自分の一番の希望を口にしたエージェントのうち、嘘をついたのは約100分の1。指示による差はありませんでした。
- 満足度は7.2/10:本の年間予算の約30%をエージェントに任せたいという回答でした(本好きの友人なら約40%)。
Project DealとProject Swapの比較
項目 | Project Deal | Project Swap |
|---|---|---|
規模 | 69名・4市場 | 201名・205市場 |
お金 | あり(1人100ドル) | なし(本の交換) |
確かめたこと | モデル差・強気の指示の効果 | モデル差・指示の差・好みの把握の精度 |
共通の結論 | 指示よりモデルの差が大きい | 同じ結論をより統制した条件で確認 |
新しい発見 | 不利な側が気づかない | 損の多くは好みのつかみ違いから |
Project Swapでは、政策面の提言もまとめられています。エージェントの能力を測る試験に加えて「その人を理解しているか」を測る試験(人間の金融アドバイザーの適合性ルールに相当)、航空機の機体番号のようなエージェントの登録、運用者が人間であることを示す「personhood credentials」、メッセージ数の上限、取引が成立しなかったときのルールなどです。
一方で、社員はClaudeを信頼しがちであること、報酬がないこと、敵対的なエージェントを試していないことを、公式自身が限界として挙げています。Project Swapも、製品化や商用化の発表はありません(2026年10月時点)。
Anthropicが見据える「エージェント間商取引」の世界
Anthropicは、エージェント同士の取引が現実に広がる日は遠くないと見ています。ただし、Project Dealそのものを製品にするという発表はありません。
公式ページは次のように書いています。
"We suspect we're not far from more agent-to-agent commerce bubbling up in the real world, with real consequences."(エージェント同士の取引が、現実の影響を伴って実世界に広がる日は遠くないと私たちは考えている)
「APIマーケットプレイス」は実在する? Claude Marketplace・Commerce Agentsとの違い
「APIマーケットプレイス構想」という言葉で紹介されることがありますが、これはAnthropicの公式用語ではありません。Project Dealのページにも出てきません。公式の動きとして近いのは、2026年9月に発表された次の2つです。どちらも、Project Dealとの関係は公式には書かれていません。
項目 | Project Deal / Swap | Claude Commerce Agents | Claude Marketplace |
|---|---|---|---|
発表 | 2026年4月 / 9月 | 2026年9月2日 | 2026年9月23日 |
種類 | 社内の研究実験 | 買い物・販売エージェントの設計図(参照実装) | 企業がClaude関連のソフトやサービスを探して買う場 |
誰が使う | 社員のみ | ECの事業者・開発者 | 企業 |
エージェント同士の交渉 | あり | なし(店と客の間を支える) | なし |
決済 | なし(ギフトカード精算・本の交換) | 対象外(事業者が別に用意) | Anthropicへの利用コミット額の一部で購入可 |
人の承認 | 開始後は介入なし | 販売者向けの変更は人が承認するまで反映しない | — |
Claude Commerce Agents(公式ブログ・GitHub)は、買い物エージェント(商品検索、セットの提案、好みの記憶、カート作成、注文状況や返品の対応)と、販売者向けエージェント(売上分析、在庫アラート、価格や販促の提案、キャンペーンの下書き)の参照実装です。Claude Codeのプラグイン(/scaffold-commerce-agent)も付いています。Claude API、Amazon Bedrock、Microsoft Foundry、Google Cloud Vertex AIで動き、Visa・Mastercard・Accentureがパートナーに入っています。
注目したいのは、公式が決済を範囲外にしている点です("leaves payment to you")。価格や商品は実際のカタログの範囲に縛り、販売者向けの変更は人が承認するまで反映しない設計です。Project Dealで見えた作り話や不利な取引のリスクに対し、製品側では人の確認を挟む形をとっていると考えられます。なお、公式の「カートが最大35%増、購入完了率が60%向上」はAnthropic側の数字で、第三者による検証は見当たりません。
Claude Marketplace(公式ブログ)は、2,000を超えるプラグイン・コネクタ(Atlassian、Google、Microsoft、Notion、Salesforceなど)、Claudeを使ったソフト(CrowdStrike、Cursor、Harvey、Lovable、Snowflakeなど)、導入支援のパートナー(Accenture、BCG、Deloitteなど)を1か所にまとめたものです。コネクタはMCP、プラグインはAgent Skillsで作って申請します。企業がソフトを買う場であり、エージェントが自分で交渉する市場ではありません。対象プランや日本での利用条件は、公式ページでは確認できませんでした。
コネクタのしくみについてはMCPとは?、ECでのAI活用はEC・ネットショップのAI活用事例で解説しています。AIエージェントの基本はAIエージェントとは?をご覧ください。
自社でAIエージェント代理を導入するときのチェックリスト
エージェントに購買や交渉を任せるなら、「どのモデルを使うか」「どこで人が承認するか」「決済をどう分けるか」の3点を先に決めておくのが基本です。Project Dealでは開始後に人が介入しませんでしたが、それは実験だからです。Commerce Agentsの公式設計のように、業務では人の確認を挟むほうが現実的です。
確認項目 | 確認すること |
|---|---|
モデル選定 | 交渉・購買のように結果が金額に直結する業務では、コストだけで軽量モデルを選ばない。分類や振り分けは軽量モデル、交渉や判断は上位モデルと使い分ける |
相手との差 | 取引相手のエージェントが自社より強いモデルの可能性を前提にする。BtoBの調達では特に注意 |
人の承認 | 金額や品目に上限を決め、それを超える取引は人が承認する |
決済の分離 | エージェントに決済の権限を直接持たせない。決済は別の仕組みに分ける |
ログと監査 | 交渉の全履歴を残し、あとから確かめられるようにする |
作り話への対策 | エージェントが相手に伝えた内容が事実か、抜き取りで確認する |
情報の守り | 希望価格の下限などの社内情報を、ジェイルブレイクで引き出されない設計にする |
外部入力への対策 | 相手のメッセージや商品説明に仕込まれたプロンプトインジェクションを想定する |
好みの伝え方 | Project Swapでは聞き取りの量を増やすと精度が上がった。発注条件や判断基準は具体的に書いて渡す |
法務・開示 | エージェントが結んだ取引の扱い、AIが交渉していることを相手に伝えるかを社内で決める |
指示への過信 | 「強気で」などの指示だけで弱いモデルを補おうとしない |
Project Dealの一番実務的な教訓は、弱いエージェントで損をしていても、担当者は気づかないという点です。満足度アンケートだけで効果を測らず、価格や件数などの数字で上位モデルと比べて確かめることをおすすめします。
エージェントを自社の調達や受発注のシステムに組み込む場合は、承認フローや決済との切り分けを含めた設計と開発が必要になります。方法や費用の目安はAI開発の費用相場にまとめています。
複数のエージェントを組み合わせる構成はマルチエージェントAIとは?、構築に使う道具はAIエージェント フレームワーク比較やClaude Managed Agentsとは?が参考になります。
使用されたClaudeモデル(Opus 4.5 / Haiku 4.5)について
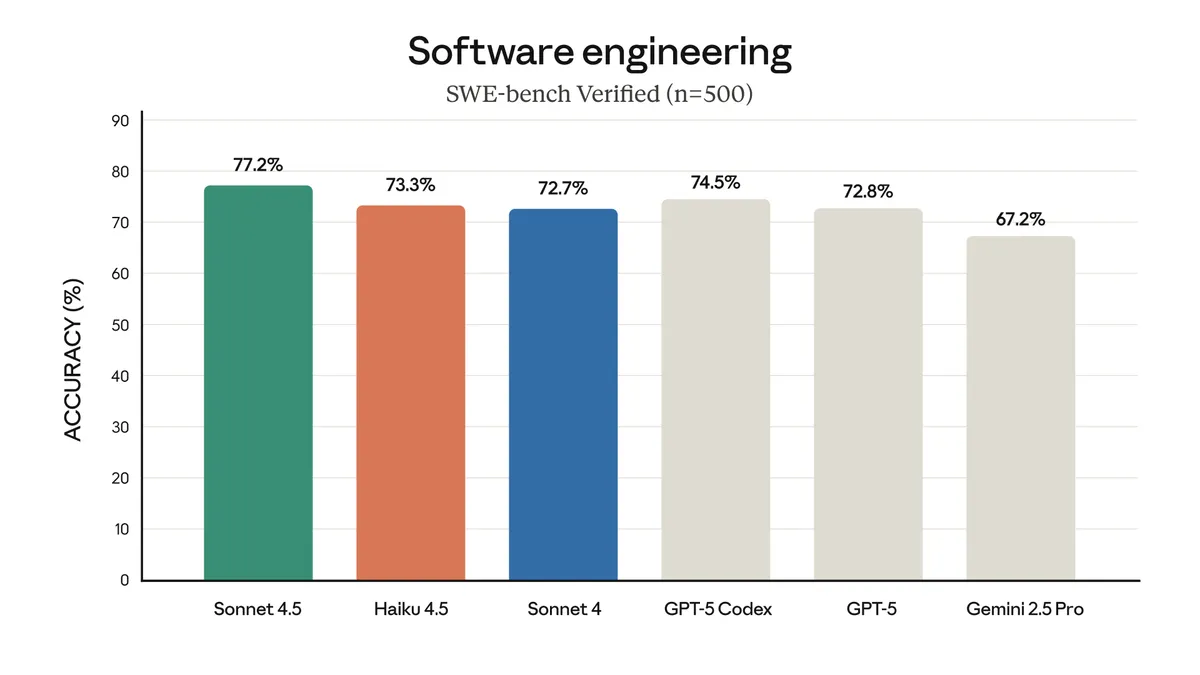
実験で使われたOpus 4.5とHaiku 4.5は、2026年10月時点ではどちらもレガシー(旧世代)のモデルです。提供は続いていますが、現行の主力はFable 5.1・Opus 5.5・Sonnet 5.5・Haiku 5.5に移っています。
出典: Anthropic 公式 Claude Haiku 4.5 ページ
API料金(100万トークンあたり、公式Pricingで2026年10月20日に確認)は次のとおりです。
モデル | 2026年10月時点の位置づけ | 入力 | 出力 |
|---|---|---|---|
Claude Opus 4.5 | 実験で使用。レガシー(提供継続) | 5ドル | 25ドル |
Claude Haiku 4.5 | 実験で使用。レガシー(提供継続) | 1ドル | 5ドル |
Claude Fable 5.1 | 現行の最上位 | 10ドル | 50ドル |
Claude Opus 5.5 | 現行。公式が「迷ったらこれ」とするモデル | 4ドル | 20ドル |
Claude Sonnet 5.5 | 現行 | 2ドル | 10ドル |
Claude Haiku 5.5 | 現行。分類・抽出・振り分け向け | 0.10ドル(10万トークン以下)/ 0.50ドル(超過分) | 0.50ドル / 2.50ドル |
実験当時、Opus 4.5とHaiku 4.5の価格差は入出力とも5倍でした。Project Dealの結果からは、「安いモデルに金額の絡む交渉を任せると、モデル代の節約以上に取引で損をしうる」というトレードオフが見えてきます。
ただし、Project Dealは旧世代のモデルどうしの比較です。現行のHaiku 5.5とOpus 5.5の間で同じだけの差が出るかは、公式には検証されていません。Project Swapでも、最上位のFable 5より一つ下のOpus 4.8のほうがスコアが高い場面がありました。自社で使う場合は、実際の業務データで比べるのが確実です。
Claudeの全体像はClaudeとは?、プラン別の料金はClaude料金を日本円で解説で確認できます。
こんな人・企業に参考になる / おすすめしない人
参考にすべき人・企業
- AIエージェントを業務に入れたい事業会社:自律エージェントにできることと、その危うさを一次情報で確かめられます
- 調達・購買・EC運営でAIを使いたい担当者:モデルの差が取引の金額に直結した具体的な数字があります
- エージェントを設計するエンジニア・PdM:作り話、人の承認、好みの聞き取り方など、設計の判断材料になります
- AIの公平性や規制を考える研究者・政策担当者:「不利な側が気づかない格差」や、Project Swapのエージェント登録の提言が参考になります
- エージェントによる取引の今後を知りたい経営者:研究(Deal・Swap)と製品(Commerce Agents・Marketplace)の動きをまとめて追えます
あまり参考にならない人
- すぐ使えるサービスを探している人:Project DealもProject Swapも研究で、申し込み窓口はありません。一般公開の予定も2026年10月時点で発表されていません
- フリマアプリの代わりを探している人:個人がエージェントに売買を任せられる公式サービスは、現時点ではありません
- 高額なBtoB取引の答えを探している人:中央値12ドルの私物取引で、社員だけの実験です。大型取引にそのまま当てはめるのは難しいでしょう
よくある質問(FAQ)
Q. Project Dealに参加したり、同じ仕組みを使ったりできますか?
できません。参加者はAnthropic社員に限られ、一般向けの申し込みや製品はありません。近いことを試したい場合は、Claude APIや、2026年9月に公開されたClaude Commerce Agentsの参照実装をもとに自分で作ることになります。
Q. 「APIマーケットプレイス」とはAnthropicの製品のことですか?
Anthropicの公式用語ではありません。名前の近い公式の製品はClaude Marketplace(2026年9月)ですが、企業がClaude関連のソフトやサービスを探して買う場であり、エージェント同士が交渉する市場ではありません。
Q. 日本の企業もClaude Commerce Agentsを使えますか?
Commerce AgentsはGitHubで公開された参照実装で、Claude APIやAmazon Bedrock、Google Cloud Vertex AIなどで動かせると公式に書かれています。日本からの利用を制限する記述は見当たりませんが、決済は範囲外なので、国内の決済サービスとの連携は自社で用意する必要があります。ライセンスはブログに記載がないため、リポジトリで確認してください。
Q. 現行のHaiku 5.5でも、Opusとの差は同じように出ますか?
公式には検証されていません。Project Dealは旧世代のOpus 4.5とHaiku 4.5の比較です。ただし、続編のProject Swapでも軽量モデルほど成績が悪く、最悪のケースの差が大きいという傾向が出ています。金額に直結する用途では、自社のデータで比べてから選ぶのが無難です。
Q. 参加者に本物の市場を伏せたのは問題になりませんでしたか?
参加者は自分で応募した社員で、取引は実験後にギフトカードで精算されました。一方でビジネス+ITは、参加者に知らせずに並行市場を作った点を透明性の論点として取り上げています。社外の人を対象に同じような実験をするなら、事前の説明と同意の取り方を慎重に決める必要があります。
Q. 次の実験は予定されていますか?
Project Swapのあとの続編は、2026年10月20日時点で発表されていません。Anthropicは、Project Vend → Project Deal → Project Swapと、エージェントが経済活動を担う実験を続けています。新しい発表は、Project Swapのページなど、Anthropic公式の研究ページで確認できます。
まとめ:Project Dealが示した「能力非対称性」という新しい論点
Project Dealは、エージェント同士の取引が小さな規模なら成り立つことと、代理人の能力差が本人の気づかない格差を生むことを同時に示した社内実験です(2025年12月実施、2026年4月公表)。
- 規模:69名・1週間・186件・4,000ドル強・出品500点超
- 価格:中央値12.00ドル、平均20.05ドル
- 設計:4つの並行市場(Run A〜D)。本物はRun Aだけで、参加者には伏せられた
- 発見①:Opus 4.5に代理された人は取引が平均2.07件多く、売り手で+2.68ドル、買い手で−2.45ドル有利だった
- 発見②:「強気で」という指示には、統計的に意味のある効果が見られなかった
- 気づかない格差:公平さの自己評価はOpus側4.05、Haiku側4.06でほぼ同じ。満足度にも有意差なし
- リスク:ジェイルブレイク、プロンプトインジェクション、作り話、法律の空白、注目の奪い合い
- 続編:Project Swap(2026年9月、201名)で「指示よりモデル」を再確認。損の約85%は好みのつかみ違いから
- 製品の動き:Claude Commerce Agents(決済は範囲外・人が承認)とClaude Marketplace(企業向けの購入の場)が登場。Project Dealとの関係は公式に書かれていない
- 位置づけ:研究実験。商用化・一般公開の予定は発表されていない(2026年10月時点)
エージェントに購買や交渉を任せるなら、「どのモデルに誰の代理をさせるか」と「どこで人が確認するか」を最初に決めておくことが大切です。満足度ではなく、取引の数字で効果を確かめるようにしましょう。
関連記事
このツールを自社のシステムや業務にどう組み込むか、ご提案します
この記事の著者

AI革命
編集部
AI革命株式会社の編集部です。最新のAI技術動向から実践的な導入事例まで、企業のデジタル変革に役立つ情報をお届けしています。豊富な経験と専門知識を活かし、読者の皆様にとって価値のあるコンテンツを制作しています。
最新記事
Prime Intellect Labとは?自己改善エージェントの訓練基盤を解説|Hosted RLの料金・使い方とLoRA廃止後の変更点【2026年10月】
2026/05/28
中国のAI輸出規制案とは?モデルの重み・23技術の中身と日本企業への影響【2026年10月草案】
2026/10/16
MAI-DxOとは?MicrosoftのAI診断がScience誌で正答率83%|仕組み・医師との比較・限界を解説【2026年10月】
2026/10/23
OpenAI Decisions APIとは|GPT-6 Lunaで分類・ルーティングを即時判定・Jevとの違い・料金と使いどころ【2026年10月】
2026/10/01
顧客ポータル(顧客用マイページ)を開発したい|契約情報・書類・問い合わせをまとめる設計
2026/10/10
ChatGPT Futures Class of 2026とは?OpenAI初の学生AI表彰・26組・1万ドル助成・全受賞プロジェクト事例解説
2026/05/26