Anthropicのエージェントメモリ設計とは?Dreaming研究の結果と記憶の書き方を解説
この記事のポイント
Anthropicが2026年11月6日に公開した研究「The components of agent memory」を解説します。何を残すかをモデルに任せた方が効く理由、Dreamingでメモを直しwikiを作った結果、Claude Code・Managed Agentsでの書き方、料金とメモリ汚染の注意点までまとめました。
Anthropicの研究「The components of agent memory」(2026年11月6日公開)の結論は、「何を覚えるかはClaude自身に判断させ、たまった記憶はDreaming(オフラインでの見直し)で直して整理する」です。 新しい機能の発表ではありません。Claude Code の auto memory や Claude Managed Agents のメモリストアに、何をどう書けば効果が出るのかを実験で確かめた研究記事です。
この記事でわかること
- 研究が扱う「エージェントメモリ」の定義と、記憶の4つの階層
- 「失敗だけ記録せよ」といった固定ルールで、かえって性能が落ちた実験結果
- Dreamingで誤ったメモを直し、wikiを作ったときの数値
- 結果を Claude Code・Managed Agents・Memory tool の設定にどう移すか
- 料金の目安と、メモリ汚染(プロンプトインジェクションの持ち越し)への対策
こんな方に向けた記事です
- Claude Code の CLAUDE.md や MEMORY.md の書き方を見直したい開発者
- Managed Agents でメモリを使うエージェントを作っている、または検討しているエンジニア・PdM
- 5月に発表された Dreaming が、実際どのくらい効くのかを知りたい方
研究の要点
- 強いモデルほど、何を残すかを任せた方が成績がよい。「失敗だけ記録」という固定ルールを与えると、メモリによる上積みが Opus 5 で0.234減った
- Dreaming は誤ったメモを直し、社内文書から wiki を作れる。ただし wiki は検索と組み合わせたときに最も成績がよく、1つの文書を探せば答えが出る課題では上積みがなかった
- 毎回読み込ませる最上位の記憶は小さく保ち、詳しい内容は下の階層へ移す。1つの対象(契約・顧客など)につき1ページに分け、原文は要約せず引用する
Dreaming という製品機能そのもの(API・申請方法・対応モデル)はClaude Dreamingとはで解説しています。この記事では、研究でわかった「記憶の設計」に絞ります。
「The components of agent memory」とは(研究の概要)

「The components of agent memory」は、Anthropicが2026年11月6日に公開した、エージェントの記憶の作り方についての研究記事です。著者は Lance Martin 氏で、トピックは Agents / Context engineering / Agent memory に分類されています(原文)。
この研究で新しく出た製品や料金はありません。すでにある次の仕組みを、どう使えば効果が出るかを裏づける内容です。
- Claude Code の auto memory(Claude が自分でメモを書く機能)
- Claude Managed Agents のメモリストアと Dreams(研究プレビュー)
- Messages API の memory tool
研究が言う「エージェントメモリ」の範囲
研究では、エージェントメモリを「Claude が経験から得て、セッションをまたいで残す知識」と定義しています。後で読み返せる文脈として保存されるものだけを指し、次の3つは含めません。
含めないもの | 理由 |
|---|---|
モデルの重みの更新(学習) | 記憶ではなくモデル自体が変わるもの |
コンテキスト内学習 | 1回の会話の中だけで完結するもの |
コンパクション | 古いやり取りを要約に置き換えて、同じ作業を続けるための仕組み |
コンパクションとメモリはよく混同されます。コンパクションは「今の作業を続けるために文脈を縮める」もの、メモリは「次のセッションで使う知識を残す」ものです。公式ドキュメントでは、両方を組み合わせて使うことをすすめています。
5月の Dreaming 発表との違い
2026年5月の Code with Claude では、Dreaming が Managed Agents の研究プレビューとして発表されました。このとき話題になった Harvey の「完了率約6倍」は製品発表時の事例です。今回の研究に出てくる Harvey LAB の評価(87%と73%)とは別の数字なので、混同しないようにしてください。
2026年11月8日時点でも、Dreams は申請制の研究プレビュー、メモリストアはベータのままです。
エージェントメモリの4つの階層とDreamingの役割
出典: Anthropic「The components of agent memory」
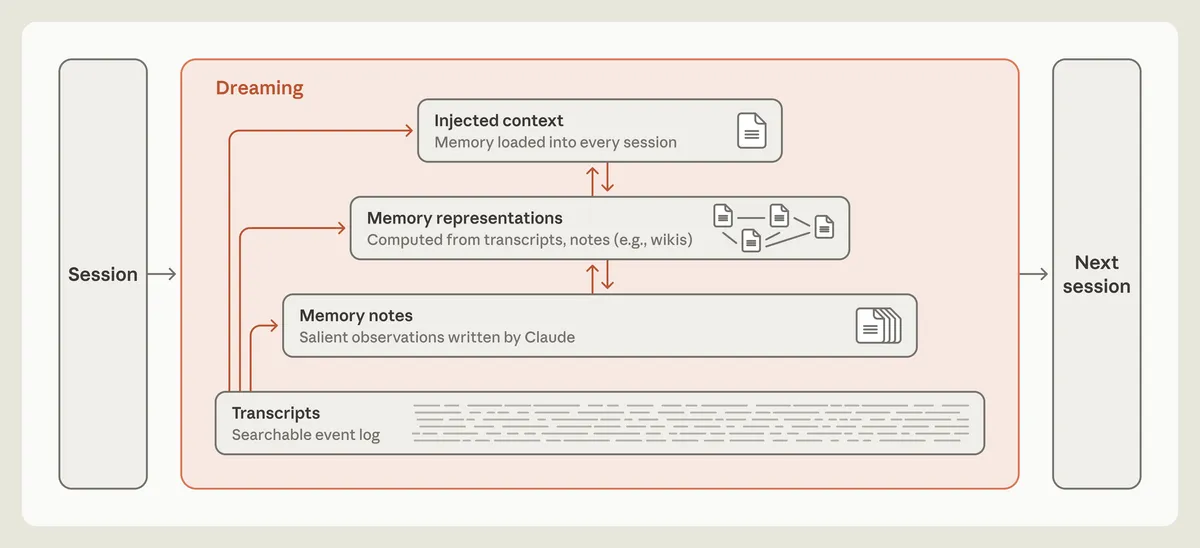
研究では、エージェントの記憶を4つの階層に分けています。Dreaming は、下の層にある情報を上の層へ引き上げ、その途中で誤りを直す処理です。
階層(下から上) | 中身 | 例 |
|---|---|---|
1. トランスクリプト | 検索できる出来事の記録 | 過去のセッションのやり取りそのもの |
2. メモ(memory notes) | Claude が書き残したメモ | 「このAPIは日付をUTCで返す」 |
3. メモリの表現 | 1つのテーマについて、互いにリンクしたページ群 | 社内システムの wiki |
4. 注入する文脈 | 毎セッションの開始時に必ず読み込む記憶 | Claude Code の MEMORY.md の先頭部分 |
上の層ほど毎回読まれるので、短く、正確である必要があります。下の層ほど量が多く、必要になったときに検索して読むものです。
Dreamingとは何をする処理か
研究での Dreaming は、作業していない時間にClaudeがログや会話記録を見直す処理です。睡眠中に海馬が記憶を再生する働きになぞらえて名づけられています。具体的には次の5つを担います。
- 誤ったメモを直す
- トランスクリプトから wiki などの新しい記憶の形を作る
- よく使うメモを上の階層(毎回読み込む文脈)へ引き上げる
- 特定の目的に合わせて記憶の焦点を絞る
- セッション中に書き漏らした内容を、記録を読み直して補う
作業中にメモを書くと、本来の作業から注意がそれます。Dreaming は、メモを書く作業を本来の作業の外へ出す考え方です。待ち時間に先回りで計算しておく研究(Letta と UC Berkeley の「Sleep-time compute」)や、Andrej Karpathy 氏の LLM wiki の考え方も参考として挙げられています。
研究でわかったこと①:何を残すかはモデルに任せた方が効く
出典: Anthropic「The components of agent memory」
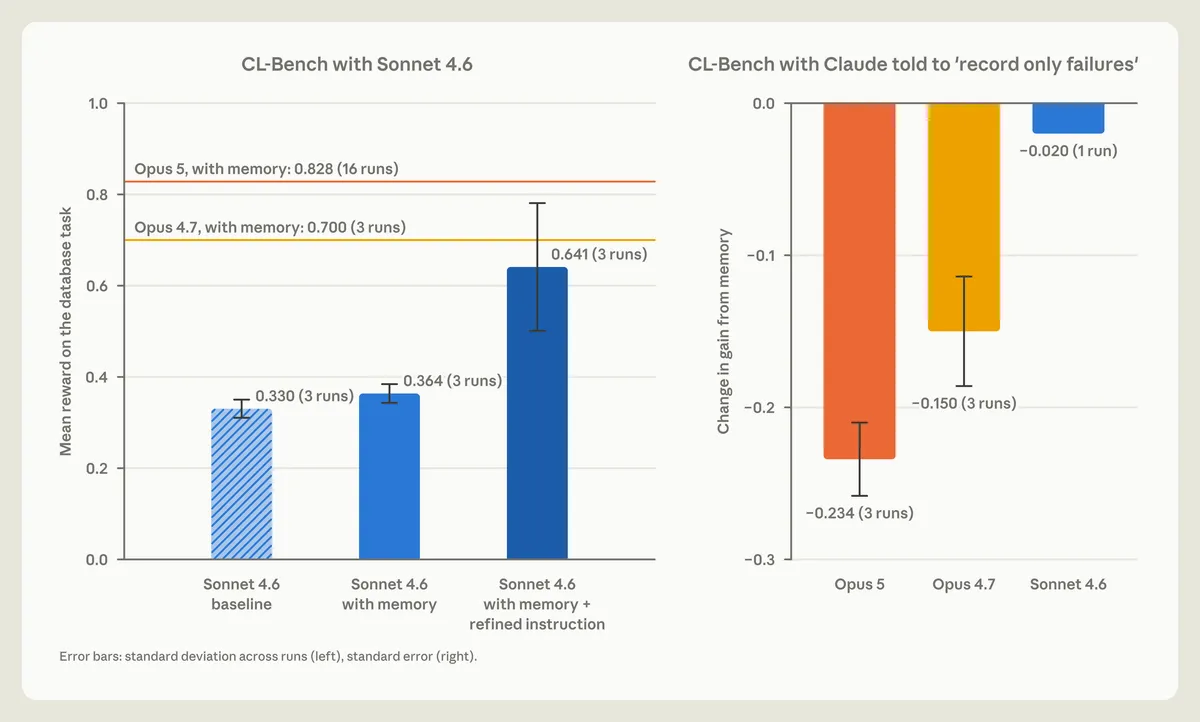
メモリを使うと成績は上がりましたが、「何を書くか」を人が細かく決めると、強いモデルほど上積みが減りました。 研究はこれを「強いモデルには、何が重要かを判断する自由を与える方が、固定ルールを先に決めるより効果的だった」とまとめています。
CL-Bench 1.0(データベース課題)の結果
次の表の値は平均報酬(0〜1)で、パーセントではありません。
モデル | メモリなし | メモリあり | 上積み |
|---|---|---|---|
Claude Opus 5.5 | 0.655 | 0.838 | +0.183 |
Claude Sonnet 5.5 | 0.644 | 0.833 | +0.189 |
Claude Opus 5 | 0.564 | 0.828 | +0.264 |
Claude Opus 4.7 | 0.383 | 0.700 | +0.317 |
Claude Sonnet 5 | 0.306 | 0.610 | +0.304 |
Claude Sonnet 4.6 | 0.330 | 0.364 | +0.034 |
Opus 5.5 はメモリなしでも0.655と高いため、上積みの幅は Opus 5 や Opus 4.7 の方が大きくなっています。
古いモデルは、メモリがあっても読まなかった
Sonnet 4.6 はメモリによる上積みがわずかでした。原因の1つは、回答する前にメモリを読んだのが半分未満だったことです。一方、Sonnet 5 は指示がなくても10回中9回メモリを読んでいました。
Sonnet 4.6 でも、メモリに加えて使い方の指示を細かく書くと、0.641まで上がりました。古いモデルには「回答前にメモリを読む」「仮説を確かめる」よう促す方がよい、ということです。
「失敗だけ記録せよ」で成績が落ちた
「失敗だけを記録する」という固定ルールを与えると、メモリによる上積みが次のように減りました。
モデル | 固定ルールによる上積みの減少 |
|---|---|
Opus 5 | −0.234 |
Opus 4.7 | −0.150 |
Sonnet 4.6 | −0.020 |
うまくいった手順や環境の特徴など、失敗以外にも残す価値のある情報があるため、と考えられます。CLAUDE.md やシステムプロンプトに「〇〇だけメモする」と書いている場合は、見直す価値があります。
研究でわかったこと②:メモは多ければよいわけではない
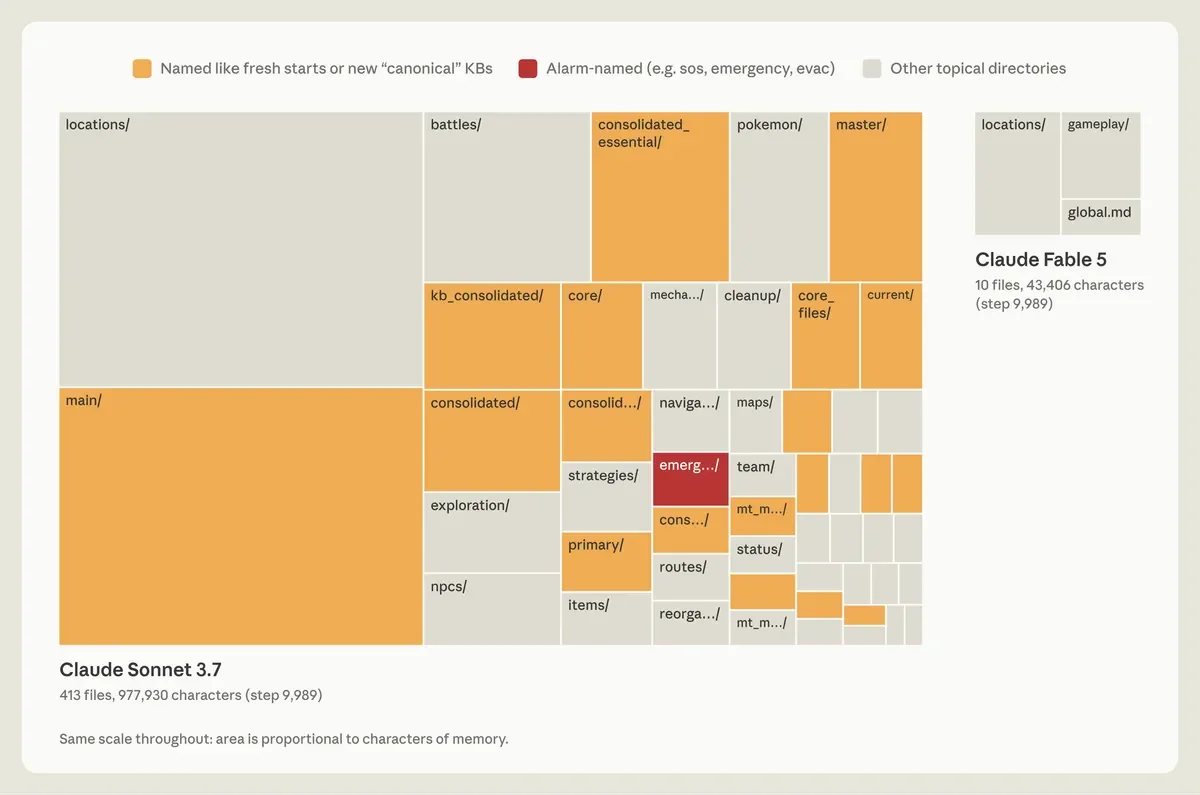
出典: Anthropic「The components of agent memory」
ゲーム「ポケットモンスター 赤」を遊ばせた実験では、メモの量と進み具合に大きな差が出ました。
モデル | メモの量 | 結果 |
|---|---|---|
Claude Sonnet 3.7 | 225フォルダに413ファイル(約97.8万文字) | バッジ1個 |
Claude Fable 5 | 2フォルダと | バッジ4個 |
Claude Opus 5.5 | 目標と次の一手を書く小さなフォルダだけ | クリア |
Sonnet 3.7 は1万ステップ付近で、ゲームを操作しないまま17ステップを使い、ファイルを6個作って9個消していました。メモの整理そのものが目的になってしまった例です。
ただし、この比較はモデルの世代とメモの量が同時に違います。「メモが少ないから強い」とまでは言えません。読み取れるのは、メモを増やすこと自体に効果はなく、目標と次の行動に絞った方が作業に集中しやすい、という傾向です。
研究でわかったこと③:Dreamingでメモを直し、wikiを作る
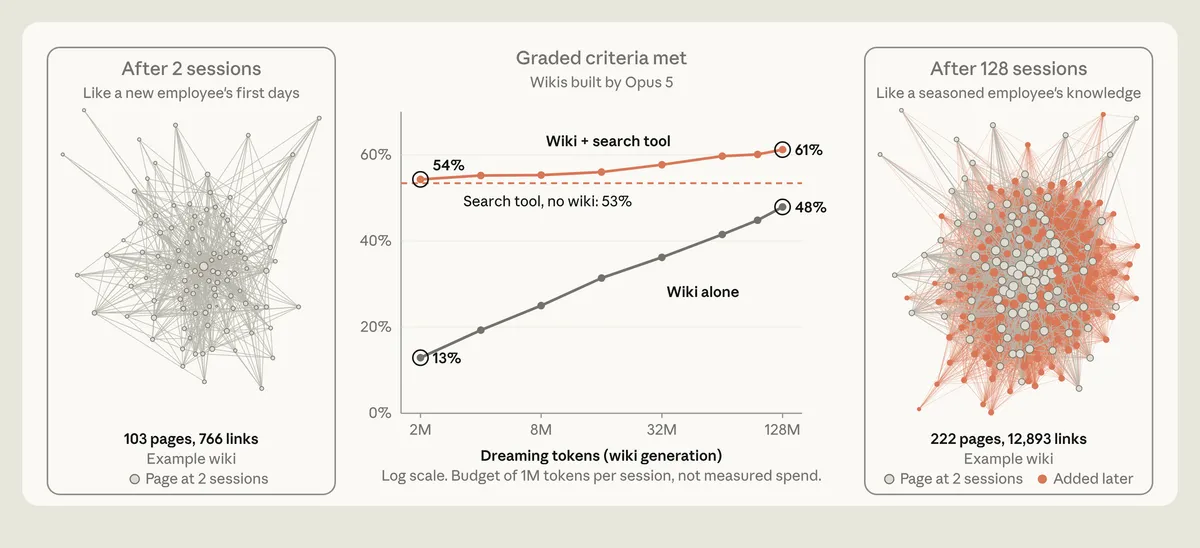
出典: Anthropic「The components of agent memory」
研究では、誤ったメモの修正、wiki の作成、記憶の書き方という3つの観点から、4つの実験で Dreaming の効果を確かめています。
誤ったメモを直した例(お月見山)
ポケモンの実験で、Claude がポケモンセンターの場所を誤ってメモし、段差から落ち続ける状態になりました。Dreaming でメモを直したところ、1,935アクション目でハナダシティに着きました。直さなかった場合とメモリなしの場合は、山を越えられませんでした。
ただし、これは1回の試行の結果です。
社内文書から wiki を作った例(Stainless)
API用SDKを作る Stainless 社の社内資料(約35万ファイル・約4.2億トークン)で、25問に答えさせた実験です。
条件 | 採点基準の達成率 |
|---|---|
wiki だけ(Dreaming 2セッション分) | 13% |
wiki だけ(Dreaming 128セッション分) | 48% |
検索だけ | 53% |
wiki と検索の併用 | 61% |
Dreaming に渡すセッションを増やすと、wiki は103ページ・766リンクから222ページ・12,893リンクに増え、成績も上がりました。それでも wiki だけでは検索に届かず、両方を使ったときが最もよい結果でした。併用すると1問あたり約2万トークン少なく済んでいます。
検索(RAG)と wiki 型の記憶の違いは、RAGとはで基本から解説しています。
複数の文書をまたぐ質問で差が出た例(Harvey LAB)
法律AIの Harvey が用意した、合併に関わる24問の評価では、複数の文書をまたいで判断や計算が要る質問で、wiki が87%、検索だけが73%でした。
一方、1つの文書を探せば答えが見つかる課題では、wiki の明確な上積みはありませんでした。別の課題では、wiki が元の資料(115KB)の1.77倍(68ページ・255リンク・203KB)に膨らんでいます。wiki は「複数の資料をつなぐ」用途で役に立ち、「探せば見つかる」用途ではコストに見合わないことがあります。
書き方で記録の漏れが変わった例(契約条件)
複数の契約から条件を抜き出す課題では、記憶の書き方によって残った項目数が大きく変わりました。
書き方 | 残った項目 |
|---|---|
複数のエージェントが1つの共有表に書く | 57項目中41項目(72%) |
契約ごとに1ページ、条件は原文のまま引用 | 57項目中57項目(100%) |
共有表では、エージェント同士が互いの書き込みを上書きしていました。さらに2回目の Dreaming で、切れたリンク9本を張り直し、ページを3つ足しています(38項目・225リンクから41項目・278リンクへ)。
研究の限界と、数字を読むときの注意
研究記事自身が「メモリの設計については、まだ学ぶことが多い」と書いています。自社の業務に当てはめる前に、次の点を押さえてください。
限界 | 内容 |
|---|---|
書くタイミング | 作業中に書くと注意がそれる。Dreaming は裏で動くが、結果がすぐ使えるとは限らない |
正確さと劣化 | メモは最初から間違っていることも、環境が変わって古くなることもある。すべてを検証するのは現実的でない場合がある |
注入のコスト | 毎回読み込む記憶はトークンを使い、指示が長いほど守られにくくなる |
wiki の肥大化 | 元の資料より大きくなり、あまり抽象化されないことがある |
根拠の範囲 | CL-Bench は1つのデータベース課題、ポケモンは1回の試行。コーディングなど別の作業では方向感として扱う |
Stainless と Harvey LAB の数値は「採点基準の達成率」で、正答率ではありません。また、外部の解説記事(dev.to の Gabriel Anhaia 氏の記事など)が指摘するとおり、自社で試すときは「エージェントが実際にメモリのファイルを開いたか」も確かめる必要があります。Sonnet 4.6 の例のように、メモリを置いても読まれないことがあるためです。
研究から導く、エージェントメモリの書き方7つ
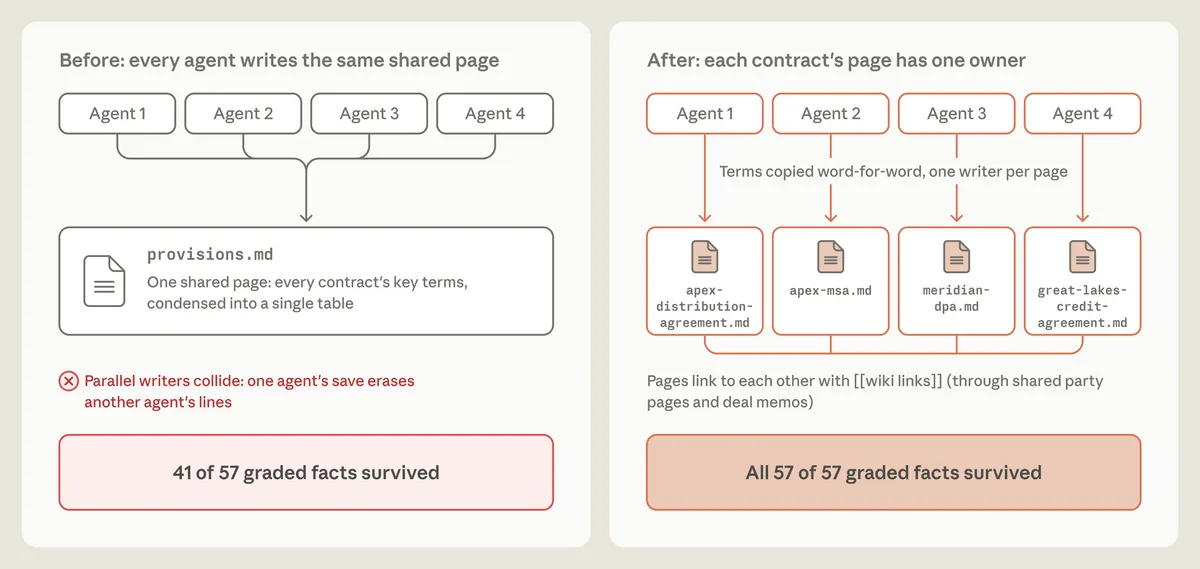
出典: Anthropic「The components of agent memory」
研究の結果と公式ドキュメントの推奨を合わせると、記憶の書き方は次の7つに整理できます。
# | 書き方 | 根拠 |
|---|---|---|
1 | メモリが何のためにあるかは伝え、どう使うかは細かく決めない。いつ書くかの簡単な目安だけ渡す | CL-Bench で強いモデルほど自由に判断させた方がよかった |
2 | 「失敗だけ記録」のような固定ルールを書かない | Opus 5 で上積みが0.234減った |
3 | 古いモデルには「回答前にメモリを読む」「仮説を確かめる」と書く | Sonnet 4.6 は指示を足すと0.364→0.641 |
4 | 毎回読み込む最上位の層は小さく保ち、詳細は下へ移してリンクだけ残す | 注入のコストと、長い指示ほど守られにくいこと |
5 | 1つの対象(契約・顧客など)につき1ページ。原文は要約せず引用する。共有表にまとめない | 契約課題で41/57→57/57 |
6 | トランスクリプトの検索と wiki を併用する。wiki は複数文書の統合に使う | Stainless で併用61%、Harvey LAB で87%対73% |
7 | Dreaming は変わりやすい情報に絞り、メモリが参照される頻度に合わせて実行の間隔を決める | wiki の肥大化とコストが入力量に比例すること |
「使い方を細かく決めない」と「古いモデルには読み方を書く」は矛盾して見えますが、使うモデルで分ければ整理できます。Sonnet 5 や Opus 5 のように指示がなくてもメモリを読む新しいモデルには目的だけを伝え、Sonnet 4.6 のような前の世代のモデルには、読み方まで書き添えます。
このツールを自社のシステムや業務にどう組み込むか、ご提案します
初回相談は無料・30分(オンライン)。要件が決まっていなくても大丈夫です。改修100万円〜・PoC300万円〜(税別)
Claudeで使える4つのメモリの仕組みの比較
研究の考え方を試せる仕組みは、Claude には現時点で4つあります。提供状況・保存場所・上限が違うので、用途に合わせて選びます。
出典: Claude Platform Docs「Dreams」
項目 | Claude Code auto memory | Managed Agents メモリストア | Managed Agents Dreams | Memory tool(Messages API) |
|---|---|---|---|---|
提供状況 | 提供中(ローカルのセッションでは既定でオン) | ベータ( | 研究プレビュー(申請制。 | 安定版(ベータヘッダー不要) |
誰が書くか | Claude | エージェント(API・Console から人も編集できる) | Claude が非同期のジョブで作り直す | Claude が要求し、自社のアプリが実行する |
保存場所 | 端末の | Anthropic 側(ワークスペース単位)。セッション内では | 新しい出力用のメモリストア | 自社のストレージ |
主な上限 |
| 1メモリ100KB(約2.5万トークン)、1ストア1万件、1セッション8ストア | 入力セッション1〜100件 |
|
ZDR | ─ | 対象外 | 対象外(HIPAAも対象外) | 対象(HIPAAも対象) |
研究の4階層での位置 | 注入する文脈とメモ | メモとメモリの表現 | 階層を上へ引き上げる処理 | メモ(保存先は自由) |
消費者向けの Claude アプリ(チャット・Cowork)のメモリは、これらとは別の仕組みです。そちらはClaude Coworkのメモリ機能で解説しています。
環境別:研究の結果を設定に移す方法
使っている環境ごとに、研究の結果を設定へ置き換えると次のようになります。
環境 | すること | 避けること |
|---|---|---|
Claude Code | CLAUDE.md に「メモリを何に使うか」を短く書く。MEMORY.md は索引にして、詳細はトピックごとのファイルへ | 「失敗だけ記録」のような固定ルール。MEMORY.md に長文を書く |
Managed Agents | ストアをユーザーごと・共有知識・プロジェクトごとに分ける。参照用は | 大きな汎用ストアを1つだけ作る。全セッションを |
Dreams | 少数のセッションで試し、出力ストアを元のストアと比べてから差し替える | 出力を確認せずに本番のストアと入れ替える |
Memory tool(自前) | パスの検証、ファイルサイズの上限、長く使われないファイルの定期削除を入れる |
|
Claude Code の場合
Claude Code は、人が書く CLAUDE.md と、Claude が書く auto memory の2本立てです。どちらもセッションの開始時に読み込まれ、公式ドキュメントでは「強制力のある設定ではなく、文脈として扱われる」と説明されています(公式ドキュメント)。
auto memory が保存するメモは、frontmatter の type で次の4種類に分かれます。
type | 中身 |
|---|---|
| 役割・得意分野・好み |
| 受けた訂正と、確認できた方針 |
| コードや git の履歴からは分からない作業・期限・決定 |
| 課題管理やダッシュボードなど、外部の情報の場所 |
コードを読めば分かること(構成・ファイルパス・修正したバグ)や、CLAUDE.md に書いてあることは保存されません。毎回必ず保存されるわけでもありません。
研究の「最上位は小さく」に当たるのが、MEMORY.md の読み込み上限です。先頭200行か25KBまでしか読み込まれないため、MEMORY.md は索引にして、中身はトピックごとのファイルに分けます。上限を超えても書き込みは通りますが、超えた部分は次のセッションで読まれず、索引を書き直すよう促すエラーが返ります。
CLAUDE.md も、公式では1ファイル200行未満が目安です。一部のコードにしか関係しない指示は .claude/rules/ のパス指定ルールへ移します。CLAUDE.md の具体的な書き方はCLAUDE.mdの書き方、Claude Code そのものはClaude Codeとはを参照してください。
そのほかの操作は次のとおりです。
- オン/オフ:
/memoryのトグル(autoMemoryEnabled)か、環境変数CLAUDE_CODE_DISABLE_AUTO_MEMORY=1 - 保存先の変更:
autoMemoryDirectory - 共有の範囲: 同じ git リポジトリの worktree とサブディレクトリでは1つのメモリを共有する。別の端末とは共有されない
- サブエージェント: それぞれ専用の auto memory を持てる(サブエージェントの使い方)
メモリは文脈なので、必ず止めたい操作(本番環境への書き込みなど)はメモリに頼らず、PreToolUse フックで止めます。フックの設定はClaude Code Hooksの使い方で解説しています。
Managed Agents の場合
Managed Agents のメモリストアは、ワークスペース単位のテキスト文書の集まりです。公式は「大きな汎用ストアを1つ作るより、ユーザーごと・共有知識・プロジェクトごとに小さく分ける」「少数の大きなファイルより、焦点を絞った小さなファイルを多く」とすすめています(公式ドキュメント)。研究の「1対象1ページ」と同じ考え方です。
運用で知っておきたい仕様は次のとおりです。
- ストアはセッションを作るときにだけ付けられる。実行中の付け外しはできない
- 変更のたびに変更できない版(メモリバージョン)が作られ、30日保持される。専用の復元APIはなく、古い版の内容を書き戻す
content_sha256を条件にした書き込みで、同時に書いたときの上書きを防げる。契約課題で起きた「共有表の上書き」への対策になる- ストアの archive は元に戻せない。delete はすべてのメモリと版を完全に消す
Dreams は、既存のメモリストア1つと過去のセッション1〜100件を読み、別の新しいメモリストアを作ります。入力のストアは変わらないので、出力を比べてから採用できます。instructions で「コーディングの好みに絞る」のような方向づけはできますが、「X行目をYに変える」といった細かい編集は効きません。個別の修正はメモリストアのAPIで行います(公式ドキュメント)。Managed Agents 全体の仕組みはClaude Managed Agentsとはで解説しています。
Dreams を使わずに同じ処理を組みたい場合は、公式 Cookbook の「Dreaming with a dynamic workflow」や、claude-quickstarts の managed-agents/knowledge-wiki の例が参考になります。
Memory tool で自前実装する場合
Messages API の memory tool は、{"type": "memory_20250818", "name": "memory"} で指定します。コマンドは view / create / str_replace / insert / delete / rename の6つで、実際のファイル操作は自社のアプリ側で行います(公式ドキュメント)。
ツールを付けると、APIが「最初にメモリのディレクトリを確認する」という指示をシステムプロンプトに自動で足します。研究で古いモデルに効果があった「先にメモリを読む」が、最初から組み込まれている形です。
長い開発作業を複数のセッションに分ける場合、公式は次の流れを紹介しています。
- 最初のセッションで、進捗のログと機能のチェックリストを作る
- 次のセッションからは、それを読み込んで作業を再開する
- セッションを終える前に更新する
- 1つの機能ずつ、最後まで動作を確かめてから完了にする
料金の目安
研究記事そのものに料金はありません。関係する製品の料金は、2026年11月8日時点の公式料金ページで次のとおりです。
仕組み | 料金 |
|---|---|
Claude Code auto memory | Claude Code の利用料金(サブスクリプションかAPI)の範囲内。メモリに別料金はない |
Managed Agents | モデルのトークン料金+セッションの実行時間 $0.08/時間( |
Dreams | 選んだモデルの通常のトークン料金。専用の追加料金の記載はない。コストは入力するセッションの数と長さにほぼ比例 |
メモリストアの保管 | 公式の料金ページに記載なし |
Memory tool | ツール自体の追加料金の記載なし。保存先は自社なので、保管のコストは自社持ち |
Managed Agents は、次のメッセージや承認を待っている idle の間は実行時間の課金がありません。Batch API の割引は対象外で、inference_geo を "us" に固定するとトークン料金が1.1倍になります。
Dreams に対応する主なモデルのトークン単価(100万トークンあたり)は次のとおりです。
モデル | 入力 | 出力 | Dreams |
|---|---|---|---|
Claude Fable 5 / 5.1 | $10 | $50 | 対応 |
Claude Opus 5 | $5 | $25 | 対応 |
Claude Opus 5.5 | $4 | $20 | 対応 |
Claude Sonnet 5.5 / Sonnet 5 | $2 | $10 | 対応 |
Claude Haiku 5.5(10万トークン以下) | $0.10 | $0.50 | 非対応(メモリストアは対応) |
Dreams 1回あたりの具体的な費用の例は、公式には示されていません。公式は「少数のセッションから始め、整理の質に納得してから増やす」ことをすすめています。研究プレビュー中のレート制限の数値も公開されていません。Claude 全体の料金はClaudeの料金プランでまとめています。
セキュリティ上の注意点:メモリ汚染は次のセッションに持ち越される
記憶の仕組みで最も気をつけたいのは、プロンプトインジェクションで書き込まれた内容が、次のセッション以降も「信頼できる記憶」として読まれることです。 1回の会話で終わる攻撃と違い、被害が後から何度も表に出ます。

出典: Anthropic 公式サイト
公式が警告していること
Managed Agents の公式ドキュメントは、メモリストアが既定で read_write(読み書きできる)で付く点を警告しています。利用者の入力、取得したWebページ、外部ツールの出力など、信頼できない入力を扱うエージェントが攻撃を受けると、悪意のある内容がストアに書き込まれます。参照用の資料や共有データなど、書き換える必要のないストアは read_only にするよう求めています。
Dreaming はそのストアと過去のセッションを読んで整理するため、汚れた記述が混ざったままだと、もっともらしい知識としてまとめ直されるおそれがあります。
対策の一覧
対策 | 対象 | 内容 |
|---|---|---|
| Managed Agents | 書き換え不要なストアは読み取り専用に。書く必要のあるセッションだけ |
出力を人が確かめる | Dreams | 入力のストアは変わらないので、差分を見てから差し替える |
版の履歴と redact | Managed Agents | 30日分の版で書き戻せる。漏れた秘密情報や個人情報は redact で履歴から消す(最新の版は redact できない) |
パスの検証 | Memory tool |
|
機密情報の除去 | 全般 | Claude は通常、機密情報の記録を断るが、確実にするなら書き込む前に除去する処理を入れる |
サイズと期限 | Memory tool | ファイルサイズに上限を設け、長く使われないファイルは定期的に消す |
保存先の信頼 | Claude Code | リポジトリ側の設定が |
データの扱いにも注意が要ります。Managed Agents(メモリストアと Dreams)は Zero Data Retention(ZDR)と HIPAA の対象外で、セッションの記録は削除するまで残ります。規制のあるデータを扱うなら、ZDR の対象になる Memory tool で、自社のストレージに保存する方法が候補になります。
Claude Code 全般の安全な使い方はClaude Codeのセキュリティ対策で解説しています。
社内の業務に組み込むとき
記憶を持つエージェントを社内の業務で動かす場合、メモリの差分を確認する画面、書き込み権限の管理、誤った記憶を戻す手順まで用意しておく必要があります。エージェントを試すだけでなく、自社の業務で承認・停止・再実行まで含めて動かすときに何を作り足すかは、AIエージェントの本番導入で追加する開発範囲で整理しています。
こんな人におすすめ/おすすめしない人
研究の結果を見ると、記憶の仕組みが効く場面とそうでない場面ははっきり分かれます。
こんな人・チームにおすすめ
- 同じ種類の業務を、長い期間エージェントに繰り返し任せている
- 契約書や社内文書など、複数の資料をまたいで判断する調査をさせたい
- Claude Code の CLAUDE.md や MEMORY.md が長くなり、指示が守られにくくなってきた
- Managed Agents のメモリに重複や古い記述がたまってきた
- Dreaming の出力を人が確認してから差し替える手順を作れる
おすすめしない人・チーム
- 1回きりの作業が中心で、記憶がほとんどたまらない
- 1つの文書を全文検索すれば答えが見つかる用途(wiki を作っても上積みがなかった)
- ZDR や HIPAA が必須の業務に、Managed Agents のメモリストアや Dreams を使おうとしている
- 信頼できない外部の入力を多く扱うのに、すべてのストアを読み書き可能にしたい
- 研究プレビューの Dreams を、すぐに稼働保証が要る本番業務に入れたい
迷ったときの選び方
状況 | まず試すこと |
|---|---|
Claude Code を個人やチームで使っている | auto memory をオンのまま、CLAUDE.md の固定ルールを見直し、MEMORY.md を索引にする |
API で自前のエージェントを作っている | Memory tool から始める。保存先を自社で持てて ZDR の対象になる |
Managed Agents でエージェントを動かしている | ストアを用途別に分け、参照用を |
Managed Agents の記憶が散らかってきた | Dreams を申請し、少数のセッションで出力を比べる |
AIエージェントの基本はAIエージェントとは、Claude 全体の位置づけはClaudeとはで解説しています。
よくある質問
Q. この研究で Claude に新しい機能が増えたのですか?
増えていません。2026年11月6日の研究記事は、既存のメモリの仕組みをどう使えば効くかを確かめた内容です。Dreams は申請制の研究プレビュー、メモリストアはベータのままで、料金の変更もありません。
Q. Claude Code でも Dreaming は使えますか?
Dreams は Managed Agents(Claude API)の機能で、公式ドキュメントでは対応先が Claude API のみとされています。Claude Code の auto memory は端末のファイルに書く仕組みで、Dreams とは別のものです。Claude Code では、研究の考え方(固定ルールを書かない、MEMORY.md を索引にする)を設定に取り入れる形になります。
Q. メモリを増やすと、トークンの消費も増えますか?
毎回読み込む記憶の分だけ増えます。研究も、注入する記憶はトークンを使い、指示が長いほど守られにくくなると書いています。Claude Code の MEMORY.md が先頭200行か25KBまでしか読まれないのは、このコストを抑えるためです。
Q. 自社の業務でも、CL-Bench のような上積みが出ますか?
同じ幅になるとは限りません。CL-Bench の数値は1つのデータベース課題の結果です。試すときは、決まったタスクの組で「メモリあり・なし」を比べ、エージェントが実際にメモリのファイルを開いているかも記録してください。
Q. 日本語の社内文書でも wiki 型の記憶は作れますか?
研究と公式ドキュメントには、日本語での品質についての記載がありません。対応モデルは日本語を扱えますが、社内の略語や専門用語がどうまとめられるかは、少ない文書から試して確かめるのが確実です。
まとめ
- Anthropicの「The components of agent memory」(2026年11月6日)は、新機能ではなく、エージェントの記憶の書き方を実験で確かめた研究
- 記憶は、トランスクリプト、メモ、wiki などのメモリの表現、毎回注入する文脈の4階層。Dreaming は下から上へ引き上げ、途中で誤りを直す
- 強いモデルほど、何を残すかを任せた方が成績がよい。「失敗だけ記録」の固定ルールで、Opus 5 の上積みが0.234減った
- wiki は検索と併用したとき(Stainless で61%)と、複数の文書をまたぐ質問(Harvey LAB で87%対73%)で効く。1つの文書で答えが見つかる課題では上積みがなかった
- 毎回読み込む層は小さく、1対象1ページ、原文は引用。Claude Code なら MEMORY.md を索引にし、CLAUDE.md は200行未満が目安
- メモリ汚染は次のセッションに持ち越される。
read_only、出力の確認、パスの検証、ZDR の有無を確かめてから使う
まずは今使っている CLAUDE.md やシステムプロンプトに「〇〇だけ記録する」といった固定ルールがないか確かめ、あれば目的を伝える書き方に変えるところから始めるとよいでしょう。
このツールを自社のシステムや業務にどう組み込むか、ご提案します
この記事の著者

AI革命
編集部
AI革命株式会社の編集部です。最新のAI技術動向から実践的な導入事例まで、企業のデジタル変革に役立つ情報をお届けしています。豊富な経験と専門知識を活かし、読者の皆様にとって価値のあるコンテンツを制作しています。
最新記事
Claude Code「Don't Ask Again」で秘密情報が漏えい|settings.local.jsonの確認・削除・予防策【2026年11月】
2026/11/08
薬局チェーン本部が押さえるべきレセコン選定の判断基準|制度対応・NSIPS・TCOで比較
2026/07/19
Meta Enterprise Agent Platformとは?Meta Enterprise Platform・Business Agentの機能・料金・狙いを完全解説【2026年11月最新】
2026/07/19
ChatGPTの家族プラン(ファミリープラン)はある?ChatGPT for Familiesの実態と家族で使う方法・ペアレンタルコントロール・Trusted Contact【2026年11月】
2026/07/18
OpenAIのエージェントがRubyGemsを攻撃していた|2000超の悪意あるパッケージ・RubyDoc.info経由のRCE・Hugging Face侵害との関係と未公表問題【2026年11月続報】
2026/09/15
OpenAIは未公開の数学研究を守れるのか|研究者が指摘する信頼性の問題・データ利用の懸念と研究機関が取るべき対策【2026年9月】
2026/09/15