Meta Llama 4 Maverickとは?17B active/400B total・128エキスパートMoEの仕組みと2026年の提供状況・料金を解説
この記事のポイント
Llama 4 MaverickはMetaが2025年4月に公開した、アクティブ17B・総400B・128エキスパートのMoE型マルチモーダルLLMです。仕組み・性能・ライセンスに加え、Llama API終了やBedrockのLegacy化など2026年10月時点の提供状況と、今から選ぶべきかの判断基準を整理します。
Llama 4 Maverickは、Metaが2025年4月5日に公開したオープンウェイトのマルチモーダルLLMで、総パラメータ400Bのうち1トークンあたり17Bだけを動かす「128エキスパート+1共有エキスパート」のMoE(Mixture of Experts)構成が最大の特徴です。 ただし2026年10月時点では、Meta公式のLlama APIやGroq・Cerebras・Databricksでの提供が終了しており、新規採用より「既存環境の維持と移行計画」が論点のモデルになっています。
この記事でわかること
- Llama 4 Maverickの基本仕様(17B active/400B total/128エキスパート/1Mコンテキスト)
- MoEの仕組みと「計算は17B級、メモリは400B級」というトレードオフ
- 公式ベンチマークと、2026年時点で見た実力
- 2026年10月時点で使える提供先・終了した提供先と料金
- Llama 4 Community Licenseの注意点(MAU7億条項・EU制限・表示義務など)
- 今からMaverickを選ぶべき人/別モデルを選ぶべき人と、移行先の候補
こんな方向けの記事です: Llama 4 Maverickを業務で使っている、または採用を検討しているAI担当者・開発者、オープンウェイトLLMを比較している決裁者、MoEの仕組みを理解したい方。
Llama 4 Maverickとは
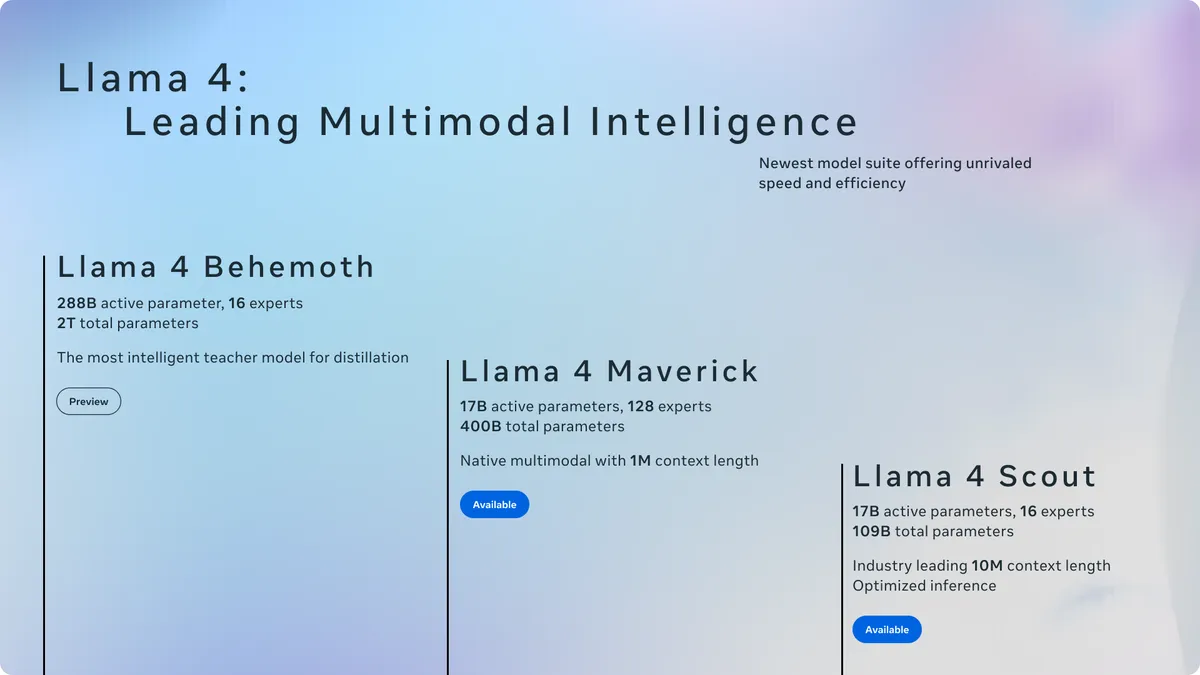
出典: Meta AI公式ブログ
Llama 4 Maverickは、Llama 4シリーズの中核を担うマルチモーダルモデルです。テキストと画像を入力でき、テキストとコードを出力します。重みはHugging Faceとllama.comで(ライセンス同意のうえ)ダウンロードでき、Amazon BedrockやOpenRouterなどのクラウド経由でも利用できます。
基本仕様
項目 | 内容 |
|---|---|
開発元 | Meta |
公開日 | 2025年4月5日 |
正式モデル名 |
|
アーキテクチャ | MoE+early fusionによるネイティブマルチモーダル |
パラメータ | アクティブ17B/総400B |
エキスパート | 128ルーテッドエキスパート+1共有エキスパート |
コンテキスト長 | 1Mトークン(モデルカード上。提供事業者側で128K〜512Kに制限される例あり) |
入力/出力 | テキスト+画像(公式テストは1プロンプト最大5枚)/テキスト・コード |
公式サポート言語 | 12言語(日本語は含まれない。事前学習は200言語) |
知識カットオフ | 2024年8月 |
学習データ量 | 約22兆トークン |
重み形式 | BF16/FP8(FP8版はH100 8枚搭載のDGXホスト1台に収まる) |
ライセンス | Llama 4 Community License(独自ライセンス。OSI定義のオープンソースではない) |
出典: Hugging Face 公式モデルカード、Meta AI Blog「The Llama 4 herd」
Llama 4シリーズ内の位置づけ
モデル | アクティブ | 総パラメータ | エキスパート | コンテキスト | 2026年10月時点の状況 |
|---|---|---|---|---|---|
Llama 4 Scout | 17B | 109B | 16 | 10M | オープンウェイト公開済み |
Llama 4 Maverick | 17B | 400B | 128 | 1M | オープンウェイト公開済み |
Llama 4 Behemoth | 288B | 約2T | 16 | — | 一般公開されていない |
Behemothは、MaverickとScoutの学習時に「教師モデル」として使われた超大型モデルです。2025年4月の発表時点で「学習中」とされたまま、2026年10月時点でも公開されていません。公式な中止発表も確認できないため、オープンウェイトで入手できるLlama 4の最上位は現在もMaverickです。軽量な兄弟モデルについてはLlama 4 Scoutの解説記事で詳しく整理しています。
2026年時点で押さえておきたい背景
Metaは2026年4月にクローズドモデル「Muse Spark」を発表し、主要メディアではAI開発の軸足がLlamaから新しいMuseシリーズへ移ったと報じられています。2026年8月にはApache 2.0ライセンスのオープンウェイトモデル「Muse Glimmer」も公開されました。一方、Llama 5のような後継Llamaは2026年10月時点で発表されていません。
つまりMaverickは「Metaの最新オープンモデル」ではなくなっており、この前提で評価する必要があります。Metaの新路線はMuse Sparkとは、最新版はMuse Spark 1.3の解説で確認できます。
17B active/400B total・128エキスパートMoEの仕組み
Maverickは「1トークンの計算は17B級で済むが、動かすには400B分の重みをすべてメモリに載せる必要がある」モデルです。この構造が、推論コストの安さとセルフホストの重さを同時に生んでいます。
MoE(Mixture of Experts)とは
MoEは、多数の「専門家(エキスパート)」ネットワークを用意し、入力トークンごとに一部の専門家だけを動かす仕組みです。Meta公式ブログによると、Maverickの構造は次のとおりです。
- 共有エキスパート(1個): すべてのトークンが必ず通る
- ルーテッドエキスパート(128個): ルーターがトークンごとに1個だけ選ぶ
- Dense層とMoE層を交互に配置
1トークンが通るのは「共有エキスパート+128個中の1個」だけなので、実際に計算に使われるパラメータは約17Bにとどまります。
「17B active」と「400B total」の意味
観点 | 効いてくる数字 | 実務上の影響 |
|---|---|---|
1トークンあたりの計算量・速度 | 17B(アクティブ) | 同規模のDenseモデルより推論が軽く、API単価を抑えやすい |
必要なGPUメモリ | 400B(総パラメータ) | どのエキスパートが選ばれても対応できるよう全重みを載せる必要がある |
知識の容量 | 400B(総パラメータ) | 17BのDenseモデルより多くの知識を保持できる |
「400Bの知識を17Bのコストで引き出す」のがMoEの狙いですが、メモリ要件は小さくなりません。FP8版でもH100 80GBを8枚積んだサーバー1台が公式の目安で、ローカルPCで動かすのは現実的ではありません。
early fusionによるネイティブマルチモーダル
Llama 4は、テキストトークンと画像トークンを最初から同じTransformerに入力する「early fusion」方式を採用しています。画像エンコーダーを後付けしたLlama 3.2系と違い、事前学習の段階からテキスト・画像・動画フレームを一体で学習しています。
その他の学習手法
- 共蒸留(codistillation): Behemothを教師にして学習。soft/hardターゲットを動的に重み付けする蒸留損失を使用
- 事後学習: 軽量SFT → オンライン強化学習 → 軽量DPOの順。「易しい」と判定したデータを50%以上除外
- MetaP(ハイパーパラメータ設定手法)やFP8学習も採用
Llama 4 Maverickでできること
Maverickが得意なのは、画像を含むドキュメント・チャートの読解と、多言語のテキスト・コード生成です。
- 画像理解: 画像の説明、図表やチャートの読解、文書画像からの情報抽出、画像に関する質問応答
- テキスト生成: 要約・翻訳・文章作成(公式サポート12言語)
- コード生成: 一般的なプログラミング支援
- ロングコンテキスト処理: モデル上は1Mトークンまで入力可能
- ツール呼び出し: Amazon Bedrockではクライアント側ツール呼び出し、Guardrails、Agents、Flows、ストリーミングに対応(Structured outputs・Knowledge base・Count tokensは非対応)
- 派生モデルのベース: ファインチューニング・蒸留・合成データ生成に利用可能(ライセンス条件あり)
画像・音声・動画の生成はできません。Bedrockの仕様上は音声・動画の入力にも対応していません。
公式ベンチマーク(指示調整版)
ベンチマーク | 内容 | Llama 3.3 70B | Llama 3.1 405B | Llama 4 Scout | Llama 4 Maverick |
|---|---|---|---|---|---|
MMMU | 画像を含む推論 | — | — | 69.4 | 73.4 |
MMMU Pro | 画像を含む推論(難) | — | — | 52.2 | 59.6 |
MathVista | 画像を含む数学 | — | — | 70.7 | 73.7 |
ChartQA | チャート読解 | — | — | 88.8 | 90.0 |
DocVQA (test) | 文書画像読解 | — | — | 94.4 | 94.4 |
LiveCodeBench | コーディング | 33.3 | 27.7 | 32.8 | 43.4 |
MMLU Pro | 知識・推論 | 68.9 | 73.4 | 74.3 | 80.5 |
GPQA Diamond | 専門的推論 | 50.5 | 49.0 | 57.2 | 69.8 |
MGSM | 多言語の数学 | 91.1 | 91.6 | 90.6 | 92.3 |
Llama 3.1 405Bと比べると、アクティブパラメータ17Bで知識・推論・コーディングの数値を大きく伸ばしています。なお、一部のWebサイトに見られる「MMLU 92.2%」のような数値は公式モデルカードと一致しないため、参照する際は注意してください(事前学習版の公式MMLUは85.5です)。
Llama 4 Maverickの強み
- オープンウェイトで重みを自社管理できる: セルフホストすればデータを外部に出さずに運用できます。データ主権を重視する組織には大きな利点です
- 400B級の知識を17B級の計算コストで使える: MoEのおかげで、同規模のDenseモデルより推論単価が安くなりやすい構造です
- 画像・文書読解に強い: DocVQA 94.4、ChartQA 90.0と、帳票やグラフの読み取りでは公開時点で高い数値を記録しています
- ファインチューニング資産を作れる: ライセンス上、派生モデルの作成・配布が認められています
- Bedrockのマネージド環境で使える: 2026年10月時点でも、AWSのGuardrailsやAgentsと組み合わせて使えます
Llama 4 Maverickの弱み・制約
最大の弱みは「2026年時点では性能が旧世代で、提供先も減っている」ことです。 公開当時の強みが、1年半でかなり相対化されています。
性能面
- 推論特化モデルではない: 思考(reasoning)モードを持たないため、gpt-oss-120bやDeepSeek V4、Qwen系の新世代モデルに比べると、難しい推論で見劣りします
- 第三者評価は中位以下: Artificial Analysisの評価(2026年10月時点)では、オープンウェイトの非推論モデルの中で知能指標が中央値を下回り、出力速度も中央値より遅いとされています
- 比較対象が古い: Metaが2025年4月に示した「GPT-4oやGemini 2.0 Flashを上回る」という主張は、いずれも現在では旧世代のモデルとの比較です
- 長いコンテキストで性能が落ちる: The Decoderなどの独立検証で、長文タスクでは公称値ほどの性能が出ないと指摘されています
LMArena問題(ベンチマークの信頼性)
2025年4月、Metaは非公開の実験版「Llama-4-Maverick-03-26-Experimental」(人間の好みに合わせたチャット最適化版)でLMArenaのELO 1417・2位を獲得しました。しかし一般公開版とは別物で、公開版は当時32位でした。LMArenaは「Metaのポリシー解釈は我々の期待と一致しない」と声明を出しています。Maverickを評価する際は、宣伝用の数字ではなく公開版のベンチマークと自社データでの検証で判断するのが安全です。
運用面
- 日本語は公式サポート外: 動作はしますが品質保証はありません
- 知識カットオフが2024年8月: 最新情報はRAG等で補う必要があります
- セルフホストが重い: FP8でもH100×8枚級が前提で、中小企業のオンプレミス運用には向きません
- 提供先が減少中: Meta公式API、Groq、Cerebras、Databricksなどで提供が終了しています
料金と提供状況(2026年10月時点)
出典: OpenRouter
重み自体は無料でダウンロードでき、API利用は各事業者の従量課金です。 ただし2026年に提供先が大きく減ったため、現在使える主な選択肢はAmazon Bedrock、OpenRouter経由、セルフホストの3つです。
現在使える主な提供先と料金
料金は100万トークンあたり(入力/出力、米ドル)。2026年10月7日時点で確認した値です。
提供先 | 状況 | 料金(入力/出力) | 備考 |
|---|---|---|---|
Amazon Bedrock | 提供中(Lifecycle: Legacy) | オンデマンド $0.24/$0.97、バッチ $0.12/$0.485(us-east-1) | EOL 2027年3月30日。US Geo推論のみ(us-east-1/2、us-west-1/2)、日本リージョンなし。コンテキスト1M・最大出力8K |
OpenRouter経由:DigitalOcean | 提供中 | $0.1875/$0.6525 | コンテキスト128K |
OpenRouter経由:Novita | 提供中 | $0.27/$0.85 | FP8・1M |
OpenRouter経由:Parasail | 提供中 | $0.35/$1.00 | FP8・512K |
OpenRouter経由:Google | 提供中 | $0.35/$1.15 | 512K |
出典: Amazon Bedrock モデルカード、Amazon Bedrock 料金、OpenRouter
Google Vertex AIとAzure AI Foundryの現行の提供状況・料金は、公式ページで確認できませんでした。利用中の方は各社のコンソールで直接確認してください。
提供が終了した主な事業者
提供先 | 終了時期 | 事業者の推奨移行先 |
|---|---|---|
Cerebras | 2025年10月15日に非推奨化 | GPT OSS 120B/Llama 3.3 70B |
Groq | 2026年2月20日告知、3月9日停止 | openai/gpt-oss-120b |
Databricks | pay-per-token:2026年3月9日、provisioned throughput:2026年6月9日 | GPT OSS 120B |
Meta Llama API(api.llama.com) | 2026年7月6日に提供終了 | (重みのダウンロードは継続) |
Together AI | 公式料金ページのサーバーレス推論にMaverickの掲載なし | ファインチューニング(SFT $5.60/DPO $14.00 per 1Mトークン)のみ掲載 |
Meta Llama APIの終了日は、公式移行ページがログイン必須のため複数の報道で一致した日付を記載しています。「Groqで高速に試す」といった2025年時点の手順は、現在は使えません。
セルフホストのコスト目安
- 公式の目安: FP8版はH100 80GB×8枚のDGXホスト1台に収まる
- 第三者の目安: INT4量子化でも約200GBを超えるため単一GPUでは動かず、最低でもH100 80GB×4枚クラス(Spheron)
- GPUレンタルの参考: H100×4枚で約$10.56/時(Spheron、2026年10月時点・事業者により変動)
月に数千万トークン程度の利用なら、セルフホストよりBedrockやOpenRouterの従量課金のほうが安く済むケースがほとんどです。
このツールを自社のシステムや業務にどう組み込むか、ご提案します
初回相談は無料・30分(オンライン)。要件が決まっていなくても大丈夫です。改修100万円〜・PoC300万円〜(税別)
Llama 4 Maverickの使い方
利用方法の選び方
目的 | おすすめの方法 |
|---|---|
すぐに試したい | OpenRouter経由(OpenAI互換API) |
AWS上で本番運用中 | Amazon Bedrock(EOLまでに移行計画を立てる) |
データを外部に出したくない | Hugging Faceから重みを取得してセルフホスト |
派生モデルを作りたい | 重みを取得してファインチューニング |
OpenRouterで試す
- OpenRouterでアカウントを作成し、APIキーを発行する
- モデルIDに
meta-llama/llama-4-maverickを指定する - OpenAI互換エンドポイントにリクエストを送る
from openai import OpenAI

client = OpenAI(
    base_url="https://openrouter.ai/api/v1",
    api_key="YOUR_OPENROUTER_API_KEY",
)

resp = client.chat.completions.create(
    model="meta-llama/llama-4-maverick",
    messages=[
        {"role": "user", "content": "MoEの仕組みを3行で説明してください"}
    ],
)
print(resp.choices[0].message.content)
OpenRouterはリクエストごとに提供事業者が切り替わることがあり、事業者によってコンテキスト上限(128K〜1M)や量子化(FP8など)が異なります。長文を扱う場合や品質を揃えたい場合は、事業者を固定する設定を検討してください。
Amazon Bedrockで使う
- モデルID:
meta.llama4-maverick-17b-instruct-v1:0 - 利用リージョン: US Geo推論(us-east-1/2、us-west-1/2)のみ
- 東京リージョンからは呼び出せないため、データの越境移転について社内規程を確認する必要があります
- Legacy扱いのため、2027年3月30日のEOLまでに移行先を決めておくことが前提です
セルフホストする
- Hugging Faceで
meta-llama/Llama-4-Maverick-17B-128E-Instruct(またはFP8版)のライセンスに同意し、アクセス承認を受ける transformersv4.51.0以上をインストールする- 本番運用ではvLLMなどの推論エンジンを使い、H100×8枚級の環境でFP8版を動かす
ローカルLLMの手軽な実行環境としてはOllamaが定番ですが、Maverickは400B級のため一般的なPCでは動かせません。ローカルで動かしたい場合は、より小さなモデルを選ぶのが現実的です。
ライセンスとセキュリティの注意点
出典: GitHub(meta-llama/llama-models)
Maverickは「無料で使えるが、無条件ではない」モデルです。 Llama 4 Community Licenseには、一般的なオープンソースライセンスにはない条件が含まれます。
商用利用前のチェックリスト
チェック項目 | 内容 | 該当しやすいケース |
|---|---|---|
MAU 7億条項 | 自社製品・サービスの月間アクティブユーザーが7億を超える場合、Metaへのライセンス申請が必要 | 超大手プラットフォーム、大手グループ傘下 |
「Built with Llama」表示 | 再配布や製品組み込み時に、Webサイト・UI・ドキュメント等へ目立つように表示 | Maverickを組み込んだSaaS・アプリ |
派生モデルの命名 | Llamaを使って作ったモデルを配布する場合、名前の先頭に「Llama」を付ける | ファインチューニングモデルを公開する場合 |
帰属表示 | 所定の著作権表示文を同梱 | 再配布全般 |
訴訟による終了 | MetaをLlamaの知財侵害で訴えるとライセンスが終了 | 知財係争を抱える企業 |
EU制限 | マルチモーダルモデルの権利は、EU居住の個人・EUに主たる事業所を持つ企業には付与されない。ただし組み込み製品を使うエンドユーザーは対象外 | EUに拠点を置く開発主体 |
準拠法 | カリフォルニア州法・同州裁判所の専属管轄 | 契約審査全般 |
EU制限は「EUの利用者に提供できない」という意味ではなく、「EUに主たる事業所を持つ企業が開発主体としてライセンスを受けられない」という点がポイントです。日本企業でも、EU現地法人が開発・提供する場合は対象になり得ます。
また、利用ポリシー(AUP)では違法行為、兵器・重要インフラ関連などの身体的危害、詐欺・偽情報・なりすまし、AIであることの不開示などが禁止されています。
出典: Llama 4 Community License、Llama 4 Acceptable Use Policy
本記事はライセンスの読み方を整理した一般情報であり、法的助言ではありません。商用利用の最終判断は法務部門や専門家に確認してください。
セキュリティ・運用上の注意
- 安全対策は導入者の責任: オープンウェイトのため、Llama GuardやBedrock Guardrailsなどのガードレールを自社で組み合わせる必要があります
- API経由ではデータの取り扱いを確認: OpenRouter経由の場合、実際に処理する事業者ごとにデータ保持・学習利用の規約が異なります
- 提供終了リスクの監視: モデルIDのEOL(Bedrockは2027年3月30日)を把握し、移行計画を持っておく
- 自社データでの評価: LMArena問題の経緯もあり、公表ベンチマークだけで採用を決めない
オープンウェイトモデルをめぐる各社の考え方は、Anthropicのオープンウェイトに対する立場も参考になります。
他モデルとの違い(2026年の比較)
2026年10月時点で新しくオープンウェイトモデルを選ぶなら、Maverickより新しい選択肢のほうが条件を満たしやすいケースが多くなっています。比較対象は、Maverickの提供を終了した事業者が移行先として挙げているgpt-oss-120bと、Metaの現行オープンウェイトであるMuse Glimmerです。
比較項目 | Llama 4 Maverick | Llama 4 Scout | Muse Glimmer | gpt-oss-120b |
|---|---|---|---|---|
開発元 | Meta | Meta | Meta | OpenAI |
公開時期 | 2025年4月 | 2025年4月 | 2026年8月 | 2025年8月 |
構造 | MoE(17B active/400B total) | MoE(17B active/109B total) | Dense 30B | MoE(約5B active/約117B total) |
コンテキスト | 1M(事業者で制限あり) | 10M(事業者で制限あり) | 128K | 128K |
画像入力 | 対応 | 対応 | 対応 | 非対応(テキストのみ) |
推論(思考)モード | なし | なし | — | あり |
ライセンス | Llama 4 Community License | Llama 4 Community License | Apache 2.0 | Apache 2.0 |
MAU 7億条項 | あり | あり | なし | なし |
必要なGPUの目安 | H100×8枚級(FP8) | Maverickより軽量 | 24GB VRAMで動作 | 80GB GPU 1枚 |
日本語 | 公式サポート外 | 公式サポート外 | 100以上の言語に対応 | 各環境で要検証 |
提供状況 | 減少中 | 減少中 | 2026年8月公開(提供先は各社で要確認) | 多くの事業者で提供 |
gpt-oss-120bの仕様はOpenAIの公開時の発表に基づく値です。Muse Glimmerの詳細はMuse Glimmerとはで解説しています。このほか、商用利用しやすいオープンウェイトとしてQwen3.8、Gemma 4、大規模MoEのDeepSeek V4も候補になります。
用途別の選び分け
やりたいこと | おすすめ |
|---|---|
すでにMaverickで構築済みのシステムを当面維持したい | Llama 4 Maverick(Bedrock等で継続、移行準備も並行) |
新規にオープンウェイトで画像入力も使いたい | Muse Glimmer |
推論性能重視で、テキスト中心のオープンウェイトを使いたい | gpt-oss-120b |
手元のGPU 1枚やPCで動かしたい | Muse Glimmer、Qwen3.8、Gemma 4など小〜中型モデル |
400B級MoEの挙動を研究したい | Llama 4 Maverick |
ライセンスの制約を最小にしたい | Apache 2.0のモデル(Muse Glimmer、gpt-oss-120bなど) |
ChatGPTやClaudeを含む生成AIツール全体の比較は生成AIツールおすすめ比較を参考にしてください。
Llama 4 Maverickがおすすめの人・おすすめしない人
こんな人におすすめ
- すでにMaverickでシステムを構築し、Amazon Bedrock上で運用しているチーム(EOLまでの時間を使って計画的に移行できる)
- Maverickベースのファインチューニング資産がある組織
- 400B級MoEモデルを研究・検証目的で扱いたい研究者・エンジニア
- 英語などの公式サポート言語で、文書画像やチャートの読解を中心に使う業務
- データを外部に出さずに運用でき、H100×8枚級のGPU環境をすでに持っている組織
おすすめしない人
- これから新規にオープンウェイトモデルを採用する人: 提供先の減少と性能面から、Muse Glimmer、gpt-oss-120b、Qwen3.8、Gemma 4などを先に検討するのがおすすめです
- 日本語の出力品質を重視する業務: 日本語は公式サポート外です
- EUに主たる事業所を置く企業: マルチモーダルモデルのライセンスが付与されません
- ローカルPCや単一GPUで動かしたい人: 400B級のため現実的ではありません
- 難しい推論やエージェント用途で最新水準の性能が必要な人: 推論モードを持つ新世代モデルのほうが適しています
- 長期にわたり同じモデルIDを使い続けたい人: 提供終了が相次いでいます
すでにMaverickを使っている場合の移行判断
利用中の方は、「どこで動かしているか」で対応の緊急度が変わります。
現在の利用環境 | 状況 | 推奨アクション |
|---|---|---|
Meta Llama API | 2026年7月6日に終了済み | 至急、Bedrock・OpenRouter・セルフホストまたは別モデルへ切り替え |
Groq/Cerebras/Databricks | 終了済み | 各事業者が推奨するgpt-oss-120b等へ移行、またはMaverickを提供する別事業者へ |
Amazon Bedrock | Legacy、2027年3月30日EOL | 2026年度中に後継モデルを評価し、切り替え計画を作る |
OpenRouter | 提供中(4事業者) | 当面は継続可。事業者の撤退に備えて代替モデルを用意 |
セルフホスト | 継続可能 | 重みは引き続き利用可。ただしエコシステムの更新は先細りする前提で運用 |
移行先を評価する際は、次の順で確認すると判断しやすくなります。
- 自社の評価データで品質を比較する(特に日本語・画像読解・長文)
- ライセンス条件を比べる(Apache 2.0か、独自ライセンスか)
- 提供先の数と継続性を確認する(複数のクラウドで使えるか)
- トークン単価とGPU要件から総コストを試算する
生成AIの基本的な仕組みや種類を整理し直したい方は生成AIとはも参考にしてください。
よくある質問
Q1. Llama 4 Maverickは無料で使えますか?
重みのダウンロードは無料ですが、Llama 4 Community Licenseへの同意が条件です。APIで使う場合は従量課金で、2026年10月時点ではAmazon Bedrockのオンデマンドが100万トークンあたり入力$0.24/出力$0.97、OpenRouter経由で入力$0.19〜0.35程度です。セルフホストの場合はGPU費用がかかります。
Q2. Meta公式のAPIでは使えないのですか?
Meta Llama API(api.llama.com)は2026年7月6日に提供を終了しています。現在はAmazon Bedrock、OpenRouter経由の各事業者、または重みをダウンロードしてのセルフホストで利用します。
Q3. Amazon Bedrockではいつまで使えますか?
AWSの公式ドキュメントでは、Lifecycleが「Legacy」、EOL(提供終了)日が2027年3月30日と記載されています。利用中の場合は、それまでに移行先を決めておく必要があります。
Q4. 日本語で使っても大丈夫ですか?
200言語で事前学習しているため日本語でも応答しますが、公式サポート12言語に日本語は含まれず、品質は保証されていません。日本語の業務文書を扱う場合は、自社の実データで精度を検証してから採用してください。
Q5. 17B activeなら、17Bモデル並みのGPUで動きますか?
動きません。計算に使うのは17B分ですが、どのエキスパートが選ばれても対応できるよう、400B分の重みをすべてメモリに載せる必要があります。公式の目安はFP8版でH100 80GB×8枚のサーバー1台です。
Q6. Llama 4 Behemothや後継のLlama 5は出ますか?
Behemothは2026年10月時点で一般公開されておらず、公式な中止発表も確認できません。Llama 5も発表されていません。Metaは2026年からMuse Spark(クローズド)とMuse Glimmer(オープンウェイト)のMuseシリーズを展開しています。
Q7. LMArenaで2位だったのは本当ですか?
2位を獲得したのは、一般公開されていないチャット最適化の実験版です。公開版は当時32位で、LMArenaはMetaの対応が自社ポリシーの期待と一致しないと声明を出しました。実力は公開版のベンチマークと自社評価で判断するのが確実です。
Q8. EUの顧客向けサービスに組み込めますか?
EU制限の対象は、EUに居住する個人と、EUに主たる事業所を持つ企業がライセンスを受ける権利です。Maverickを組み込んだ製品・サービスを使うエンドユーザーには適用されません。日本に主たる事業所を持つ企業がEUの顧客に提供すること自体は直ちに禁止されませんが、開発・提供主体がEU法人になる場合は法務確認が必要です。
まとめ
- Llama 4 Maverickは、17B active/400B total・128ルーテッドエキスパート+1共有エキスパートのMoE構造を持つ、Meta製のオープンウェイト・マルチモーダルLLM
- 計算は17B級で軽い一方、メモリは400B級が必要で、セルフホストにはH100×8枚級の環境が前提
- 文書画像・チャートの読解には強いが、推論モードを持たず、2026年の新世代モデルと比べると性能は中位以下
- 2026年10月時点でMeta Llama API、Groq、Cerebras、Databricksは提供終了。Amazon BedrockはLegacy扱いで2027年3月30日にEOL
- ライセンスにはMAU 7億条項、「Built with Llama」表示、EUでのマルチモーダル制限などの条件がある
- 既存ユーザーは移行計画を、新規採用ならMuse Glimmerやgpt-oss-120bなどを先に検討するのが現実的
Maverickは、MoEとネイティブマルチモーダルをオープンウェイトで普及させた重要なモデルです。ただし2026年時点では「最新の選択肢」ではないため、性能だけでなく提供の継続性、ライセンス、日本語品質の3点で判断してください。最新情報はMeta AI BlogとAmazon Bedrockのドキュメントで確認できます。
このツールを自社のシステムや業務にどう組み込むか、ご提案します
この記事の著者

AI革命
編集部
AI革命株式会社の編集部です。最新のAI技術動向から実践的な導入事例まで、企業のデジタル変革に役立つ情報をお届けしています。豊富な経験と専門知識を活かし、読者の皆様にとって価値のあるコンテンツを制作しています。
最新記事
Grok 4.5とは?API料金$2/$6・V9基盤・「Opus級性能」の実態とGrok 4.6/4.7との違い【2026年10月】
2026/07/09
OpenAI Daybreakとは?GPT-5.6-Cyber・Blue/Red・Codex Security・Patch the Planetを解説【2026年10月最新】
2026/05/15
Microsoft 365 Copilot エージェントとは?Word/Excel/PowerPointの自律実行機能・料金・制限を解説
2026/04/29
OpenAI Codex Labs とは|Accenture・PwC・Cognizant・CGI・Infosys・TCS・Capgemini 7大コンサル提携エンタープライズ導入ガイド【2026年10月】
2026/04/27
DeepSeek DeepInferとは?できること・動作環境・公開範囲・自社で使うべきかを整理【2026年10月】
2026/10/20
Windsurf 2.0 とは?Devin Desktop統合・Agent Command Center・料金・使い方を徹底解説【2026年10月最新】
2026/04/20