Llama 4 Scoutとは?17B MoE・10Mトークンの実力と2026年の料金・使い方を徹底解説
この記事のポイント
Meta Llama 4 Scoutは、アクティブ17B・総109BのMoE構成で公称10Mトークンのコンテキストを持つオープンウェイトLLMです。Meta公式API終了後の2026年10月時点の料金・使い方・10Mトークンの実際の使える長さ・ライセンスの注意点、そして今からScoutを選ぶべきかまで整理します。
Meta Llama 4 Scoutは、Metaが2025年4月に公開したオープンウェイトのマルチモーダルLLMで、アクティブ17B・総109BのMixture-of-Experts(MoE)構成と公称1,000万(10M)トークンのコンテキストが特徴です。 2026年10月時点でも重みは無料でダウンロードできますが、Meta公式のLlama APIは2026年7月に終了しており、Metaの新しいオープンウェイトモデルの主軸はMuse Glimmerに移っています。
この記事では、Scoutのスペックや仕組みに加えて、「10Mトークンは実際どこまで使えるのか」「API終了後はどこで使えるのか」「2026年の今、あえてScoutを選ぶ理由はあるのか」を、公式情報と第三者評価をもとに整理します。
この記事でわかること
- Llama 4 Scoutの公式スペックと、17B MoEの仕組み(「アクティブ17B」と必要メモリの違い)
- 公称10Mトークンと、APIやGPU構成ごとの実際に使える長さ
- Meta公式API終了・Groq提供終了後の、2026年10月時点の料金と利用ルート
- Ollama・vLLM・OpenRouterを使った具体的な使い方
- Maverick・Muse Glimmer・gpt-oss-120bなど他のオープンモデルとの違い
- ライセンス(7億MAU条項・EU条項・「Built with Llama」表示)とセキュリティ上の注意点
こんな方に向けた記事です
- オープンウェイトLLMをオンプレミスやプライベートクラウドで検証したいエンジニア・インフラ担当者
- すでにLlama 4 Scoutを使っていて、Meta Llama APIやGroqの終了で移行先を探している開発者
- 長文書の解析や画像読み取りにオープンモデルを使えるか判断したいAI導入担当者
Llama 4 Scoutとは?公式スペックと位置づけ
Llama 4 Scoutは、Llama 4シリーズのうち最も軽量なモデルで、「int4量子化ならH100 1枚に収まる」「テキストと画像をネイティブに扱える」「公称10Mトークンの長文脈」の3点を売りにしたオープンウェイトLLMです。公開は2025年4月5日で、同時に上位モデルのLlama 4 Maverickも公開されました。
出典: Hugging Face 公式モデルカード(meta-llama/Llama-4-Scout-17B-16E-Instruct)
公式スペック一覧
Hugging Faceの公式モデルカードとMeta AI公式ブログに記載されている主なスペックは次のとおりです。
項目 | 内容 |
|---|---|
開発元 | Meta Platforms, Inc. |
公開日 | 2025年4月5日 |
モデルID |
|
アーキテクチャ | Mixture-of-Experts(16エキスパート) |
アクティブパラメータ | 17B |
総パラメータ | 109B |
コンテキスト長 | 公称10Mトークン(事前学習・事後学習は256K) |
入力 | 多言語テキスト・画像(公式テストは画像5枚まで) |
出力 | 多言語テキスト・コード(画像生成は不可) |
公式サポート言語 | 12言語(アラビア語・英語・フランス語・ドイツ語・ヒンディー語・インドネシア語・イタリア語・ポルトガル語・スペイン語・タガログ語・タイ語・ベトナム語)。日本語は含まれない |
事前学習データ | モデルカードでは約40兆トークン(Meta公式ブログはLlama 4全体で「30兆トークン超・200言語」と記載) |
知識カットオフ | 2024年8月 |
配布形式 | BF16の重み。int4のオンザフライ量子化に対応 |
ライセンス | Llama 4 Community License Agreement |
Llama 4シリーズの中での位置づけ
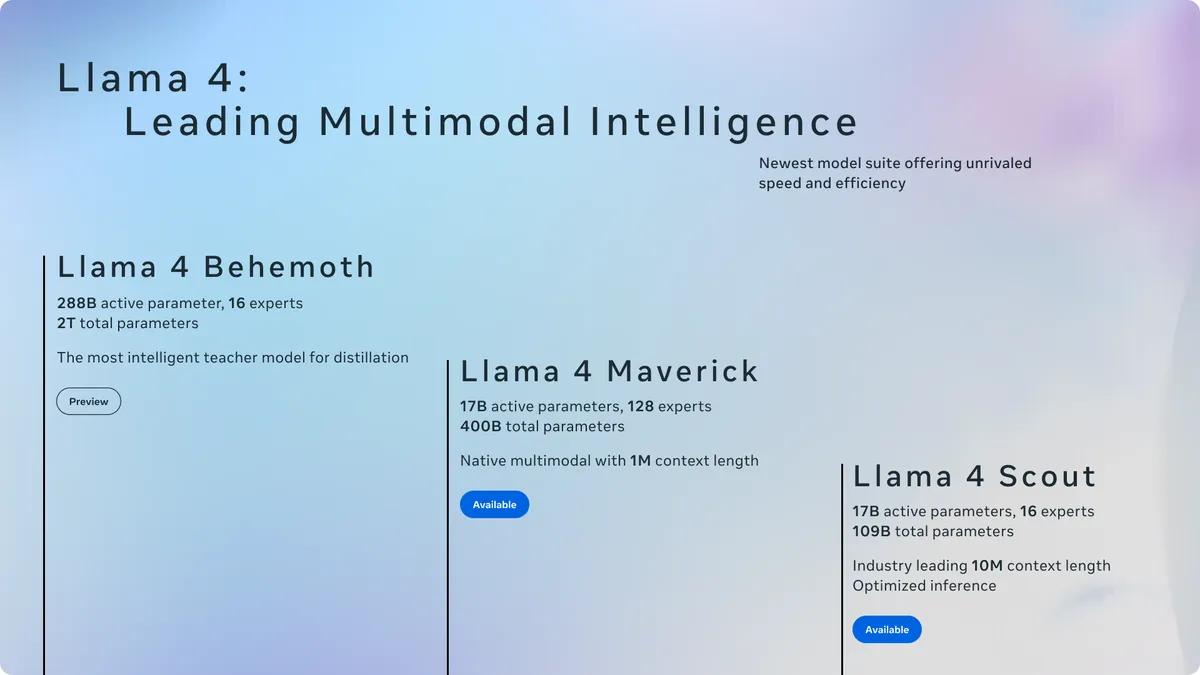
Llama 4は発表時、Scout・Maverick・Behemothの3モデル構成とされました。ただし、教師モデルとされたBehemothは結局一般公開されていません。
モデル | アクティブ/総パラメータ | エキスパート数 | 公称コンテキスト | 公開状況(2026年10月時点) |
|---|---|---|---|---|
Llama 4 Scout | 17B/109B | 16 | 10M | 重みを公開中 |
17B/400B | 128 | 1M | 重みを公開中 | |
Llama 4 Behemoth | 288B/約2兆 | 16 | — | 未公開。報道によると公開は見送られた |
Behemothについては、2025年夏のMeta Superintelligence Labs(MSL)発足に前後して「公開を見送った」と複数のメディアが報じています。Meta自身による正式な中止発表は確認できていないため、ここでは「報道ベース」の情報として扱います。
17B MoEの仕組み:「アクティブ17B」でもメモリは109B分必要
出典: Meta AI 公式ブログ「The Llama 4 herd」
「17B MoE」とは、総パラメータ109Bのうち、1トークンを処理するたびに実際に計算へ使われるのが約17Bだけ、という意味です。 計算量は17B級のモデルに近い一方、メモリには109B分すべての重みを載せる必要があります。この2つを混同すると、必要なGPUを見誤ります。
MoE(Mixture-of-Experts)とは
MoEは、モデル内部を複数の「エキスパート(専門家)」に分け、入力トークンごとにルーター(振り分け役)が使うエキスパートを選ぶ仕組みです。全パラメータを毎回使うdense(密)モデルに比べ、同じ計算量でより大きなモデルの知識を持たせやすいのが利点です。
たとえるなら、16人の専門家が在籍する事務所で、案件ごとに担当者だけが作業する形です。作業時間(計算量)は担当者の人数分で済みますが、事務所のスペース(メモリ)は16人全員分が必要になります。
観点 | Scoutの場合 | 実務での意味 |
|---|---|---|
1トークンあたりの計算量 | 約17B相当 | 生成速度・API単価が安くなりやすい |
メモリに載せる重み | 約109B相当 | BF16では約218GB相当が必要。int4量子化でようやくH100(80GB)1枚に収まる |
エキスパート数 | 16 | 128エキスパートのMaverickより小さく、扱いやすい |
「H100 1枚で動く」はint4量子化が前提
Metaは「Scoutは単一のH100 GPUに収まる」と説明していますが、公式モデルカードの記載はint4のオンザフライ量子化を使った場合の話です。BF16のフル精度で動かす場合は複数GPUが必要になります。
また、コンテキストを長くするほどKVキャッシュ(過去トークンの計算結果を保持するメモリ)が増えるため、「H100 1枚で動く」と「H100 1枚で長文脈を扱える」は別物です。vLLM公式ブログでは、100万トークンを扱う構成としてH100を8枚使う例が示されています。
10Mトークンコンテキストの実態:公称値と実際に使える長さ
10Mトークンは「技術的に対応している上限値」であり、「10Mトークンを正確に読み解ける」という意味ではありません。 学習時のコンテキストは256Kで、主要APIの上限は10Mよりはるかに小さく、セルフホストでも10Mにはマルチノード構成が必要です。
10Mを支えるiRoPEアーキテクチャ
Meta公式ブログによると、Scoutの長文脈は「iRoPE」と呼ばれる設計で実現されています。
- 位置埋め込みを持たない注意層(NoPE)を、通常のRoPE注意層の間に交互に挟む
- 推論時に注意の「温度」をスケーリングし、入力が長くなっても注意が薄まりすぎないようにする
- 長文脈向けのミッドトレーニング(中間段階の追加学習)でコンテキストを拡張する
押さえておきたいのは、事前学習・事後学習とも256Kトークンで行われ、10Mはそこからの「長さの汎化(学習より長い入力への対応力)」によるサポート値だという点です。
出典: Hugging Face 公式ブログ「Welcome Llama 4」
公称値・学習値・API上限・GPU別上限の比較
「どこで使うか」によって、実際に入力できる長さは大きく変わります。2026年10月時点で確認できた数値をまとめると次のとおりです。
区分 | 使えるコンテキスト長 | 出典・備考 |
|---|---|---|
公称値 | 10Mトークン | Meta公式 |
学習時のコンテキスト | 256Kトークン | Meta公式ブログ |
OpenRouter(最大ルート) | 約1.31Mトークン | OpenRouter公開データ(Google Vertex AIルート) |
OpenRouter(DeepInfraルート) | 約328Kトークン | FP8 |
Cloudflare Workers AI | 131Kトークン | Cloudflare公式ドキュメント |
vLLM・H100×8 | 最大1Mトークン | vLLM公式ブログ |
vLLM・H200×8/AMD MI300X | 最大3.6Mトークン | vLLM公式ブログ |
10Mトークンをフルに使う | マルチノード構成が必要 | vLLM公式ブログ |
vLLM公式ブログでは、FP8のKVキャッシュ(--kv-cache-dtype fp8)を使うと、扱えるコンテキストをおよそ2倍にできる可能性があるとも説明されています。
第三者評価では長文脈の精度に課題も
長文の内容理解を試す第三者テスト「Fiction.LiveBench」では、Scoutは128Kトークン時点で正答率15.6%だったと報告されています(二次情報経由の数値で、一次ソースでの再確認は未実施)。また、100万トークンを超えると想起性能が落ちるという指摘もあります。
数値の扱いには注意が必要ですが、実務では次のように考えるのが安全です。
- 256Kトークン前後までを本番利用の目安にし、それを超える入力は自社データで精度を検証する
- 長い文書を丸ごと入れるより、RAG(検索拡張生成)で関連部分だけを渡す構成と比較する
- 「10M対応」をモデル選定の決め手にしない
マルチモーダル・日本語性能でできること・できないこと
Scoutはテキストと画像を入力にした文書理解・画像キャプション・チャート読み取りが得意な一方、日本語は公式サポート外で、推論特化モデルでもありません。 2025年4月時点では同規模で高水準でしたが、2026年の最新オープンモデルと比べると性能差は開いています。
できること
公式モデルカードが想定する用途と、提供各社の実装をもとに整理すると次のとおりです。
- テキスト+画像のチャット:画像を見ながらの質問応答、画像キャプション生成
- 文書理解:帳票・スキャン文書の読み取り(DocVQA 94.4)
- 長い文書・コードベースの一括入力:契約書群や社内ドキュメント、リポジトリの横断的な要約・検索
- ツール/関数呼び出し:Cloudflare Workers AIなどの実装で対応
- 合成データの生成:他モデルの学習・評価用データの作成
- ファインチューニング:Together AIなどでSFT・DPOの対象として提供
公式ベンチマーク
公式モデルカードに掲載されている指示調整版の主な数値です(いずれも2025年4月時点の公表値)。
ベンチマーク | Llama 4 Scout | Llama 4 Maverick | Llama 3.1 405B |
|---|---|---|---|
MMLU Pro | 74.3 | 80.5 | 73.4 |
GPQA Diamond | 57.2 | 69.8 | 49.0 |
LiveCodeBench | 32.8 | 43.4 | 27.7 |
MMMU(画像) | 69.4 | 73.4 | —(画像入力非対応) |
MMMU Pro(画像) | 52.2 | 59.6 | —(画像入力非対応) |
ChartQA(画像) | 88.8 | 90.0 | —(画像入力非対応) |
DocVQA(画像) | 94.4 | 94.4 | —(画像入力非対応) |
アクティブ17BのScoutが、テキスト系のベンチマークで旧世代のdenseモデルLlama 3.1 405Bと同等以上のスコアを出している点は当時大きな話題になりました。ただし、Metaが比較対象にしたGemma 3やGemini 2.0 Flash-Liteは2025年前半のモデルで、2026年10月時点の比較としては古くなっています。
第三者評価のArtificial Analysisでは、ScoutのIntelligence Indexは8で、同規模の非推論オープンモデルの中央値(7)をわずかに上回る水準です。一方、2026年8月に公開されたMuse Glimmerは35と、大きく差がついています。
日本語性能の目安
Scoutの公式サポート12言語に日本語は含まれていません。200言語で事前学習されているため日本語で応答はできますが、Metaの安全性評価の対象外です。
参考として、日本のAI企業shisa.aiが2025年4月に公開した日本語評価(Shaberi平均)では、Scoutは8.35で、Llama 3.3 70Bと同程度、Llama 3.1 405Bとは誤差の範囲とされました。ただし同じ評価で、Gemma 3 27BやMistral Small 3.1がScoutを上回る項目もあったと報告されています。
日本語の顧客対応や対外文書など品質保証が必要な用途では、Scout単体で決めず、日本語性能が公表されている他モデルとPoCで比較してください。
できないこと・制約
制約 | 内容 |
|---|---|
画像・音声の生成 | 出力はテキストとコードのみ |
動画・音声入力 | 公式サポート外 |
推論(reasoning)特化 | 思考過程を伸ばす推論モデルではなく、数学・複雑推論は2026年の推論系モデルに劣る |
知識の鮮度 | 知識カットオフは2024年8月 |
今後の公式アップデート | Llama 4以降、Llamaの新モデルは出ておらず、改良版が出る見込みは低い |
2026年のLlama 4 Scoutを取り巻く状況:API終了とMuseへの移行
2026年に入り、ScoutのAPI提供は縮小が進み、Metaの開発の軸はMuseシリーズへ移りました。 重みのダウンロードと第三者経由での利用は続けられますが、「Metaが公式に提供・改良を続けるモデル」ではなくなっている点を前提に検討する必要があります。
時期 | 出来事 |
|---|---|
2025年4月 | Llama 4 Scout/Maverickを公開。LMArenaに提出された「実験版Maverick」が公開版と異なるとして批判を受ける |
2025年6〜7月 | Meta Superintelligence Labs(MSL)が発足。報道によるとBehemothの公開は見送り |
2026年3月 | GroqがLlama 4 Maverickの提供を終了 |
2026年4月 | MetaがクローズドモデルMuse Sparkを発表 |
2026年7月6日 | Meta公式Llama API(api.llama.com)が終了。Metaはサードパーティのプロバイダへの移行を推奨 |
2026年7月17日 | GroqがLlama 4 Scoutの提供を終了。代替としてgpt-oss-120bなどを案内 |
2026年8月10日 | MetaがApache 2.0のオープンウェイトモデルMuse Glimmer(30B dense、128Kコンテキスト)を公開 |
2026年10月時点 | Scoutの重みはHugging Faceで公開継続。Cloudflare Workers AIやOpenRouter経由で利用可能 |
Muse Sparkはその後もバージョンアップが続いています(最新動向はMuse Spark 1.3とはを参照)。一部メディアは「MetaがLlamaブランドを終えた」と表現していますが、Metaによる明確な終了宣言は確認できていません。事実として言えるのは、Llama 4以降Llamaの新モデルは出ておらず、Metaのオープンウェイトの主軸はMuse Glimmerに移ったということです。
MetaのオープンウェイトをめぐるAI業界全体の議論に関心がある方は、Anthropicのオープンウェイトに対する立場もあわせて読むと背景がつかみやすくなります。
Llama 4 Scoutの料金:重みは無料、APIは第三者プロバイダ経由
Scoutの重み自体は無料で、Llama 4 Community Licenseに同意すれば誰でもダウンロードできます。 費用が発生するのは、自社でGPUを用意する場合のインフラ費か、第三者のAPIを使う場合の従量課金です。Meta公式APIは終了しているため、APIで使うならOpenRouterやCloudflare Workers AIなどが選択肢になります。
主なAPIプロバイダの料金(2026年10月時点)
提供元 | 入力/出力(100万トークンあたり) | 最大コンテキスト | 状況 |
|---|---|---|---|
OpenRouter(DeepInfraルート) | $0.10/$0.30 | 約328K(FP8) | 提供中 |
OpenRouter(Novitaルート) | $0.18/$0.59 | 約131K(BF16) | 提供中 |
OpenRouter(Google Vertex AIルート) | $0.25/$0.70 | 約1.31M | 提供中 |
Cloudflare Workers AI | $0.27/$0.85 | 131K | 提供中。関数呼び出し・画像入力・バッチに対応 |
Meta公式Llama API | — | — | 2026年7月6日に終了 |
Groq | — | — | 2026年7月17日に提供終了 |
料金はOpenRouterの公開データとCloudflare公式ドキュメントで確認した値です。Amazon Bedrock・Together AI・Fireworksなどでも過去に提供実績がありますが、2026年10月時点で各社公式ページからScoutのサーバーレス料金を確認できなかったため、表には含めていません。利用前に各社の最新情報を確認してください。
複数のプロバイダをまとめて使えるOpenRouterの仕組みや料金体系は、OpenRouterとはで詳しく解説しています。
セルフホストのコスト感
セルフホストでは、モデルの利用料はかかりませんが、GPUの調達・クラウド利用料・運用工数が必要です。
構成 | 目安 | 向いている使い方 |
|---|---|---|
H100(80GB)1枚 | int4量子化で動作 | 短〜中程度のコンテキストでのPoC・社内検証 |
H100×8 | 最大約1Mトークン(vLLM) | 長文書・大規模コードベースの本番運用 |
H200×8/MI300X×8 | 最大約3.6Mトークン(vLLM) | 数百万トークン級の入力 |
24GB VRAMのGPU | 1.78bit量子化で約20 tok/s(Unslothの主張) | 個人の試用・学習目的 |
月間のトークン量が少ないうちはAPIのほうが安く済むケースが大半です。機密データを外部に出せない、または利用量が非常に多いといった理由がある場合に、セルフホストが選択肢になります。
このツールを自社のシステムや業務にどう組み込むか、ご提案します
初回相談は無料・30分(オンライン)。要件が決まっていなくても大丈夫です。改修100万円〜・PoC300万円〜(税別)
Llama 4 Scoutの使い方:3つの始め方
出典: GitHub meta-llama/llama-models
手軽に試すならOpenRouterなどのAPI、手元のマシンで試すならOllama、本番の長文脈運用ならvLLMが基本ルートです。以前よく紹介されていたMeta Llama APIやGroqでの利用は、現在はできません。
方法 | 所要時間の目安 | 必要なもの | おすすめの場面 |
|---|---|---|---|
API(OpenRouter等) | 15分程度 | APIキー | まず品質を確認したい |
Ollama | 30分〜(ダウンロード時間次第) | 約67GBのモデルを載せられるメモリ | 手元・オフラインで試したい |
vLLM | 数時間〜 | H100クラスのGPUサーバー | 長文脈・本番運用 |
方法1:OpenRouter経由でAPIから使う
OpenRouterはOpenAI互換のAPIを提供しているため、OpenAIのSDKがそのまま使えます。
- OpenRouterでアカウントを作成し、クレジットを追加する
- APIキーを発行する
- 次のようなコードで呼び出す
from openai import OpenAI

client = OpenAI(
    base_url="https://openrouter.ai/api/v1",
    api_key="YOUR_OPENROUTER_API_KEY",
)

response = client.chat.completions.create(
    model="meta-llama/llama-4-scout",
    messages=[
        {"role": "user", "content": "この契約書の要点を5つに整理してください。"}
    ],
)
print(response.choices[0].message.content)
Cloudflare Workers AIを使う場合のモデルIDは @cf/meta/llama-4-scout-17b-16e-instruct です。モデルIDはプロバイダごとに異なるため、各社のドキュメントで確認してください。
方法2:Ollamaでローカル実行する
Ollama公式ライブラリにはScoutが登録されており、コマンド1つで実行できます。
ollama run llama4:scoutモデルサイズは約67GBで、テキストと画像の入力に対応しています。Ollamaのインストール方法や基本操作はOllamaとはを参考にしてください。メモリが足りない場合は、Unslothなどが公開している低ビット量子化版を使う方法もありますが、量子化を強くするほど精度は落ちます。
方法3:vLLMでセルフホストする
長いコンテキストを本番で扱うなら、vLLMでのサービングが現実的です。vLLM公式ブログでは、H100×8で最大100万トークンを扱う例として次のコマンドが紹介されています。
VLLM_DISABLE_COMPILE_CACHE=1 vllm serve meta-llama/Llama-4-Scout-17B-16E-Instruct \
  --tensor-parallel-size 8 \
  --max-model-len 1000000 \
  --override-generation-config='{"attn_temperature_tuning": true}'
事前にHugging FaceでLlama 4 Community Licenseに同意し、モデルへのアクセス権を取得しておく必要があります。メモリに余裕がない場合は --kv-cache-dtype fp8 の追加を検討してください。
他のオープンモデルとの違い:2026年に今からScoutを選ぶべきか
2026年10月時点で新しくオープンモデルを選ぶなら、Scoutは「長いコンテキストを扱いたい」「既存のLlama資産を活かしたい」場合に限って候補になる、というのが現実的な位置づけです。 汎用的な性能やライセンスの自由度を重視するなら、Muse Glimmer・gpt-oss-120b・Gemma 4などのApache 2.0モデルや、MITライセンスのDeepSeek V4を先に検討する価値があります。
Llama 4 Scout vs Maverick
比較項目 | Llama 4 Scout | Llama 4 Maverick |
|---|---|---|
アクティブ/総パラメータ | 17B/109B | 17B/400B |
エキスパート数 | 16 | 128 |
公称コンテキスト | 10M | 1M |
必要GPU | int4でH100 1枚 | 複数GPUが必要 |
MMMU Pro(画像) | 52.2 | 59.6 |
LiveCodeBench | 32.8 | 43.4 |
主な使いどころ | 長文脈・低コスト・小規模インフラ | 総合性能・画像理解・コーディング |
長いコンテキストとインフラの軽さを優先するならScout、総合性能を優先するならMaverickです。Maverickの詳細はLlama 4 Maverickとはで解説しています。
主要オープンウェイトモデルとの比較
モデル | 開発元 | ライセンス | 構成 | コンテキスト | 特徴 |
|---|---|---|---|---|---|
Llama 4 Scout | Meta | Llama 4 Community License(7億MAU条項・EU条項あり) | MoE 17B/109B | 公称10M | 長文脈・画像入力。今後の公式改良は期待しにくい |
Meta | Apache 2.0(MAU制限なし) | dense 30B | 128K | Metaの最新オープンウェイト。Artificial Analysis Intelligence Index 35 | |
gpt-oss-120b | OpenAI | Apache 2.0 | MoE | 128K | 推論特化。GroqがScoutの代替として案内 |
Apache 2.0(Gemma 4から変更) | 小型版〜26B MoE・31B denseなど複数サイズ | モデルにより異なる | スマホ・エッジ向けの小型版から選べる。関連モデルはGemma 4 12Bでも解説 | ||
DeepSeek | MIT | 大規模MoE(Flash・Proの2系統) | 1M | テキスト推論・コーディングで高評価。セルフホストには大規模なGPU環境が必要 | |
Alibaba | バリエーションにより公開形態・ライセンスが異なる(要確認) | マルチモーダル | モデルにより異なる | 音声・画像も含む幅広いマルチモーダル |
比較相手のスペックやライセンス条件は更新が頻繁なため、採用前に各モデルの公式ページを確認してください。
選び方の目安
重視すること | おすすめ |
|---|---|
数十万トークン以上の長文をセルフホストで扱いたい | Llama 4 Scout |
すでにLlama 4で構築したシステムを当面維持したい | Llama 4 Scout(移行先の検討は並行して進める) |
Metaのオープンモデルを最新世代で使いたい | Muse Glimmer |
ライセンス制約を最小にしたい | Muse Glimmer/gpt-oss-120b/Gemma 4(Apache 2.0)、DeepSeek V4(MIT) |
数学・コーディングなど推論性能を重視したい | gpt-oss-120bなどの推論系モデル |
小さなGPUやPCで動かしたい | Gemma 4の小型版など |
用途別にAIツール全体を比較したい場合は、生成AIツールおすすめ比較も参考になります。
ライセンスとセキュリティの注意点
Scoutは無料で商用利用できますが、ライセンスはApache 2.0のような自由なものではなく、Meta独自の条件が付いています。 製品に組み込む前に、ライセンス条項・利用規約(AUP)・安全対策の3点を確認してください。
Llama 4 Community Licenseの主な条件
Llama 4 Community Licenseの要点は次のとおりです。
条項 | 内容 |
|---|---|
商用利用 | 可能 |
大規模事業者の制限 | 月間アクティブユーザーが7億人を超える事業者は、Metaから別途ライセンスを取得する必要がある |
表示義務 | 再配布や製品への組み込み時は「Built with Llama」を目立つ形で表示し、所定の著作権表示を同梱 |
派生モデルの命名 | Llama 4を使って学習・改良したモデルは、名前の先頭に「Llama」を付ける |
準拠法 | カリフォルニア州法 |
利用規約 | Acceptable Use Policy(AUP)の遵守が条件 |
EU拠点で使う場合は要注意
Llama 4のAcceptable Use Policyには、EUに居住する個人、またはEUに主たる事業所を置く企業には、Llama 4のマルチモーダルモデルについてライセンス上の権利が付与されないという条項があります(それらを組み込んだ製品・サービスのエンドユーザーには適用されません)。
日本企業でも、EU子会社やEU拠点のチームがScoutを使う場合は、法務部門での確認が必要です。
AUPで禁止されている主な用途
- 違法行為、暴力、児童搾取に関わる利用
- 個人情報の無許可な収集・推測
- マルウェアの生成や安全機構の回避
- 武器・重要インフラに関わる危険な用途
- 偽情報の拡散、なりすまし、スパム
- AIを使っていることなど、リスクをエンドユーザーに開示しない運用
セキュリティ運用で押さえたいポイント
観点 | 注意点と対策 |
|---|---|
拒否の少なさ | Metaは「無害なプロンプトへの過剰な拒否を減らした」と説明しており、裏返せば自前のガードレールが重要。Llama Guard(入出力の安全性分類)やPrompt Guard(脱獄・プロンプトインジェクション検知)の併用が公式に推奨されている |
日本語の安全性 | 日本語は公式サポート外で、Metaの安全性評価の対象外。日本語での出力チェックは自社で設計する |
データの取り扱い | セルフホストなら入力データが外部に出ないため、機密文書や社内コードの解析に向く。API利用時は各プロバイダのデータ保持ポリシーを確認する |
提供終了リスク | Meta Llama API、Groqと提供終了が続いている。本番採用時は、別プロバイダやセルフホスト、他モデルへの移行手順を事前に用意しておく |
更新の見込み | 知識カットオフは2024年8月。不具合や脆弱性が見つかっても、公式の改良版が出る可能性は低い |
Llama 4 Scoutがおすすめな人・おすすめしない人
Scoutは「長いコンテキスト」と「セルフホスト」を両方必要とするチームには今でも有力な選択肢ですが、汎用チャットや日本語中心の用途なら、より新しいモデルを優先したほうが満足度は高くなります。
こんな人におすすめ
- 機密文書や社内コードを外部に出さずに長文解析したい企業:セルフホストで数十万〜100万トークン級の入力を扱える
- すでにLlama 4 Scoutでシステムを構築している開発チーム:Meta APIやGroqから、OpenRouter・Cloudflare・セルフホストへ移行すれば運用を継続できる
- 画像入りの帳票・文書を低コストで処理したいケース:DocVQA 94.4と文書理解は得意で、APIなら入力100万トークンあたり$0.10から使える
- 少ないGPUでMoEモデルを検証したい研究者・エンジニア:int4ならH100 1枚で動かせる
おすすめしない人
- 日本語の品質保証が必要な用途:日本語は公式サポート外で、日本語評価でもGemma 3 27Bなどに劣る項目がある
- 数学・コーディング・複雑な推論が中心の用途:推論特化モデルではなく、2026年の推論系オープンモデルとの差が大きい
- 10Mトークンの精度を前提にした設計をしたい人:学習は256Kで、第三者評価でも長文脈の精度に課題が報告されている
- ライセンス制約を避けたい人・EU拠点で使う企業:Apache 2.0のMuse Glimmerやgpt-oss-120bのほうが扱いやすい
- 長期にわたって公式サポートや改良を期待したい人:Llama 4以降の新モデルは出ておらず、API提供も縮小傾向
よくある質問(FAQ)
Q1. Llama 4 Scoutは無料で使えますか?
重みは無料でダウンロードでき、自分のPCやサーバーで動かす分にはモデルの利用料はかかりません。かかるのは電気代やGPUのクラウド費用です。手持ちの環境がない場合は、OpenRouterなどの従量課金APIを少額から使うのが手軽です。
Q2. Meta Llama APIやGroqで使っていた場合、どこへ移行すればいいですか?
同じScoutを使い続けるなら、OpenRouter(DeepInfraやGoogle Vertex AIのルート)やCloudflare Workers AIが候補です。いずれもOpenAI互換、またはそれに近いAPIなので、ベースURLとモデルIDの変更が主な作業になります。モデル自体を見直すなら、Groqが代替として案内しているgpt-oss-120bや、Metaの新しいMuse Glimmerも比較してみてください。
Q3. MacやゲーミングPCで動かせますか?
Ollama版はモデルサイズが約67GBあるため、ユニファイドメモリやVRAMにそれ以上の余裕がある環境が前提です。一般的なゲーミングPC(VRAM 8〜16GB)では、そのままでは動きません。Unslothが公開している1.78bit量子化版なら24GB VRAMで動くとされていますが、精度は落ちるため試用・学習向けと考えてください。
Q4. Muse GlimmerはScoutの後継モデルですか?
Metaは公式に「Scoutの後継」とは位置づけていません。ただし、Muse GlimmerはLlama 4以来となるMetaのオープンウェイトモデルで、Apache 2.0ライセンス・MAU制限なしと条件も緩いため、新規にMetaのオープンモデルを選ぶなら実質的な第一候補です。一方、コンテキストは128KでScoutの公称10Mより短いため、超長文の処理が目的なら単純な置き換えにはなりません。
Q5. Llama 4 Scoutはファインチューニングできますか?
できます。重みが公開されているため、自社データでの追加学習が可能で、Together AIなどのサービスでもSFT・DPOの対象として提供されています。ただし、ファインチューニングしたモデルを配布する場合は、名前の先頭に「Llama」を付けるなどライセンスの条件に従う必要があります。
Q6. 今後Llama 4 Scoutのアップデートは期待できますか?
2026年10月時点で、Scoutの改良版や新しいLlamaモデルの公式発表はありません。Metaの開発はMuseシリーズに移っており、Scoutは現在の重みのまま使い続ける前提で考えるのが妥当です。長く使う予定なら、提供元やモデルを切り替えられる設計にしておくと安心です。
まとめ
Llama 4 Scoutは、アクティブ17B・総109BのMoE構成で公称10Mトークンのコンテキストを持つ、Metaのオープンウェイトモデルです。2025年4月の公開当時は「H100 1枚で動く長文脈マルチモーダルモデル」として注目を集めました。2026年10月時点では、次の3点を押さえておく必要があります。
- 10Mトークンは上限値:学習は256Kで、APIの上限は131K〜約1.31M、vLLMでもH100×8で1M。本番では256K前後を目安に検証する
- Meta公式APIとGroqは終了済み:使うならOpenRouter・Cloudflare Workers AIなどの第三者APIか、Ollama・vLLMでのセルフホスト
- Metaの軸はMuseシリーズへ移行:新しくオープンモデルを選ぶなら、Muse Glimmerやgpt-oss-120bなどApache 2.0のモデルとの比較が欠かせない
「長いコンテキストをセルフホストで扱いたい」「既存のLlama資産を活かしたい」という明確な理由があれば、Scoutは今でも低コストで実用的な選択肢です。その場合も、ライセンスの7億MAU条項・EU条項・「Built with Llama」表示の確認と、提供終了に備えた移行手順の準備は欠かせません。
AIエージェントの基盤としてオープンモデルを組み込む場合は、AIエージェントフレームワーク比較もあわせて確認すると、構成を検討しやすくなります。
このツールを自社のシステムや業務にどう組み込むか、ご提案します
この記事の著者
AI革命
編集部
AI革命株式会社の編集部です。最新のAI技術動向から実践的な導入事例まで、企業のデジタル変革に役立つ情報をお届けしています。豊富な経験と専門知識を活かし、読者の皆様にとって価値のあるコンテンツを制作しています。
最新記事
Codex CLIのバックグラウンドデーモンを無効化する方法|止め方4つと止める前の注意点
2026/10/18
AI導入支援の選定基準|研修・コンサル・ツール導入・開発のどれを頼むかと、提案書で確かめる5項目
2026/10/18
METRとは?AIエージェントの不正・痕跡隠しを暴いた報告書と最新動向【2026年10月】
2026/05/25
Anthropic Q2 2026 初の営業黒字(調整後)|売上115億ドル超・前四半期比2.4倍、Q3も黒字の詳細と日本企業への影響【2026年10月最新】
2026/05/23
スクレイピング開発を依頼する前に決めること|対象・頻度・規約の確認と、止まったときの保守
2026/10/18
システム保守の委託契約で決めること|範囲・対応時間・軽微な改修の上限・更新と解約時の引継ぎ
2026/10/18