ElevenLabs Voice Design v3とは?BlackRock出資・Eleven v4/v3モデル・料金・日本語対応を徹底解説【2026年最新】
この記事のポイント
ElevenLabs Voice Design v3は、文章で声の特徴を書くと新しいAI音声を3候補つくる機能です。2026年9月公開の最新モデルEleven v4との関係、10月改定のAPI料金と全プラン、日本語対応、BlackRock出資と評価額220億ドルまでを公式情報をもとに整理します。
ElevenLabs Voice Design v3は、「40代男性、落ち着いた低い声、ゆっくり話す」のように文章で声の特徴を書くと、新しいオリジナルのAI音声を3候補つくる機能です。2026年10月時点で読み上げの最新モデルは Eleven v4(2026年9月28日公開)に代わりましたが、声を作る Voice Design は今も v3(eleven_ttv_v3)が現行で、作った声を v4 で読ませる使い方になります。
「ElevenLabs を試してみたい個人」から「商用利用や社内導入を検討しているチーム」までを想定し、モデルの違い、料金、日本語の品質、企業で使うときの注意点、会社の最新動向をまとめました。料金はすべて米ドル・税別で、2026年10月23日時点の公式ページで確認した内容です。

ElevenLabsとVoice Design v3の基本
出典: ElevenLabs Voice Design 公式ページ
ElevenLabs は音声AIの専門企業で、Voice Design v3 はその中の「声を新しく作る」機能です。読み上げそのものは別のモデル(Eleven v4 など)が担当します。
ElevenLabsとは
ElevenLabs(イレブンラボ)は2022年創業のAI音声の会社です。共同創業者で CEO を務めるのは Mati Staniszewski 氏です。音声合成(TTS)、文字起こし(STT)、音声エージェント、音楽生成、吹き替えなどを提供しています。
2026年時点の公式の製品ブランドは次の3つです。
ブランド | 中身 |
|---|---|
ElevenCreative | ナレーション・吹き替え・音楽・広告などを作る制作アプリ群 |
ElevenAgents | 電話やWebで会話する音声エージェント |
ElevenAPI | 開発者向けの API・SDK |
Web アプリ、REST API、Python/TypeScript の SDK、モバイルの Reader App、2026年8月に公開した ElevenLabs CLI v1 から使えます。日本では2025年4月に日本法人 ElevenLabs Japan G.K.(東京・丸の内)を設立しており、同社で初めての海外法人です。TechCrunch によると従業員は800人を超えています。
Voice Design v3とは
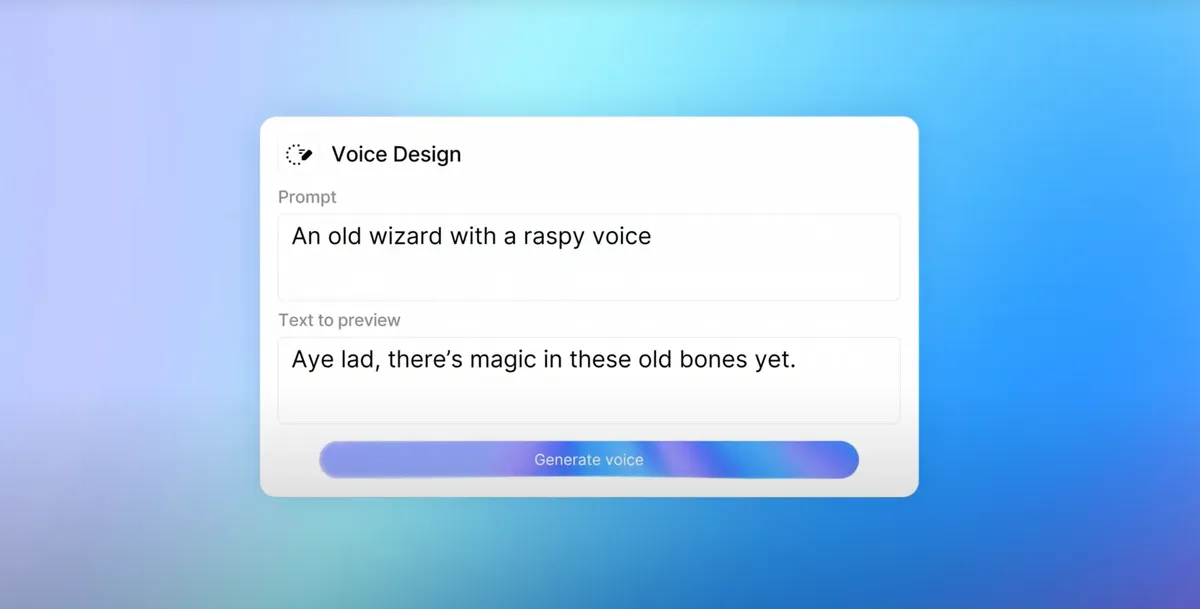
Voice Design v3 は、文章で声の特徴を書くだけで、ライブラリに無いオリジナルの声を作る機能です。 公式ブログでは2025年6月25日に公開されました。
年齢・性別・アクセント・トーン・話す速さ・音質を書いて生成すると、候補が3つ出ます。気に入った1つを保存すると、自分の声(My Voices)として読み上げに使えます。このときボイススロットを1つ使います。
公式は使い分けを次のように説明しています。
- 許諾を得た実在の人の声を再現したい → 音声クローン(特に PVC)
- ライブラリに合う声が無い、新しいキャラクターの声を試したい → Voice Design
Voice Design v3とEleven v4・Eleven v3の関係
名前に「v3」が付くものが複数あり、ここで混乱しがちです。役割で分けると整理しやすくなります。
項目 | Voice Design v3 | Eleven v4 / v4 Turbo | Eleven v3 |
|---|---|---|---|
役割 | 「どんな声か」を作る | その声で文章を読む(最新) | その声で文章を読む(前世代) |
モデルID |
|
|
|
公開 | 2025年6月25日 | 2026年9月28日 | 2025年6月(アルファ) |
現在の位置づけ | 現行の Voice Design 用モデル | 公式が推奨する最新モデル | 使えるが、公式は v4 への移行を推奨 |
2026年10月23日時点で、公式で「Voice Design v4」は確認できません。Voice Design で選べるのは eleven_ttv_v3 と eleven_multilingual_ttv_v2 の2つです。そのため現時点では「Voice Design v3 で声を作り、Eleven v4 で読ませる」という組み合わせが基本になります。
Voice Design v3でできること
Voice Design v3 では、用途に合わせた2つのモードで声を作り、文章の指示で細かく寄せていけます。生成にかかるのはプレビュー文の文字数分のクレジットだけです。
2つのモードで用途に合わせて声を作る
Realistic Voice Design(リアルな声)
人間らしい声を作るモードです。ナレーター、キャスター、案内音声、コールセンターの応対など、実在しそうな自然な声に向いています。
Character Voice Design(キャラクターの声)
ファンタジーのキャラクターや人間ではない存在の声を作るモードです。ゲームの NPC、アニメ風のキャラクター、ポッドキャストの演出などに使えます。
指定できる声の特徴とプロンプトのコツ
公式ブログが挙げている書ける要素は次のとおりです。
- 年齢・性別: 「中年男性」「20代女性」
- アクセント・国籍: 「英国英語」「強いスコットランドなまり」
- トーン・感情: 「温かい」「冷静で事務的」「明るい」
- 話す速さ: 「ゆっくり、考えながら話す」
- 音質: "Perfect audio quality."(クリアな音質)、無線を通したような音
公式のコツは「年齢・アクセント・トーン・速さ・音質を1文にまとめ、短く具体的に書く。専門用語は使わない」ことです。公式の例は次のとおりです。
Perfect audio quality. Elderly male, thick Scottish accent, slow and reflective, gravelly timbre.生成の設定にある Guidance Scale は、プロンプトどおりにしたいなら 8〜12、いろいろな声を試したいなら 3〜5 が公式の目安です。
v3だけで使える「参考音声」
API で eleven_ttv_v3 を選ぶと、参考音声(reference_audio_base64)を渡して声を寄せることができます。寄せる強さは prompt_strength で調整します。この2つは旧モデルの eleven_multilingual_ttv_v2 には無く、v3 だけの機能です。
クレジットのかかり方
Voice Design の生成でかかるのは、プレビュー文の文字数分のクレジットだけです。候補を3つ生成しても料金は同じです(公式ブログ)。Free プランでも使えますが、Free は商用利用ができません。

出典: ElevenLabs 公式サイト
Eleven v4・v3モデルの特徴と全モデル比較
2026年10月時点の最新・最高品質の読み上げモデルは Eleven v4、リアルタイム用は Eleven v4 Turbo です。Eleven v3 は前世代になり、公式ヘルプも v4 に切り替えて自分の原稿で試すよう勧めています。

出典: ElevenLabs 公式サイト
Eleven v4(eleven_v4)とv4 Turboの特徴
公式ブログ「Introducing Eleven v4」(2026年9月28日公開)と公式特設ページに書かれている主な変更点は次のとおりです。
- 対応言語は90以上(v3 は70以上)。日本語(
ja)は v4・v4 Turbo とも対応言語に入っている - 文脈から、トーン・間・感情をモデルが判断して読む。複数の話者の掛け合いも作れる
[laughs][whispers][long pause]などのオーディオタグや、自然な文での演技指示に v3 より正確に従う。[light rain][door slams]のような効果音のタグも使える- 発音記号(IPA)の指定と発音辞書が v3 より安定して反映されるようになった
- 1回の生成の上限は 10,000文字(v3 は5,000文字)
- PVC(プロフェッショナル音声クローン)が使えるようになった(v3 では使えなかった)
- ボイスライブラリにある17,500以上の声は、すべて v4 で使える
v4 Turbo は会話向けの速い版です。公式の測定では、推論の遅延の中央値が約100ms、話し始めるまでの時間の中央値が約150msです(WebSocket で測定。アプリ側とネットワークの遅延は含まない)。ElevenAgents の既定の読み上げモデルも、2026年10月5日に v4 Turbo に変わりました。
ElevenLabs によると、Artificial Analysis の音声比較(2026年9月)で1位になり、ブラインドの聞き比べでは約75%の人が v4 を選びました。どちらも同社の発表で、日本語の読み間違いの率を示した数字ではない点に注意してください。
Eleven v3(eleven_v3)の今の位置づけ
Eleven v3 は2025年6月にアルファ版として公開され、オーディオタグや Text to Dialogue(複数話者の対話を1回で作る機能)を広めたモデルです。2026年10月時点でも使えます。CLI の既定の読み上げモデルや、Realtime Translation の指定先としても残っています。
ただし、新しく作る場合は v4 を先に試すのが公式の推奨です。v4 のプロンプトのコツの多くは v3 にもそのまま使えます。
全モデル比較表
公式のモデル一覧(2026年10月23日確認)にある読み上げモデルを並べると、次のようになります。
モデルID | 位置づけ | 対応言語 | 1回の上限 | 遅延の目安 | 向いている用途 |
|---|---|---|---|---|---|
| 最新・最高品質 | 90以上 | 10,000文字 | 公表なし | ナレーション、オーディオブック、多言語の制作物 |
| v4 のリアルタイム版 | 90以上 | 公表なし | 約100ms | 音声エージェント、問い合わせ対応、対話キャラクター |
| 前世代 | 70以上 | 5,000文字 | 公表なし | 感情のある対話、Text to Dialogue |
| 前世代 | 70以上 | 公表なし | 約280ms | 感情を出したいリアルタイムの会話 |
| 前世代 | 29 | 10,000文字 | Flash より遅い | 電話番号など数字の読み、長文の安定 |
| 低価格・低遅延 | 32 | 40,000文字 | 約75ms | 費用を抑えたい音声エージェント |
| 英語のみ | 1 | 30,000文字 | 約75ms | 英語のリアルタイム応答 |
eleven_turbo_v2_5 と eleven_turbo_v2 は廃止され、それぞれ eleven_flash_v2_5・eleven_flash_v2 に置き換わっています。
やりたいこと別のモデルの選び方
やりたいこと | おすすめのモデル | 理由 |
|---|---|---|
ナレーション・オーディオブック・動画の音声 | Eleven v4 | 表現力が最も高く、10,000文字まで一度に作れる |
電話やWebの音声エージェント | Eleven v4 Turbo | 約100msで応答でき、ElevenAgents の既定モデル |
とにかく安く・速く読ませたい | Flash v2.5 | 約75ms、40,000文字まで。API 単価も安い |
電話番号・日付・金額を正しく読ませたい | Multilingual v2 | Flash v2.5 は数字をそのままでは読み下さない |
既存の v3 の原稿・設定を当面そのまま使う | Eleven v3 | 今も使えるが、早めに v4 で試すのがよい |
料金プラン詳細比較
ElevenLabs の料金は、Webアプリ用の月額プラン(クレジット制)と、API の従量料金の2本立てです。2026年10月の改定で、API の単価は既存モデルで約20%下がりました。
全プラン比較表
公式の料金ページ(2026年10月23日確認)の内容です。
プラン | 月払い | 年払い(月あたり) | クレジット/月 | 商用利用 | 音声クローン | 主な内容 |
|---|---|---|---|---|---|---|
Free | $0 | — | 10,000 | 不可 | なし | TTS・STT・効果音・Voice Design・音楽、プロジェクト3つ |
Starter | $6 | $5 | 30,000 | 可 | Instant | プロジェクト20、吹き替え、音楽の商用利用 |
Creator | $22 | $18.33 | 121,000 | 可 | Instant+PVC | クレジットの追加購入 |
Pro | $99 | $82.50 | 600,000 | 可 | Instant+PVC | API で 44.1kHz PCM・192kbps の出力 |
Scale | $299 | $249.17 | 1,800,000 | 可 | Instant+PVC(3つ) | 3シート |
Business | $990 | $825 | 6,000,000 | 可 | Instant+PVC(10個) | 10シート、低遅延TTSは1分あたり5セントから |
Enterprise | 個別見積 | 個別見積 | 個別 | 可 | 個別 | DPA/SLA、HIPAA 用の BAA、SSO、大口割引、優先サポート |
料金表の補足は次のとおりです。
- 年払いは10か月分の料金で、2か月分が無料になる
- 使わなかったクレジットは最大2か月繰り越せる(月の上限の2倍まで。Free は対象外)
- 初月の割引は時期によって変わる。2026年10月23日時点の料金ページでは、Starter が初月$1(11月1日まで)、Creator が初月$11と表示されている。申し込み時に料金ページで確認する
- クレジットは全製品で共通。読み上げは1文字1クレジットで、Eleven v4 も他の読み上げモデルと同じ単価
- 文字起こしは1分330、音楽は1分900、効果音は1回200クレジット
- スタートアップ向けに、12か月無料で3,300万文字を使える助成プログラムがある(申請が必要)
API料金(2026年10月改定)
API の従量料金(1,000文字あたり)は、2026年10月5日ごろに改定されました。
モデル | 現在 | 改定前 |
|---|---|---|
Eleven v4 | $0.08 | (新モデル) |
Eleven v4 Turbo | $0.04 | (新モデル) |
Eleven v3 | $0.08 | $0.10 |
Multilingual v2 | $0.08 | $0.10 |
v3 Conversational | $0.04 | $0.05 |
Flash / Turbo | $0.04 | $0.05 |
v4 の公開記念価格(72%引き)は、第三者の記録では2026年10月12日で終わっています。今から使う場合は上の通常価格で見積もってください。Voice Design の API 単価は、API 料金ページに個別の記載がありません。
月の文字数ごとの費用の目安(API)
公式の目安では、1,000文字はおよそ1分の音声です。日本語は同じ内容を少ない文字数で書けるため、分数への換算は言語によって変わります。あくまで目安として見てください。
月に読ませる文字数 | Eleven v4($0.08) | v4 Turbo・Flash($0.04) |
|---|---|---|
10,000文字 | $0.80 | $0.40 |
100,000文字 | $8 | $4 |
1,000,000文字 | $80 | $40 |
10,000,000文字 | $800 | $400 |
プランの選び方
- まず試したい人: Free で Voice Design と v4 の日本語を聞いてみる。商用で使うなら Starter 以上に上げる
- YouTube・ポッドキャストなどの制作者: Creator(月$22)。PVC で自分の声をクローンでき、月121,000クレジットあれば1本数千文字の原稿を何本も作れる
- チームで使う企業: Scale 以上でシート(利用者の枠)が付く。データ処理契約(DPA)や SLA が必要なら Enterprise
日本語対応の現状と限界
日本語は Eleven v4・v4 Turbo・v3 のいずれでも使え、ナレーションや案内音声なら実務で使える水準です。ただし読み間違いはゼロではないので、固有名詞の多い原稿は確認と修正の手間を見込んでください。
Eleven v4で日本語はどう変わったか
- 日本語(
ja)は v4・v4 Turbo の対応言語に入っている - TechCrunch によると、v4 で品質が最も上がった言語に、日本語・ブラジルポルトガル語・中国語(普通話)・広東語が入っている
- ElevenLabs Japan も、日本語を含む90以上の言語に対応すると案内している
- 第三者の検証では、日本語の原稿に英語のオーディオタグ(
[whispers]など)を混ぜて感情を出し分けられたという報告がある
一方で、日本語の品質を数字で示した公式の評価はありません。約75%が v4 を選んだという聞き比べも、言語を限定しないテストです。
日本語の読み間違いを直す方法
読み間違いが出たときは、次の順に試すと直りやすくなります。
- 読み間違えた語をひらがな・カタカナに書き換える
- 発音辞書に登録する(社名・商品名・略語など、繰り返し出る語に向く)
- 発音記号(IPA)で読み方を指定する(v4 で反映が安定した)
- 電話番号・日付・金額は Multilingual v2 で読ませるか、事前に文字に書き下してから渡す
日本語で使うときの注意点
- ライブラリの既製の声は英語話者が多い。日本語で自然に聞こえる声を選ぶか、Voice Design で日本語向けの声を作る
- Voice Design の公式の例は英語。日本語でも入力はできるが、アクセントなど細かい指定は英語のほうが意図どおりになりやすいという声がある。両方で試すとよい
- オーディオタグは v4 で正確さが上がったものの、毎回そのとおりになるとは限らない
- 日本語で録音した声に英語を話させても声質を保てる一方、別の言語で元の話者のアクセントを残す機能は研究中(公開時期は未定)
Voice Design v3の使い方(手順)
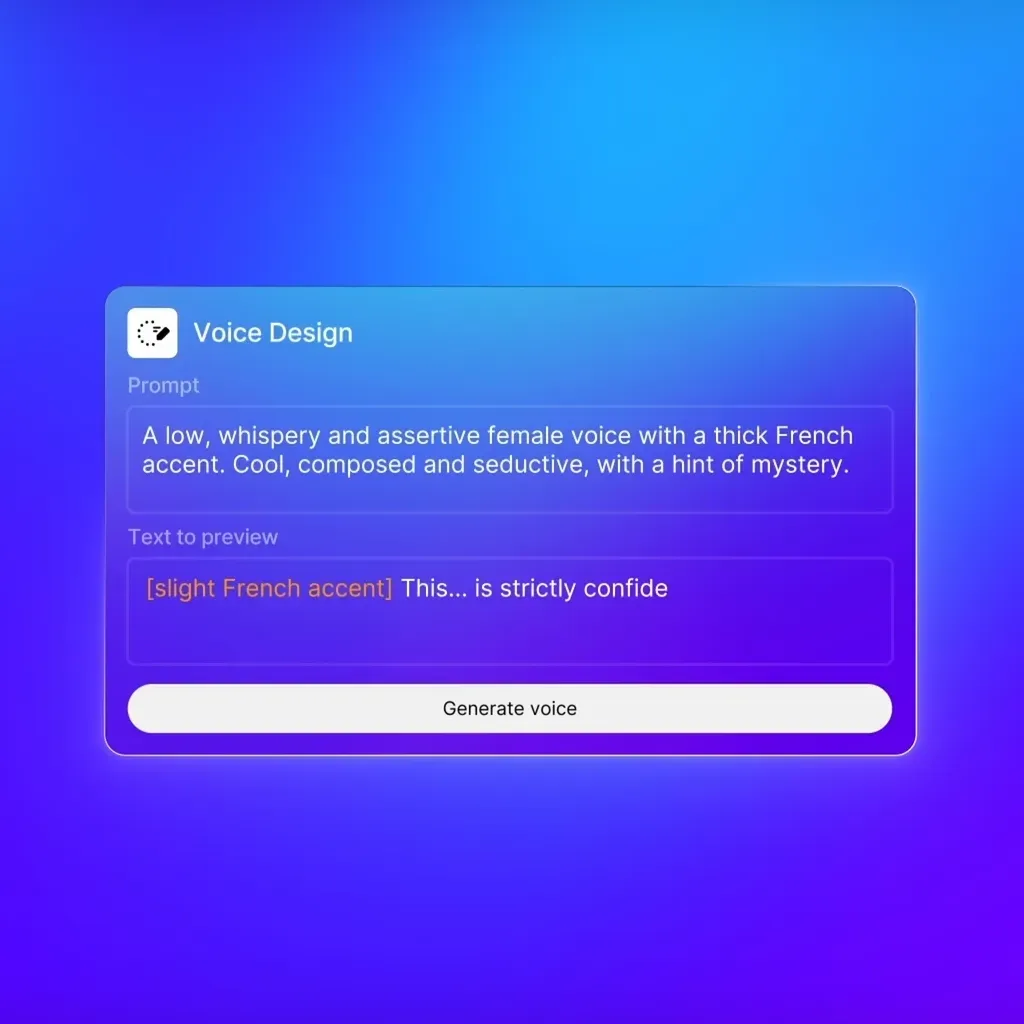
出典: ElevenLabs 公式ブログ
Webアプリなら5ステップで、プロンプトから声を作って読み上げに使えます。開発者は API でも同じ流れを組めます。
Webアプリでの手順
Step 1: アカウントを作る
ElevenLabs 公式サイトでアカウントを作成します。Google アカウントでもログインできます。
Step 2: Voice Design を開く
ダッシュボードの「Voices」→「My Voices」→「Add a new voice」→「Voice Design」を選びます。
Step 3: モードとプロンプトを入れる
- Realistic(人間らしい声)か Character(キャラクターの声)を選ぶ
- 声の説明を書く(公式の例は英語。日本語でも入力できるので、両方で試すとよい)
- プレビュー用の文を入れる。この文の文字数分だけクレジットがかかる
Step 4: 3つの候補から選ぶ
生成すると候補が3つ出ます。聞き比べて、気に入った声を保存します。
Step 5: 読み上げに使う
保存した声は Text to Speech や Studio で使えます。モデルは Eleven v4 を選び、自分の原稿で聞き比べてください。
プロンプト例(日本語)
30代の女性ナレーター。落ち着いた声で、はっきりした標準語。
ゆっくりめのテンポで、聞き手を安心させるトーン。クリアな音質。
架空のゲームキャラクター。年老いた魔法使いの男性。低くしわがれた声で、
ときどき笑みがこぼれるような温かさがある。ゆっくり話す。APIで声を作る流れ
公式の API リファレンスでは、次の2段階で声を作ります。
POST https://api.elevenlabs.io/v1/text-to-voice/designでプレビューを生成する- 選んだプレビューの
generated_voice_idを使って声を作成する
主なパラメータは次のとおりです。
パラメータ | 内容 |
|---|---|
|
|
| 声の説明(必須) |
| プレビュー文(100〜1,000文字)。 |
| 既定5。高いとプロンプトに忠実だが、機械っぽくなることがある |
| 同じ seed と同じ入力なら同じ声になる |
| 音量。既定0.5(-1〜1) |
| 参考音声とその強さ( |
2026年9月28日の changelog では、同じプレビューの生成が動いている間に再度呼ぶと 409 が返るので、時間をおいて再実行するよう案内しています。
Eleven v3からv4へ移るときのチェックポイント
出典: ElevenLabs 公式ブログ
今 v3 や Default 音声を使っている場合は、次の5点を先に確認しておくと移行で困りません。
確認すること | 内容 | 対応 |
|---|---|---|
クローンの再学習 | 前に作った音声クローン・PVC を v4 で使うには、v4 向けの再学習が必要 | ボイスにカーソルを合わせ、+ボタンから v4 用に学習する |
Voice Design の声 | ライブラリの声は v4 で使えると公式は明記。自作の Voice Design の声は明記なし | v4 で読ませて、声質が変わらないか自分で確認する |
間の入れ方 | SSML の | 句読点や |
文字数の上限 | v4 は1回10,000文字、v3 は5,000文字 | v3 用に細かく分けていた原稿はまとめられる場合がある |
Default 音声の終了 | 2026年12月31日で使えなくなる(アカウント作成が2026年3月より前の人が対象) | API は似た新しい声に自動で切り替わるが声は変わる。代わりの声を Voice Design や Voice Remix で用意しておく |
競合ツールとの比較
日本語のナレーションや感情表現まで1つで済ませたいなら ElevenLabs、大量の定型読み上げを安くしたいならクラウド各社の TTS、という分け方が基本です。
主要AI音声ツール比較表
ツール | 主な強み | 向いている用途 |
|---|---|---|
ElevenLabs(Eleven v4) | 表現力、90以上の言語、オーディオタグ、音声クローン(Instant・PVC)、文章で声を作る Voice Design | ナレーション、キャラクター、多言語の制作、音声エージェント |
OpenAI の音声モデル | LLM と一体になった会話、指示文で話し方を変えられる | ChatGPT 系の LLM と組み合わせた音声アプリ |
Google Cloud Text-to-Speech | 大量処理、Google Cloud のサービスとの連携 | 定型の読み上げを大量に、安く |
Amazon Polly | AWS のサービスとの連携、低コスト | 案内音声、電話の自動応答(IVR)、シンプルな読み上げ |
Cartesia | 低遅延に特化 | リアルタイム会話の音声エージェント |
表は各社の大まかな位置づけです。料金や、音声クローン・声づくりの機能の有無と条件は各社で頻繁に変わるため、採用前に公式ページで確認してください。OpenAI の最新の音声モデルはGPT-Realtime-2の解説とGPT-Liveの解説で、Google のリアルタイム翻訳はGemini 3.5 Live Translateの解説で詳しく紹介しています。

ElevenLabsを選ぶべきケース・避けるべきケース
ElevenLabs が合う場面
- 笑い・ささやき・ため息などの感情を、文章の指示で入れたい
- ライブラリに無いオリジナルの声を作りたい(Voice Design v3)
- 許諾を得た声をクローンして、動画やポッドキャストに使いたい
- 日本語を含む多言語で、同じ声のまま展開したい
- 音声エージェントまで1社でそろえたい(ElevenAgents)
ほかを優先したほうがよい場面
- 定型文を大量に、最安で読ませたいだけ → Google Cloud TTS や Amazon Polly のほうが安く済む場合がある
- すでに OpenAI の LLM で会話アプリを作っていて、音声も同じ API でまとめたい → OpenAI の音声モデル
- 応答の速さを最優先で比べたい → Cartesia など低遅延に特化した会社とも聞き比べる
音楽の生成も同じアカウントで使えます。詳しくはElevenLabs Music v2の解説をご覧ください。
こんな人におすすめ / おすすめしない人
ElevenLabs(Voice Design v3を含む)がおすすめな人
- 動画・ポッドキャストの制作者: ナレーションやオーディオブックに、自分だけのオリジナルの声を使いたい
- ゲーム・アニメの開発者: キャラクターの声を Character モードで素早く作って試したい
- マーケター・広告担当者: 同じ声で多言語の動画広告や音声広告を作りたい
- 教育コンテンツの制作者: 自然な日本語の声で教材や e ラーニングを作りたい
- 問い合わせ窓口を自動化したい企業: v4 Turbo と ElevenAgents で、電話やWebの音声対応を作りたい
おすすめしない人
- 無料で商用利用したい人: Free は商用利用ができません。最低でも Starter(月$6)が必要です
- 数字の多い原稿をそのまま読ませたい人: Flash v2.5 は電話番号や金額をそのままでは読み下しません。Multilingual v2 を使うか、事前に文字に直す手間がかかります
- SSML の
<break>で間を細かく作り込んでいる人: v3・v4 とも<break>が使えず、書き方を変える必要があります - 読み上げだけで、表現力は要らない人: クラウド各社の TTS のほうが安く済むことがあります
- 他人の声を許可なく使いたい人: 本人の同意のない声のクローンは利用ポリシーで禁止されています
企業導入・セキュリティ確認事項
企業で使う前に、学習データの扱い、データの保存期間、認証、声の権利の4点を確認してください。学習データは Enterprise 以外のプランでもオプトアウトで止められます。
学習データとデータ保存
- 学習への利用: プライバシーポリシー(2026年10月9日更新)では、入力・出力・利用情報をモデルの学習に使う場合があると書かれています。学習に使わせたくない場合は、アカウントの「Terms and Privacy」→「Data use」でオプトアウトを設定します。オプトアウトが適用されるのは、設定した後の学習だけです
- v4 の公式ページは「原稿とオーディオタグは同意なしに学習に使わない」としています。ポリシーと書き方が違うため、社外秘の原稿を扱う場合はオプトアウトを先に設定しておくのが安全です
- 声のデータの保存: 最後に使ってから最長3年(法律で必要な場合を除く)
- Enterprise: 対象のサービスで Zero Retention Mode(データを残さない設定)を使えます
- 会社として契約して使う場合、ElevenLabs はデータ処理者になり、会社との契約の内容が優先されます
認証・コンプライアンス
- SOC 2 Type II、ISO 27001、PCI DSS Level 1、GDPR 準拠、HIPAA 対応のワークフロー(v4 公式ページ)
- データ移転は EU-U.S. DPF・UK Extension・Swiss-U.S. DPF(米国法人)、それ以外は標準契約条項
- 医療で使う場合の BAA、DPA・SLA・SSO は Enterprise プランで対応
- 詳細はElevenLabs コンプライアンスセンターで確認できます
禁止されている使い方
ElevenLabs の利用ポリシーでは、次の使い方を禁止しています。
- 本人の同意なく他人の声をクローンすること(v4 では、すべてのクローンで本人の同意を確認する)
- 詐欺・なりすまし・フィッシングへの利用
- 選挙への介入(2026年7月に選挙関連の対策を公式ブログで発表)
タレントや社員の声を使う場合は、書面で同意を取り、使う範囲と期間を決めておいてください。ElevenLabs で作った音声かどうかを判定する AI Speech Classifier も公開されています。

出典: ElevenLabs 公式サイト
自社のシステムに組み込む場合
v4 Turbo を問い合わせ窓口の自動応答や社内の業務システムに組み込む場合は、API の料金に加えて、既存システムとの連携や会話の設計にかかる開発費も見込む必要があります。方法ごとの費用の目安はAI開発の費用相場で、改修・PoC・本開発に分けて整理しています。コールセンターでの導入例はコンタクトセンターのAI活用事例も参考になります。
Default音声の終了(2026年12月31日)
公式ヘルプによると、Default 音声は2026年12月31日で使えなくなります(期限まで約2か月)。対象はアカウント作成が2026年3月より前の人です。API で使っている場合は似た新しい声に自動で切り替わりますが、声は変わります。案内音声や動画シリーズで声をそろえている場合は、Voice Design v3 や Voice Remix で代わりの声を今のうちに作って、v4 で聞き比べておくと安心です。
ElevenLabsの最新動向(2026年最新)
2026年の ElevenLabs は、5月に BlackRock などの新しい投資家を迎え、9月に Eleven v4 を公開し、評価額は220億ドルまで上がりました。
BlackRock・NVIDIA・Salesforceが出資(2026年5月)
2026年5月5日、ElevenLabs は Series D の追加分で新しく加わった投資家を公表しました。
- 機関投資家: BlackRock、Wellington Management、D.E. Shaw、Schroders
- 事業会社: NVIDIA、Salesforce Ventures、Santander、KPN、Deutsche Telekom
- 個人: Jamie Foxx 氏、Eva Longoria 氏、ファン・ドンヒョク氏(『イカゲーム』の監督)
このとき会社は ARR(年間経常収益)が5億ドルを超えたと発表しています。BlackRock の出資額は公表されていません。
Series D(5億ドル)の詳細(2026年2月)
2026年2月4日、Sequoia Capital 主導の Series D で5億ドルを調達し、評価額は110億ドルになりました。2025年1月は33億ドル、2025年9月は66億ドルで、1年ほどで3倍以上になっています。2026年3月には IBM が、watsonx Orchestrate と ElevenAgents の連携を発表しています。
Eleven v4の公開とARR 6億ドル超(2026年9月)
2026年9月28日に Eleven v4・v4 Turbo を公開しました。TechCrunch によると、ARR は年初の約3.3億ドルから6億ドル超に増え、売上の55%超を大企業が占めています。同じ月には Universal Music Group との複数年の提携(9月10日)も発表しました。
評価額220億ドルに(2026年9月30日)
2026年9月30日、ElevenLabs は評価額が220億ドルになったと公式ブログで発表しました。これは従業員や既存株主が株を売る取引(テンダーオファー、約3億ドル規模)で、会社に新しい資金が入る増資ではありません。Wellington と T. Rowe Price が主導し、EQT、Goldman Sachs、GIC などが新しく加わりました。9月の投資家一覧に BlackRock の名前はありません。

IPOの時期は未定
CEO の Mati Staniszewski 氏は2026年3月に「2〜3年以内に IPO の準備を整える」と Bloomberg に話しました。9月の TechCrunch の取材でも「この先数年のうちに」としており、具体的な時期は示していません。
2026年の主な動き
日付 | 内容 |
|---|---|
2026年2月4日 | Series D で5億ドル調達(評価額110億ドル) |
2026年5月5日 | BlackRock などの新しい投資家を公表、ARR 5億ドル超 |
2026年5月27日 | Eleven Music v2 を公開 |
2026年6月 | ワルシャワで ElevenLabs Summit を開催。ポーランド政府が出資 |
2026年8月24日 | ElevenLabs CLI v1 を公開 |
2026年9月28日 | Eleven v4・v4 Turbo を公開 |
2026年9月30日 | 評価額220億ドル(従業員向けテンダーオファー) |
2026年10月5日ごろ | API 料金を改定。ElevenAgents の既定モデルが v4 Turbo に |
2026年12月31日 | Default 音声の提供終了(予定) |
Spotify の制作ツールとの連携など、ElevenLabs の音声を使った他社サービスも増えています。例としてStudio by Spotify Labsの解説があります。
Voice Libraryで音声を収益化する方法
ElevenLabs には、ユーザーが作った声を公開して他のユーザーに使ってもらう Voice Library があります。公開した声が使われると、作った人に報酬が支払われる仕組みです。
- 公開できる声の種類、報酬の条件、必要なプランは変わることがあるため、公開前に公式ヘルプで確認する
- 実在の人の声をもとにする場合は、本人の同意が必要
- ライブラリには17,500以上の声があり、すべて v4 で使える
声優やナレーターにとっては、自分の声(PVC)を貸し出す形の収入源になります。
よくある質問(FAQ)
Q: 「Voice Design v4」はありますか?
A: 2026年10月23日時点の公式ドキュメントでは確認できません。Voice Design で選べるのは eleven_ttv_v3 と eleven_multilingual_ttv_v2 です。読み上げのモデルだけが v4 になったので、「声は Voice Design v3 で作り、読み上げは v4 を選ぶ」と考えてください。
Q: Voice Design v3 と旧モデル(eleven_multilingual_ttv_v2)はどちらを選べばよいですか?
A: 参考音声を渡して特定の雰囲気に寄せたいなら、v3 にしかない reference_audio_base64 が使えるので v3 を選びます。API の既定は今も旧モデルなので、v3 を使うときは model_id を明示してください。
Q: Voice Design で作った声は、商用で使えますか?
A: Starter 以上の有料プランなら商用利用できます。Free では商用利用できません。また、実在の人の声に似せる目的のプロンプトは利用ポリシーに反するおそれがあります。
Q: v4 は v3 より高いですか?
A: API では同じ $0.08(1,000文字あたり)です。Webアプリのクレジットも他の読み上げモデルと同じ単価です。会話向けの v4 Turbo は半額の $0.04 です。
Q: v4 の公開記念の割引はまだ使えますか?
A: 第三者の記録では、72%引きの記念価格は2026年10月12日で終わっています。今は通常価格です。
Q: 同じ声を何度でも作り直せますか?
A: API なら、seed と入力を同じにすると同じ声を再現できます。Webアプリで作った声は保存しておけば、そのまま使い続けられます。
Q: 法人で使う場合、学習に使われないようにできますか?
A: Enterprise 以外のプランでも、アカウントの「Data use」からオプトアウトできます。データを残さない運用(Zero Retention Mode)や DPA が必要なら Enterprise の契約を検討してください。
まとめ
- Voice Design v3 は、文章で声の特徴を書くと3候補を作る機能で、2026年10月時点でも Voice Design の現行モデル
- 読み上げの最新モデルは Eleven v4(2026年9月28日公開、90以上の言語、10,000文字、PVC 対応)。会話向けは v4 Turbo(約100ms)
- Eleven v3 は前世代。公式は v4 への移行を勧めており、クローンの再学習と Default 音声の終了(2026年12月31日)に注意
- 料金は Free から Enterprise まで7プラン。API は10月に改定され、v4 は1,000文字 $0.08、v4 Turbo は $0.04
- 日本語は v4 で品質が大きく上がった言語の1つ。固有名詞は発音辞書やひらがな書きで直す
- 会社は BlackRock などの出資(5月)を経て、評価額220億ドル(9月、テンダーオファー)になった
まずは Free で Voice Design v3 の声を作り、Eleven v4 で自分の日本語の原稿を読ませてみるのが早い確かめ方です。商用で使う段階になったら Starter 以上に切り替え、企業なら学習データのオプトアウトと声の同意の取り方を先に決めておきましょう。
参考・出典:
- ElevenLabs: Introducing Voice Design v3(公式ブログ)
- ElevenLabs: Introducing Eleven v4(公式ブログ)
- ElevenLabs: Eleven v4 公式ページ
- ElevenLabs: モデル一覧(公式ドキュメント)
- ElevenLabs: Voice Design API リファレンス
- ElevenLabs: 料金ページ
- ElevenLabs: API 料金ページ
- ElevenLabs: Default 音声について(公式ヘルプ)
- ElevenLabs: プライバシーポリシー
- ElevenLabs: 日本法人設立のお知らせ
- TechCrunch: ElevenLabs' new v4 speech model supports more expression control and 90 languages
- tech.eu: ElevenLabs doubles valuation to $22bn with $300m employee tender offer
- Yahoo Finance: ElevenLabs lists BlackRock, Jamie Foxx as new investors
- Bloomberg: ElevenLabs Aims to Be IPO-Ready Within Three Years
- IBM Newsroom: ElevenLabs and IBM bring premium voice capabilities to agentic AI
依頼範囲と費用の目安を30分で整理します
この記事の著者

AI革命
編集部
AI革命株式会社の編集部です。最新のAI技術動向から実践的な導入事例まで、企業のデジタル変革に役立つ情報をお届けしています。豊富な経験と専門知識を活かし、読者の皆様にとって価値のあるコンテンツを制作しています。
最新記事
ERNIE 5.5 Flash Baseとは?百度の280Bベースモデルの性能・ライセンス・必要GPU・使い方を解説【2026年11月】
2026/11/05
Character AI 訴訟まとめ 2026|ペンシルベニア州・医師詐称からAI規制の波紋と日本への影響を解説
2026/05/18
Coinbase 14%人員削減(2026年5月5日)|Brian ArmstrongのAIネイティブ組織・5階層化・1人チーム化を整理
2026/05/11
Meta × Assured Robot Intelligence 買収とは?「ロボットのAndroid」戦略とMeta Superintelligence Labs統合を徹底解説
2026/05/02
Apple Intelligenceとは?対応機種・機能一覧・プライバシーの仕組み・設定方法をわかりやすく解説
2026/04/12
GLM-5.1とは?MITライセンス・SWE-Bench Pro 58.4の中国AIモデルと今選ぶべきかを解説
2026/04/17