Mercury 2とは?拡散LLMの料金・速度と後継Mercury 2.5・Claude比較【2026年最新】
この記事のポイント
Mercury 2はInceptionが開発した拡散型LLM(dLLM)で、公式値1,009トークン/秒の高速生成が特徴です。2026年9月に登場した後継Mercury 2.5の料金・260Kコンテキスト・性能差、第三者実測値との乖離、Claude Haiku 4.5やGPT-5.6 Lunaとの比較まで、導入判断に必要な情報を整理します。
Mercury 2は、米Inception(Inception AI, Inc.)が2026年2月に公開した「拡散型大規模言語モデル(dLLM)」で、1トークンずつ順に出力する従来型と違い、出力全体を並列に生成・精製することで公式値1,009トークン/秒という生成速度を出すモデルです。 そして2026年9月8日に後継の Mercury 2.5 が公開され、速度1,107トークン/秒・コンテキスト260K・知能はMercury 2比で約40%向上と、実質的に主力モデルが世代交代しています。
この記事では、Mercury 2および最新のMercury 2.5について、拡散型LLMの仕組み、現行の料金体系(ローンチ割引と通常価格の区別)、公式公表値と第三者独立計測の食い違い、Claude Haiku 4.5・GPT-5.6 Luna・Gemini 3.5 Flash-Liteとの比較ポイント、企業導入時のセキュリティ確認事項までを整理します。
この記事が想定している読者
- AIエージェント・RAG・音声AIのレイテンシがボトルネックになっている開発者
- 大量バッチ処理のLLMコストを下げたいプロダクトチーム
- 「速いモデル」を業務で採用してよいか判断したい技術選定担当者
2026年9月9日時点で押さえておきたいのは、次の5点です。
ポイント | 内容 |
|---|---|
現在の推奨モデル | Mercury 2.5(2026-09-08公開)。Mercury 2は引き続き提供中だが上位互換が出た形 |
速度 | 公式値 Mercury 2.5 = 1,107トークン/秒 / Mercury 2 = 1,009トークン/秒。ただし第三者計測は下振れする |
料金(Mercury 2.5) | 通常 入力$0.20・出力$0.75 / 100万トークン。ローンチ割引中は入力$0.04・出力$0.15(期間限定) |
品質ライン | GPT-5.6 Luna (Low)・Gemini 3.5 Flash-Lite・Claude Haiku 4.5 と同クラス。最上位モデルとは競合しない |
主な制約 | テキスト入力のみ(画像・音声非対応)。公式MCPサーバなし。日本語性能の公式ベンチマークは未公開 |
Mercury 2とは──Inceptionが開発した拡散型の高速LLM
Mercury 2は、拡散(Diffusion)という生成方式を言語モデルに適用した商用LLMで、公式には「世界最速の推論言語モデル」「世界初の推論機能付き商用拡散型LLM」と位置づけられています(いずれもInceptionの自社表現です)。2026年2月24日に発表され、同年3月にはOpenRouterにも inception/mercury-2 として登録されました。
出典:Inception 公式サイト(https://www.inceptionlabs.ai/)
「速いモデル」という一点突破に見えますが、Inceptionが公式ブログで挙げている論拠は明確です。
本番のAIはもはや「1プロンプト・1回答」ではなく、エージェント、検索パイプライン、バックグラウンドの抽出ジョブといったループである。ループではレイテンシは1回では終わらず、全ステップ・全ユーザー・全リトライに複利で効いてくる。
つまり、単発のチャットではなく「1リクエストの裏でLLMを10回・100回叩く設計」において、1コールの速度差がそのまま体験とコストに跳ね返る、という主張です。
開発元:Inception(Inception AI, Inc.)
項目 | 内容 |
|---|---|
社名 | Inception AI, Inc.(Inception Labs) |
CEO | Stefano Ermon(スタンフォード大学教授・拡散モデル研究の第一人者) |
共同創業者 | Aditya Grover(UCLA)、Volodymyr Kuleshov(Cornell) |
チームの研究貢献 | Flash Attention、Decision Transformers、DPO(Direct Preference Optimization)など |
主要投資家 | Menlo Ventures、Mayfield、Microsoft M12 ほか(公式プレスリリース記載) |
提供形態 | Inception公式API(OpenAI互換)/Mercury Chat/Baseten/OpenRouter/エンタープライズ専用デプロイ |
なお、初期に報道された調達額・企業評価額は2025年時点の公表値であり、2026年9月の公式発表では金額の更新が確認できません。数字を鵜呑みにせず、最新の資本情報は公式発表を確認してください。
拡散型LLM(dLLM)とは?自己回帰型との根本的な違い
拡散型LLMは「出力全体を一度に下書きして、数ステップで精製していく」生成方式です。ここを理解すると、Mercury 2の速さがなぜ「チューニングの成果」ではなく「構造の違い」なのかが分かります。
従来型(自己回帰型)の制約
Claude・ChatGPT・Geminiを含む一般的なLLMは自己回帰型(Autoregressive)です。左から右へ1トークンずつ生成し、1トークンごとに1回の順伝播が必要になります。前のトークンが確定しないと次が計算できないため、GPUの並列演算能力を出力方向には使い切れず、生成速度に構造的な上限が生じます。
Mercury(拡散型)の生成プロセス
Inception公式は次のように説明しています。
Mercury 2は逐次デコードをしない。並列的な精製(parallel refinement)によって複数トークンを同時に生成し、少数のステップで収束させる。タイプライターというより、下書き全体を一気に直していく編集者に近い。
処理の流れは概ね次の通りです。
- 出力スパン全体をマスクした状態から開始する
- 各ステップで、出力スパン全体に対してフルコンテキストの順伝播を行う
- マスクを解きながら数ステップで最終テキストへ収束させる
- 結果として、従来型の5倍を超える生成速度が得られる(公式表現では「速度カーブそのものが違う」)
同じ拡散アプローチはGoogleも採用しており、2026年6月に公開された DiffusionGemma は従来比4倍速・H100で毎秒約1,000トークンを謳っています。拡散型LLMはInception1社の特殊技術ではなく、オープンウェイト側も含めた新しい潮流になりつつあります。オープンモデル側の動向はDiffusionGemmaとは|Googleの拡散型テキスト生成AIで整理しています。
実装上の注意:ストリーミングが「ブロック単位」になる
拡散型ゆえの実装差として、Mercuryのストリーミングは1トークンずつではなく「ブロック(精製済みテキストのかたまり)」単位で返ります。トークン単位のタイピング演出を前提にしたUIをそのまま移植すると、体感が変わる点は事前に検証しておくべきです。公式にはデノイジング過程を可視化する「Diffusing」モードも用意されており、生成の様子を確認しながらデバッグできます。
Mercury 2.5で何が変わったか(2026年9月8日公開)
2026年9月8日、InceptionはMercury 2の後継となる Mercury 2.5 を公開しました。速度・コンテキスト・品質・価格のすべてが更新されており、現時点で新規に採用するならMercury 2.5が基本線になります。
項目 | Mercury 2(2026-02) | Mercury 2.5(2026-09) |
|---|---|---|
速度(公式値) | 1,009トークン/秒 | 1,107トークン/秒 |
コンテキスト | 128K | 260K |
最大出力 | 50,000 | 65,536 |
品質 | AIME 2025 91.1 / GPQA 73.6(公表値) | Mercury 2比で知能約40%向上。GPQA Diamond 79% / IFBench 77%(公表値) |
入力単価 | $0.25 / 1M | 通常 $0.20 → 割引時 $0.04 |
出力単価 | $0.75 / 1M | 通常 $0.75 → 割引時 $0.15 |
ツール呼び出し | 対応 | 対応+並列ツール呼び出し |
Inceptionは公式に「市場で最も高性能な拡散型LLM」「我々の知る限りこれまでで最大の拡散型言語モデル」と表現しています。品質の比較対象として挙げているのは GPT-5.6 Luna (Low)・Gemini 3.5 Flash-Lite・Claude Haiku 4.5 で、コスト最適化クラスのフロンティアモデルと同等水準という位置づけです。裏を返せば、Claude Opus 5やGPT-5.6 Solのような最上位モデルとは競合しないことを公式自身が認めています。
同日、プレビュー製品として次の2つも発表されています(いずれもセルフサーブ提供はなく、セールス問い合わせが必要です)。
- Mercury Voice — 音声エージェント特化のdLLM。TTFT(最初のトークンまでの時間)170ミリ秒未満
- Mercury Router — プロンプトをdLLMで解析し、品質・速度・コストのバランスが最適なモデルへ自動ルーティングする
また公式は「すでに次のモデルの学習を開始しており、自社史上最大のモデルを数か月以内にリリース予定」とも述べています。世代交代のサイクルが速い領域である点は、採用時に織り込んでおくべきでしょう。
現行モデルラインナップと使い分け
Mercuryは1モデルではなく4系統(+プレビュー2種)で構成されています。名前が似ているため、選定時は用途で切り分けるのが確実です。
モデル | 用途 | コンテキスト / 最大出力 | ツール呼び出し | 提供状況 |
|---|---|---|---|---|
Mercury 2.5 | 汎用チャット・エージェント・検索/RAG・音声バックエンド | 260K / 65,536 | ○(並列対応) | 一般提供・推奨 |
Mercury 2 | 汎用(旧世代)。既存実装の互換維持用 | 128K / 50,000 | ○ | 一般提供 |
Mercury Edit 2 | IDEの次編集予測・FIM補完 | 32K / 8,192 | × | 一般提供 |
Mercury Voice | 音声エージェント(超低TTFT) | 未公表 | 未公表 | プレビュー(要問い合わせ) |
Mercury Router | モデル自動振り分け | — | — | プレビュー(要問い合わせ) |
選び方の目安
- ほぼすべての新規実装 → Mercury 2.5
- 既存のMercury 2実装があり、挙動を変えたくない → Mercury 2 のまま(ただし価格はMercury 2.5の方が安い)
- エディタのTab補完・次編集予測を作る → Mercury Edit 2(ツール呼び出しと構造化出力に非対応、
v1/edit/completionsはストリーミング非対応)
Mercury Edit 2は前世代比で提案の受容率48%向上・選択性27%向上が公表されており、ZedやProxyAIで利用できます。Zedユーザーは提供APIキーで1か月無料という導線も用意されています。ターミナル型・エディタ統合型のコーディング支援全体を比較したい場合はMeta Muse Codeとは|ターミナル型コーディングエージェントも参考になります。
速度とベンチマーク:公式値と第三者計測は一致しない
Mercuryの速度を評価するときは、公式公表値と第三者の独立計測を必ず分けて見る必要があります。 ここが導入判断で最も誤解が生まれやすいポイントです。
公式公表値(Inception発表)
モデル | 速度 | 備考 |
|---|---|---|
Mercury 2.5 | 1,107トークン/秒 | 広く入手可能なNVIDIA GPU上 |
Mercury 2 | 1,009トークン/秒 | NVIDIA Blackwell GPU |
品質ベンチマークもすべてInceptionの自己申告値です。
ベンチマーク | Mercury 2.5 | Mercury 2 |
|---|---|---|
GPQA / GPQA Diamond | 79% | 73.6 |
IFBench(指示遵守) | 77% | 71.3 |
AIME 2025 | 未公表 | 91.1 |
SciCode | 38% | — |
DeepSearchQA(ツール10回予算) | 34% | — |
第三者独立計測(Artificial Analysis・Mercury 2)
一方、独立計測機関 Artificial Analysis によるMercury 2の計測値は次の通りで、公式値とは無視できない差があります(2026年9月9日時点)。
指標 | Artificial Analysis 計測 | 公式の訴求 |
|---|---|---|
出力速度 | 720.6トークン/秒 | 1,009トークン/秒 |
TTFT | 4.04秒 | サブ300msを訴求 |
Intelligence Index | 12(同価格帯の中央値と同水準〜やや下) | 「速度最適化モデルと競合可能」 |
速度については「全モデルの中央値102.3トークン/秒に対して720.6トークン/秒」と、依然として突出して速い評価です。ただし公式の1,000トークン/秒超は最適条件下の数値であり、実運用では環境・プロンプト長・並列度によって下振れすると考えておくのが安全です。TTFTも公称と実測で開きがあるため、「初回応答の速さ」が要件なら必ず自社条件で計測してください。
なお、Mercury 2.5のIntelligence Indexは2026年9月9日時点で未公表です。「Mercury 2比で10ポイント改善」といった数字が出回っていますが、確定した第三者計測値ではありません。
検索パイプラインでの実測(公式ベンチマーク)
2026年8月に公開された公式ベンチマーク「Mercury 2 for Search」では、同一のエージェントハーネス・同一タスクでLLMコール単位のレイテンシを比較しています。
- クエリプランニング工程で、Gemini 3.1 Flash-Liteの約2倍、Claude Haiku 4.5の4.7倍、GPT-5 Miniの10倍の速度
- 「TTFT 2秒」という予算内で、従来型が「1回のリライト+1回の検索」しかできないところ、Mercury 2なら「4並列リライト+全件へのファンアウト検索+LLMリランク+文書ごとの要約+合成」まで収まる
- 同じパイプラインを速度最適化フロンティアモデルで回すより約2倍安い
計測コードは公開されており(github.com/apoorvumang/retrieval-vs-recall)、再現可能な形で提示されている点は評価できます。RAG構成そのものの設計はRAGとは?仕組みと実装の基本で解説しています。
Mercury 2 / Mercury 2.5の料金・無料枠・レート制限
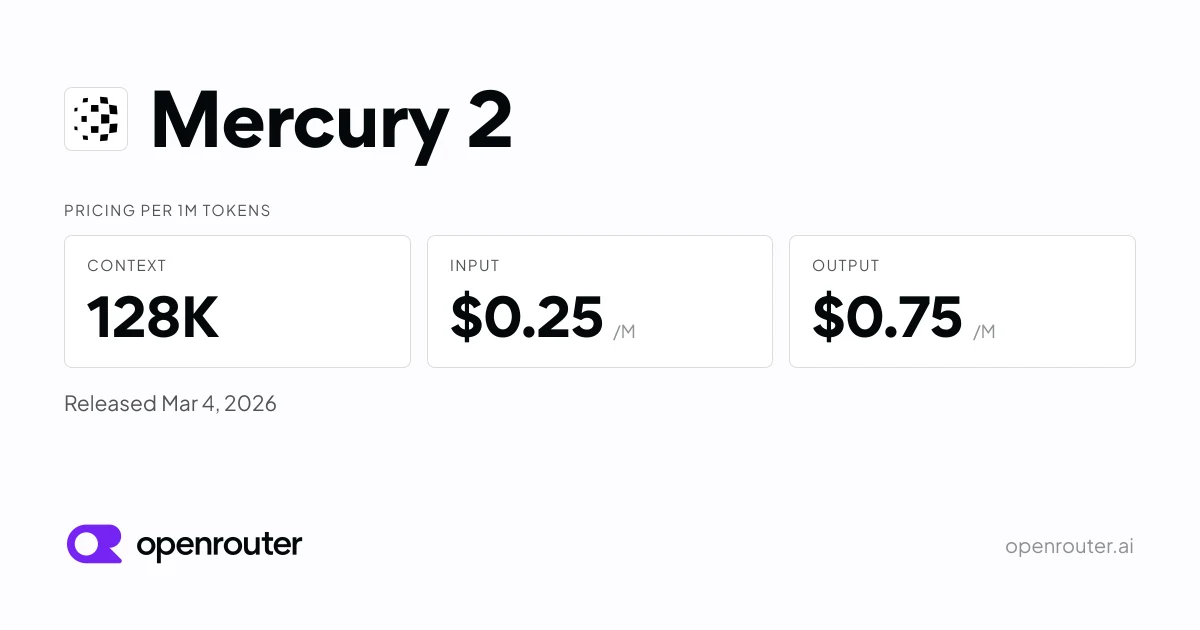
出典:OpenRouter 公式モデルページ(https://openrouter.ai/inception/mercury-2)
現行価格はMercury 2.5がローンチ割引中で、通常価格の80%オフになっています。恒久価格ではない点に注意してください。
モデル別の単価(Inception公式・100万トークンあたり)
モデル | 入力 | キャッシュ入力 | 出力 |
|---|---|---|---|
Mercury 2.5(割引中) | $0.04(通常 $0.20) | $0.004(通常 $0.02) | $0.15(通常 $0.75) |
Mercury 2 | $0.25 | $0.025 | $0.75 |
Mercury Edit 2 | $0.25 | $0.025 | $0.75 |
公式ドキュメント上に「80% off Mercury 2.5!」の表示があり、$0.04 / $0.15 は期間限定のローンチ価格です。終了日は現時点で公表されていません。予算計画は通常価格($0.20 / $0.75)を前提に置き、割引は上振れとして扱うのが安全です。
OpenRouter経由の価格も2026年9月9日時点では公式と同額(Mercury 2.5 = $0.04/$0.15、Mercury 2 = $0.25/$0.75)で、どちらから入っても単価差はありません。
無料枠とレート制限
新規アカウントには一度きりで1億トークン(100M)のクレジットが付与されます。モデル別ではなく全モデル共有です。初版リリース時の1,000万トークンから10倍に拡大しており、検証用途としてはかなり余裕があります。
Free Tier | Pay As You Go | Enterprise | |
|---|---|---|---|
リクエスト/分 | 1,000 | 3,000 | カスタム |
入力トークン/分 | 1,000,000 | 3,000,000 | カスタム |
出力トークン/分 | 100,000 | 300,000 | カスタム |
上限引き上げはサポート問い合わせで対応。429(レート制限)や503(サーバエラー)時は指数バックオフでのリトライが公式に推奨されています。Y Combinator参加企業向けには50万ドル規模のデプロイ特典も案内されています。
コスト試算(Mercury 2.5・通常価格ベース)
想定ワークロード | 月間トークン | 月額(通常価格) | 月額(割引価格) |
|---|---|---|---|
小規模チャット(入力5,000万・出力1,000万) | 6,000万 | 約$17.5(約2,700円) | 約$3.5(約540円) |
RAG検索エージェント(入力5億・出力5,000万) | 5.5億 | 約$137.5(約2.1万円) | 約$27.5(約4,300円) |
大量バッチ抽出(入力20億・出力2億) | 22億 | 約$550(約8.5万円) | 約$110(約1.7万円) |
※1ドル155円換算の概算。実運用ではキャッシュ入力の比率で下がります。
課金の落とし穴:推論トークンも出力レートで課金される
APIレスポンスの usage にはトークン数のみが返り、ドル金額は返りません。計算時に押さえるべき公式仕様は次の3点です。
completion_tokensにはreasoning_tokens(推論トークン)が含まれ、出力レートで課金される。reasoning_effortを上げるとコストが上がるprompt_tokensにはキャッシュ入力(cached_tokens)が含まれる。入れ子の内訳を親と二重計上しない- ストリーミング時は
stream_options.include_usage: trueを指定しないと最終usageチャンクが取れない
トークン換算の目安は英語で1トークン≒4文字です。日本語はこれより多くのトークンを消費するため、日本語主体の用途では試算に余裕を持たせてください。
Mercury 2 / 2.5でできること
対応機能は「テキスト特化・エージェント前提」で整理されています。マルチモーダルを削ぎ落とす代わりに、ツール呼び出しと構造化出力の実用性に振った構成です。
対応している機能
- OpenAI互換API(ベースURL
https://api.inceptionlabs.ai/v1) - ネイティブのツール呼び出し(Mercury 2.5は並列ツール呼び出しに対応)
- スキーマ準拠のJSON構造化出力
reasoning_effortによる4段階の推論制御- ブロック単位のストリーミング/Diffusing(精製過程の可視化)
- 公式SDK:Python(
pip install inceptionai)/TypeScript(npm install inceptionai)
reasoning_effort の使い分け
同じモデルのまま、リクエスト単位で「速度優先」と「精度優先」を切り替えられるのがMercuryの実務上の強みです。
値 | レイテンシ | 向いている処理 |
|---|---|---|
| 最小 | 音声応答、リアルタイムのターン応答、大量の自動処理 |
| 低 | レイテンシに敏感なチャット、単一ツール呼び出し、RAGの回答生成 |
| バランス | 汎用。マルチツールのエージェントループ |
| 最大 | 複雑な多段階推論 |
省略時は medium です。エージェントパイプラインでは「分類・ルーティングは instant、最終回答生成は medium」のように工程ごとに切り替えると、品質を落とさずコストとレイテンシを削れます。推論トークンは出力レートで課金される仕様のため、high を常用すると請求額に直結する点は意識しておくべきです。
公式が用意している統合
種別 | 統合先 |
|---|---|
エディタ/コーディング | Cursor、Zed(Edit Predictions)、Kilo Code、OpenCode、OpenClaw、Hermes Agent |
フレームワーク | LangChain |
音声 | ElevenLabs(Agentsのカスタムモデル)、Vapi |
その他 | Claude Code(サードパーティ製ブリッジ経由・注意事項あり) |
公式クックブックには、検索エージェント(Web Search+引用付き回答の反復合成)、音声カスタマーサポート、リアルタイム音声アシスタント、自然言語SQLエージェント、コーディングエージェントが掲載されています。いずれも「LLMを何度も呼ぶ」構成であり、Mercuryが想定している土俵が明確に分かります。
できないこと・制約(公式確認済み)
採用判断では、できることより制約の把握が重要です。以下はすべて公式ドキュメント・FAQで確認できる内容です。
制約 | 内容 |
|---|---|
画像・ビジョン非対応 | Mercury 2.5 / 2 / Edit 2 はいずれもテキスト入力のみ。画像入力・画像生成は不可 |
マルチモーダル入出力なし | 音声・動画も非対応。Mercury Voiceも「音声エージェント向けの低レイテンシLLM」であり、STT/TTSはElevenLabs等の外部連携が前提 |
公式MCPサーバなし | MCPエンドポイントの公式提供はない。OpenAI互換バックエンドを設定できるクライアントから利用する形になる |
Mercury Edit 2の機能制限 | ツール呼び出し・構造化出力に非対応。コンテキスト32K・最大出力8,192。 |
知能の絶対値 | 公式が比較対象を「コスト最適化フロンティアモデル」と明言。最上位モデルが必要なタスクには向かない |
日本語性能 | 公式ベンチマークが未公開。日本語主体の用途は自前の評価が必須 |
プレビュー製品 | Mercury Voice / Mercury Router はセルフサーブ提供なし。料金も未公表 |
価格の不確実性 | $0.04 / $0.15 はローンチ割引。終了日が未公表 |
提供チャネルについても補足しておきます。2026年9月8日時点の公式ブログが挙げているのは Inception API / Baseten / OpenRouter です。過去に一部で紹介されたAWS BedrockやAzure AI Foundry経由の提供は、現時点の公式ページでは確認できません。クラウドマーケットプレイス経由での調達を前提にする場合は、事前に直接確認してください。
このツールを自社のシステムや業務にどう組み込むか、ご提案します
初回相談は無料・30分(オンライン)。要件が決まっていなくても大丈夫です。改修100万円〜・PoC300万円〜(税別)
他モデルとの比較ポイント
出典:Anthropic 公式サイト(https://www.anthropic.com/claude/haiku)
Mercuryを比較すべき相手は、Claude OpusやGPT-5.6 Solといった最上位モデルではなく、コスト最適化クラスの高速モデルです。公式が挙げる比較対象に揃えて整理します。
項目 | Mercury 2.5 | Claude Haiku 4.5 | GPT-5.6 Luna | Gemini 3.5 Flash-Lite |
|---|---|---|---|---|
生成方式 | 拡散型(dLLM) | 自己回帰型 | 自己回帰型 | 自己回帰型 |
速度(公式値) | 1,107 tok/s | 数十〜百 tok/s台 | 数十〜百 tok/s台 | 数十〜百 tok/s台 |
入力単価 /1M | 通常$0.20(割引$0.04) | $1.00 | $0.20 | $0.30 |
出力単価 /1M | 通常$0.75(割引$0.15) | $5.00 | $1.20 | $2.50 |
コンテキスト | 260K | 200K | 大容量 | 大容量 |
画像入力 | ✕ | ○ | ○ | ○ |
ツール呼び出し | ○(並列) | ○ | ○ | ○ |
OpenAI互換API | ○ | ✕ | ○ | ✕(別API) |
日本語の実績 | 公式ベンチ未公開 | 豊富 | 豊富 | 豊富 |
エコシステム成熟度 | 発展途上 | 成熟 | 成熟 | 成熟 |
※単価は2026年9月9日時点の公開価格。各社とも改定が多いため、採用時は公式料金ページで再確認してください。
読み取り方
- 出力単価の安さは明確な優位点。Mercury 2.5は通常価格でもGemini 3.5 Flash-Liteの約3分の1、Claude Haiku 4.5の約7分の1
- 速度は桁が違う。ただし公式値ベースであり、実測は下振れする前提で見る
- 弱点は画像非対応と日本語の不確実性。ここが要件に入るなら他モデルが無難
GPT-5.6 Lunaの料金改定内容はGPT-5.6 Lunaの80%値下げとAPI料金改定の全内容、Gemini側の高速モデル群はGemini 3.6 Flashとは|料金・性能・比較とGemini 3.1 Flash-Liteとは|料金・2.5倍速・Claude比較でそれぞれ整理しています。Claude側の料金体系はClaude料金の詳細解説を参照してください。
使い分けの基準
状況 | 推奨 |
|---|---|
1リクエストで10回以上LLMを呼ぶエージェント/検索パイプライン | Mercury 2.5 |
音声エージェントのターン応答 | Mercury 2.5( |
数十万件規模の分類・抽出・要約バッチ | Mercury 2.5 |
IDEのTab補完・次編集予測 | Mercury Edit 2 |
画像を読ませる必要がある | Claude / GPT / Gemini |
日本語の最終出力品質が売り物になる | Claude / GPT / Gemini |
難易度の高い単発推論・長時間の自律作業 | Claude Opus 5 / GPT-5.6 Sol クラス |
現実的には「パイプラインの内部処理はMercury、ユーザーに見える最終出力は上位モデル」というハイブリッド構成が最も費用対効果が高くなります。
実運用での効果(公式掲載の導入事例)
公式ブログには、定量的な効果を伴う導入事例が複数掲載されています。速度が「体感」ではなく指標として効いていることが分かる部分です。
企業 | 用途 | 公表されている効果 |
|---|---|---|
OpenCall | AI電話エージェント | P99応答時間が数分→1秒、P50が0.4秒→0.2秒未満。本番ワークロードで中央値レイテンシ約170ms |
Augment Code | コンテキスト圧縮・モデルルーティング・ツール検索 | 圧縮レイテンシ82%削減(約150秒→27秒)、コスト90%削減(品質維持) |
Zed | 次編集予測 | 「待つものではなく、自分の思考の一部のように感じる速さ」(共同創業者コメント) |
Skyvern | ブラウザ自動化 | 「GPT-5.2の少なくとも2倍速い」 |
Wispr Flow | リアルタイム文字起こしの整形 | 「Mercuryほどの速度に近づいたモデルは他にない」 |
Inceptionによれば、Mercury 2のリリース以降で数千人の開発者が構築し、数十社のエンタープライズが本番投入、利用量は1桁以上増加したとされています。ただしこれらはすべてベンダー側が選定して掲載した事例である点は差し引いて読む必要があります。
セキュリティ・データ取り扱いの確認事項
業務データを流す前に、少なくとも次の4点は自社の基準と照らし合わせてください。 公開情報だけでは判断できない部分が残るため、要件が厳しい組織はエンタープライズ窓口での確認が前提になります。
1. 入力データが学習に使われる可能性
Inceptionのプライバシーポリシーには、データ利用目的として「モデルの訓練・改善(training and refining our models)」が明記されています。標準プランでは入力データが学習に使われうる前提で扱うのが安全です。機密情報・個人情報を含むデータを流す場合は、エンタープライズ契約でのデータ取り扱い条件を確認してください。
2. データ保持・ZDRの扱い
プライバシーポリシー上、保持期間は「サービス提供・事業目的に必要な限り」という一般的な記述にとどまり、具体的な日数の明記はありません。ZDR(Zero Data Retention)の明示的な記載も公開ポリシー上には見当たりません。 公式ブログにはエンタープライズ向けとして「専有キャパシティ、オートスケーリング、コンプライアンス統制、設定可能なデータ保持(configurable data retention)」の記載があり、個別条件は交渉ベースと読めます。
3. 認証・保管地の情報が公開されていない
SOC 2 / ISO 27001 / GDPR対応の取得状況、およびデータ処理・保管の地理的所在地は、2026年9月9日時点の公開情報では確認できません。「取得済み」と書かれた記事を見かけても、自社の監査要件に使う場合は必ず一次情報での確認が必要です。問い合わせ先は legal@inceptionlabs.ai です。
4. Claude Code連携は公式が注意喚起している非公式ルート
Inceptionの公式ドキュメントには、Claude Code統合について次の警告が掲載されています。
この統合は、Claude CodeのAnthropic Messages APIとInceptionのOpenAI互換APIを橋渡しするサードパーティ製LiteLLMを使用する。AnthropicはClaude Codeを非Claudeモデルへルーティングすることをサポートしていない。 機微なコードや認証情報で使用する前に、LiteLLMを検証すること。
つまり「Claude CodeでMercuryを動かす」構成は、ベンダー双方のサポート外にある経路です。個人の実験なら選択肢になりますが、業務コードや本番の認証情報を通す用途では推奨できません。APIキーは公式手順どおりユーザー限定ファイル(chmod 600)で管理し、リポジトリやフロントエンドに含めないでください。エージェント全般のセキュリティ設計はAIエージェントのセキュリティ対策、コーディングエージェントの挙動監視はPerplexity Numbatとは|AIコーディングエージェント監視OSSで扱っています。
始め方(Inception API・OpenRouter・エディタ連携)
出典:Baseten 公式サイト(https://www.baseten.co/)
導入経路は主に3つで、いずれも数分で試せます。
経路 | 手順 | 向いているケース |
|---|---|---|
Inception公式API | platform.inceptionlabs.ai でアカウント作成→APIキー発行→1億トークンの無料枠で検証 | 本格導入・最新モデルを最速で使いたい |
OpenRouter | OpenRouter登録後 | 複数LLMを統一エンドポイントで管理したい |
エディタ/エージェント | Cursor・Zed・OpenClaw等のカスタムモデル設定でOpenAI互換エンドポイントを指定 | 手元の開発環境で試したい |
OpenAI互換のため、既存コードからの移行は3か所の変更で済みます。
from openai import OpenAI

client = OpenAI(
    base_url="https://api.inceptionlabs.ai/v1",   # 1. ベースURL
    api_key=os.environ["INCEPTION_API_KEY"],       # 2. APIキー(環境変数で管理)
)

response = client.chat.completions.create(
    model="mercury-2.5",                           # 3. モデル名
    messages=[{"role": "user", "content": "..."}],
    extra_body={"reasoning_effort": "low"},        # instant / low / medium / high
    stream_options={"include_usage": True},        # ストリーミング時のusage取得
)
Mercury 2からMercury 2.5への切り替えは、原則としてモデル名の変更だけで済みます。ただしコンテキスト上限(128K→260K)と最大出力(50,000→65,536)が変わるため、トークン上限をハードコードしている箇所は見直してください。
こんな人におすすめ/おすすめしない人
おすすめできるケース
- エージェントや検索パイプラインのレイテンシが積み上がっている開発者 — 1リクエストあたりのLLM呼び出し回数が多いほど、Mercuryの速度差が効きます
- 音声AI・リアルタイムUIを作っているチーム — ターン応答の待ち時間がプロダクト価値を左右する領域
- 大量バッチの分類・抽出・要約を回している企業 — 出力単価の安さがそのまま月額に反映されます
- 既にOpenAI SDKで実装しているチーム — 3か所の変更で試せるため、検証コストが極めて低い
- 拡散型LLMを実務で評価しておきたいエンジニア — 1億トークンの無料枠で十分な検証ができます
おすすめしないケース
- 日本語の最終出力品質が成果物そのものになる用途 — 公式ベンチマークが未公開で、リスクを負う理由がありません
- 画像や音声を直接読ませたい用途 — テキスト入力のみのため選択肢に入りません
- 難易度の高い単発推論・長時間の自律実行が中心 — 公式自身が比較対象を軽量クラスに置いています
- SOC 2 / ISO 27001 / ZDRの証跡が調達要件になっている組織 — 公開情報で確認できず、個別交渉が前提になります
- 価格を長期で固定したい場合 — 現在の $0.04 / $0.15 はローンチ割引で、終了日が未公表です
Mercuryシリーズのリリース経過(公式ブログ基準)
日付 | 内容 |
|---|---|
2026-02-24 | Mercury 2 発表(1,009 tok/s、128K、$0.25/$0.75) |
2026-03-04 | OpenRouterに |
2026-07-29 | スループット改善・利用者拡大を公式ブログで報告 |
2026-08-11 | 「Mercury 2 for Search」公開。検索パイプラインでのレイテンシ実測を提示 |
2026-09-08 | Mercury 2.5 正式リリース(1,107 tok/s、260K、知能+40%、通常$0.20/$0.75・ローンチ80%OFF)/Mercury Edit 2/Mercury Voice・Mercury Router(プレビュー)発表 |
今後 | 「自社史上最大のモデル」を数か月以内にリリース予定と公式が表明 |
よくある質問(FAQ)
Q. 今から使うならMercury 2とMercury 2.5のどちらを選ぶべきですか?
A. 新規実装ならMercury 2.5です。速度・コンテキスト・品質のすべてで上回り、通常価格でも入力単価はMercury 2より安く設定されています。Mercury 2を使い続ける合理性は、既存実装の挙動を凍結したい場合に限られます。
Q. $0.04 / $0.15 という単価は今後も続きますか?
A. 続く保証はありません。公式ドキュメントに「80% off」と明示されたローンチ割引で、終了日は公表されていません。予算計画は通常価格の入力$0.20・出力$0.75で組み、割引期間は上振れとして扱ってください。
Q. 公式の「1,107トークン/秒」はそのまま出ますか?
A. 最適条件下の値と考えるべきです。Artificial AnalysisによるMercury 2の独立計測は720.6トークン/秒、TTFTは4.04秒でした。それでも一般的なモデルの中央値(約100トークン/秒)と比べれば桁違いに速いのは事実ですが、自社のプロンプト長・並列度で必ず計測してください。
Q. 画像を読ませられますか?
A. できません。公式FAQで「Mercury 2.5、Mercury 2、Mercury Edit 2 はテキスト入力のみ。画像生成・画像入力は非対応」と明記されています。
Q. 日本語は使えますか?
A. 日本語の入出力自体は可能ですが、日本語性能に関する公式ベンチマークは公開されていません。日本語が主用途なら、自社データでClaudeやGPTと比較評価してから採用を判断してください。また日本語は英語よりトークン消費が多くなるため、コスト試算にも余裕が必要です。
Q. MCPサーバは提供されていますか?
A. 公式のMCPサーバ・MCPエンドポイントの提供はありません。ただしOpenAI互換のツール呼び出しに対応しているため、OpenAI互換バックエンドを設定できるMCPクライアントやエージェントフレームワークからは利用できます。
Q. 無料でどこまで試せますか?
A. 新規アカウントに一度きりで1億トークンのクレジットが付与されます。全モデル共有で、Free Tierのレート上限は1,000リクエスト/分・入力100万トークン/分・出力10万トークン/分です。パイロット検証には十分な規模といえます。
まとめ
Mercury 2は「拡散型で生成方式そのものを変えることで、従来型のスループット上限を突破した」LLMであり、2026年9月にはコンテキスト260K・知能約40%向上・出力単価$0.15(割引時)のMercury 2.5へ世代交代しました。
採用可否は、次の5点で判断できます。
- 採用が刺さるのは「LLMを何度も呼ぶ設計」。エージェントループ、検索/RAG、音声のターン応答、大量バッチ。ここでは速度差と単価差が複利で効く
- 採用を見送るべきは「1回の出力品質が成果物」の用途。画像入力、日本語の最終品質、最上位クラスの推論が要件なら他モデルが妥当
- 数字は公式値と第三者計測を分けて見る。1,000トークン/秒超は最適条件下の値で、実測は環境依存で下振れする
- 価格は割引前提で計画しない。通常価格 $0.20 / $0.75 を基準に置く
- 企業導入では学習利用・保持期間・認証の3点を必ず一次情報で確認する
同じ拡散型のオープンモデル動向はDiffusionGemmaとは|Googleの拡散型テキスト生成AI、比較対象となる軽量高速モデルの料金はGPT-5.6 Lunaの80%値下げとAPI料金改定の全内容とGemini 3.6 Flashとは|料金・性能・比較で確認できます。生成AIツール全体の選び方は生成AIツールおすすめ比較、Claudeの機能・料金はClaudeとは?機能・料金・使い方をChatGPTと徹底比較をあわせて参照してください。
このツールを自社のシステムや業務にどう組み込むか、ご提案します
この記事の著者

AI革命
編集部
AI革命株式会社の編集部です。最新のAI技術動向から実践的な導入事例まで、企業のデジタル変革に役立つ情報をお届けしています。豊富な経験と専門知識を活かし、読者の皆様にとって価値のあるコンテンツを制作しています。
最新記事
Prime Intellect Labとは?自己改善エージェントの訓練基盤を解説|Hosted RLの料金・使い方とLoRA廃止後の変更点【2026年10月】
2026/05/28
中国のAI輸出規制案とは?モデルの重み・23技術の中身と日本企業への影響【2026年10月草案】
2026/10/16
MAI-DxOとは?MicrosoftのAI診断がScience誌で正答率83%|仕組み・医師との比較・限界を解説【2026年10月】
2026/10/23
OpenAI Decisions APIとは|GPT-6 Lunaで分類・ルーティングを即時判定・Jevとの違い・料金と使いどころ【2026年10月】
2026/10/01
顧客ポータル(顧客用マイページ)を開発したい|契約情報・書類・問い合わせをまとめる設計
2026/10/10
ChatGPT Futures Class of 2026とは?OpenAI初の学生AI表彰・26組・1万ドル助成・全受賞プロジェクト事例解説
2026/05/26